
截至 2026 年 8 月 7 日,DeepSeek‑V4‑Flash‑0731 的正式开放权重仍采用约 284B 总参数、13B 激活参数、FP4/FP8 混合精度和 1M token 上下文;官方原始权重下载体积约 160–167GB,因此“总内存够大”只是最低门槛,真正决定可用性的还包括量化格式、KV cache 压缩、MoE 专家调度、卡间互联和专用内核。
在 整套硬件含税/渠道落地不超过 100,000 元 的严格条件下,本报告的结论是:
| 综合位置 | 方案 | 预计落地价 | 1M 上下文状态 | 核心判断 |
|---|---|---|---|---|
| 第一名 | 2× DGX Spark | 7.8–9.2 万元 | 已由社区在 0731 上验证 | 当前唯一同时满足预算、1M、较高并发、完整 CUDA/vLLM 路线的方案 |
| 第二名 | 1× DGX Spark | 3.8–4.6 万元 | 已验证单会话 1M | 最低风险入门方案;吞吐明显低于双机,但成本、功耗和维护最好 |
| 第三名 | R9700 + Strix Halo 异构机 | 5.0–6.5 万元 | 理论可能,公开 1M 实测不足 | 中短上下文单流很快,51.1 tok/s 实测突出,但依赖定制 ROCm 引擎 |
| 第四名 | RTX PRO 6000 Blackwell 单卡 | 9.0–11 万元 | 未完成可靠公开验证 | 通用 CUDA 能力强,但 96GB 无法容纳原始权重,只能依靠激进量化 |
| 第五名 | 二手 H100 单卡 + 主机内存卸载 | 6.0–8.5 万元 | 不建议 | HBM 很快,但 80GB 容量过小,CPU offload 会破坏 H100 的性能优势 |
2× DGX Spark 是本次唯一明确的“十万元内、正式 0731、完整 1M、可做多用户 API”的首选。 当前社区 TP=2、DSpark、NVFP4 KV 路线在 1M 配置下报告了约 55 tok/s 典型单流、66 tok/s 峰值;针对短至中等活跃上下文的持续批处理,双 Spark 的公开测试曾达到约 253 tok/s@8 并发、315 tok/s@16 并发,优化版本在较低并发也出现过约 340 tok/s aggregate。由于这些测试使用的软件补丁、上下文长度和请求到达模式不同,不应把 340 tok/s 理解为“32 个各自装满 1M 上下文的会话”。
R9700 + Strix Halo 是最有潜力的追赶者,但不是当前最稳的生产选择。 Lucebox 使用 32GB R9700 承担密集层、热点专家和 DSpark draft,128GB Strix Halo 存放其余专家,短上下文单流达到 51.1 tok/s;但公开测试主要覆盖 2K–16K,上下文扩展到 1M 时,KV 所在设备、PCIe 往返、连续批处理和 ROCm 内核稳定性仍缺少公开验证。
H100、H200、H20、Atlas 300I A2 的问题不是芯片本身弱,而是十万元预算无法同时买到足够的高速显存和正确的多卡互联。单张 H100/H20/RTX PRO 6000 都放不下原始模型;双 H100 通常整机超预算;单 H200 当前国内参考价约 28.2 万元;八张 Atlas 300I A2 即使按非常乐观的非公开渠道价计算,也远超十万元,并且 300I A2 PCIe 拼装没有 Atlas 800 A2 的 HCCS 全互联和官方 V4 部署路径。
方法论、假设与限制
评估口径
本报告将“能部署”分为四个层级:
| 等级 | 含义 |
|---|---|
| 已验证 | 有 DeepSeek‑V4‑Flash‑0731 对应公开运行记录,并验证 1M 或接近 1M |
| 社区支持 | 有 V4 Flash 或 0731 实测,但尚未验证完整 1M、持续批处理或正式生产稳定性 |
| 框架兼容 | 硬件理论上由 vLLM、SGLang、ROCm 或 CANN 支持,但没有目标模型完整公开 benchmark |
| 理论拼装 | 仅根据显存、带宽和算力推导,没有可复现的目标模型部署记录 |
吞吐表中的 8/16/32 并发指服务器被配置为允许 max_model_len=1,048,576,但每个活跃请求的典型实时上下文为约 8K–32K,而不是每个请求都已经占满 1M token。完整的 1M 深度并发由单独的“1M 满深度会话数”表示。若同时维持 8 个完整 1M 会话,仅 KV cache 就可能需要约 40–77GiB;32 个完整 1M 会话则可能需要约 154–308GiB,远超绝大多数十万元级方案的权重加载后余量。vLLM 对 V4 的公开分析给出约 9.62GiB/条 1M BF16 KV,FP8/低精度缓存可约减半;实际双 Spark NVFP4 路线测得的有效占用约为每条 1M 需要 7–8GiB,说明运行时元数据、对齐和实现差异不可忽略。
价格和成本假设
价格采用截至 2026 年 8 月上旬的官方 MSRP、公开渠道行情与二手市场报价,并做以下统一假设:
| 参数 | 本报告假设 |
|---|---|
| 美元折算 | 7.2 RMB/USD,仅作渠道估算 |
| DGX Spark 中国落地 | 官方 $4,699 基础上计入渠道、税费和供货差异 |
| 折旧 | 5 年直线折旧,无残值,共 43,800 小时 |
| 电价 | 0.8 RMB/kWh |
| 有效利用率 | 60%,即全年平均只有 60% 时间按表中吞吐输出 token |
| 功耗 | 使用整机墙上功耗,而非单纯 GPU TDP |
| 单位 token 成本 | 仅计算生成/解码 token,不含人工、机房、网络、维修和停机 |
| 存储 | 默认已有足够 NVMe;大型模型缓存可能额外需要 2–4TB SSD |
| 服务质量 | 不将 Q2、FP4、FP8、原始权重视为完全等价,质量差异未折算成金额 |
DGX Spark 官方 MSRP 已在 2026 年 2 月由 3,999 美元上调至 4,699 美元;国内公开报道将涨价后价格描述为接近 4 万元,因此本报告采用单台 3.8–4.6 万元、双台连线后 7.8–9.2 万元。
二手 H100 的低价可能来自海外拆机、无保修板卡、工程样品或仅 GPU 模组,不等同于可直接装入普通 PCIe 服务器的零售卡。本报告采用单卡约 4.2–5.5 万元、完整单卡主机 6–8.5 万元的乐观估算;双卡完整主机通常超过 10 万元。H200 国内近期公开平台参考价约 28.2 万元/张,因此不属于本报告预算内候选。
Atlas 300I A2 的公开价格信息差异特别大:部分非正式渠道声称 3–4 万元,而中关村在线 2026 年 4 月展示的市场参考价为 129,800 元且实际“价格面议”。因此对该卡只能使用宽区间,不能把低价自媒体报价当成可交付的采购合同。
Benchmark 限制
不同测试在量化、draft 模型、提示长度、输出长度、CUDA graph、连续批处理、prefix cache 和采样设置上并不一致。双 RTX PRO 6000 的 210 tok/s 单流与约 700 tok/s 多流结果使用原始权重、262K 上下文和特定 Blackwell vLLM 分支;Lucebox 的 51.1 tok/s 使用 102.3GB ROCmFPX 权重、四专家路由和约 2K 提示;单 Spark 的 59 tok/s 是十二个并发请求的 aggregate,而不是单请求速度。它们只能用于工程量级判断,不能视为严格同条件横评。
候选硬件与关键规格
预算内及预算边缘方案
| 方案 | 显存或统一内存 | 本地内存带宽 | 卡间或节点互联 | FP16 / INT8 理论值 | 估算整机功耗 | 含税/渠道成本 | 权重加载后 KV 可用空间 | 0731 支持状态 |
|---|---|---|---|---|---|---|---|---|
| 1× DGX Spark | 128GB LPDDR5X 统一内存 | 273GB/s | 单机;ConnectX‑7 200Gbps 可扩展 | 官方主要披露 1PFLOP FP4;FP16/INT8 未给统一可比值 | 170–210W;GB10 TDP 140W | 3.8–4.6 万 | 约 8–12GiB,取决于 Q2 包、draft 和系统占用 | 社区验证 0731;单会话 1M |
| 2× DGX Spark | 2×128GB,共 256GB;非完全共享 UMA | 2×273GB/s | ConnectX‑7 200Gbps,约 25GB/s 线速 | 2×1PFLOP FP4;不等于 2PFLOP 可线性利用 | 340–420W | 7.8–9.2 万 | 社区 vLLM 配置测得约 18GiB KV 池 | 社区验证 0731、TP2、1M |
| R9700 + Strix Halo | 32GB GDDR6 + 128GB LPDDR5X;分离内存池 | 640GB/s + 理论约 256GB/s | 受 Strix Halo PCIe 4.0 主机路径限制,理论约 32GB/s 单向 | R9700 约 191TFLOPS FP16,加 Halo 约 60TFLOPS;不可简单相加 | 450–550W | 5.0–6.5 万 | 总剩余约 30–45GB,但快速侧 KV 余量可能仅 8–12GB | V4 Flash 社区验证;0731/1M 尚不充分 |
| RTX PRO 6000 Blackwell ×1 | 96GB GDDR7 ECC | 1,792GB/s | 单卡;无 NVLink | NVIDIA 披露 4,000 AI TOPS;未给完全同口径 INT8/FP16表 | 700–800W 整机;卡 600W | 9.0–11 万;低于十万通常要求二手或已有主机 | Q2 权重后约 3–8GB,原始权重无法装入 | CUDA/vLLM 社区支持;单卡 1M 未验证 |
| 二手 H100 80GB ×1 | 80GB HBM3 | 约 3.0–3.35TB/s | PCIe 5.0;普通 PCIe 卡无 HGX NVSwitch | 约 1.5–2.0PFLOPS FP16、3.0–4.0POPS INT8,通常含稀疏口径 | 500–650W | 6.0–8.5 万 | 原始和常见 Q2 包均几乎无 GPU KV 余量,必须 CPU offload | 框架兼容;不适合本模型完整本地部署 |
| Atlas 300I A2 64GB ×1 | 64GB HBM | 1.6TB/s | PCIe 5.0 | 280TFLOPS FP16;560TOPS INT8 | 500–600W 整机;卡 350W | 6–15 万完整主机,价格高度不确定 | 无法单卡容纳模型 | 无 300I A2 官方 V4‑0731 路线 |
DGX Spark 官方规格为 128GB LPDDR5X、273GB/s、ConnectX‑7 200Gbps 和 140W GB10 TDP;官方还确认双节点可把可用总内存从 128GB 扩展至 256GB。
R9700 官方规格为 32GB GDDR6、640GB/s、300W;Strix Halo 平台支持 128GB LPDDR5X,AMD 通常允许其中约 96–112GB 配置给 GPU。由于二者是分离内存池,不能像单一 160GB HBM 一样随意分配,Lucebox 必须通过不对称专家并行主动决定哪些专家位于哪一侧。
RTX PRO 6000 Blackwell 工作站版拥有 96GB GDDR7 ECC、1,792GB/s 带宽和 600W 最大板卡功耗;2026 年 8 月美国官方/渠道价格已约 11,360–13,250 美元,意味着完整新机在中国市场通常超过十万元。
H100 的高带宽不能解决容量问题。NVIDIA H100 SXM 为 80GB、3.35TB/s,H100 NVL 为 94GB、3.9TB/s;两者分别可提供最高 900GB/s 和 600GB/s NVLink,但低价二手 H100 PCIe 通常不能等同于完整 NVL/HGX 互联系统。
华为 Atlas 300I A2 64GB 的官方规格为 1.6TB/s、280TFLOPS FP16、560TOPS INT8 和 350W。其单卡规格很强,但 vLLM‑Ascend 的 DeepSeek‑V4‑Flash 官方指南针对的是 Atlas 800 A2 8×64GB 和 Atlas 800 A3 8×128GB,并未把八张独立 300I A2 PCIe 卡列为等价拓扑。
超预算或条件性方案
| 方案 | 总显存 | 聚合内存带宽 | 互联假设 | 估算整机功耗 | 估算完整成本 | 模型适配结论 |
|---|---|---|---|---|---|---|
| 二手 H100 ×2 | 160GB;若 H100 NVL 则 188GB | 约 6–7.8TB/s | 普通 PCIe P2P 或昂贵的 600GB/s NVLink NVL | 0.9–1.2kW | 10.5–14 万 | 原始权重几乎占满 160GB;量化后更实用,但一般超预算 |
| H200 ×1 | 141GB HBM3e | 4.8TB/s | 单卡 | 0.65–0.85kW | 约 25–30 万 | 仍放不下约 160–167GB 原始权重;量化后可留较大 KV |
| H200 ×2 | 282GB | 9.6TB/s | NVLink/HGX 取决于系统 | 1.3–1.6kW | 约 50–60 万 | 技术上很强,但与十万元目标无关 |
| H20 ×1 | 96GB HBM3 | 4.0TB/s | HGX 版本最高约 900GB/s NVLink | 0.5–0.7kW | 约 9–12 万 | 单卡放不下原始权重,量化后 KV 余量小 |
| H20 ×2 | 192GB | 8.0TB/s | 需要正确 HGX/NVLink 底板 | 0.9–1.2kW | 约 18–23 万 | 有容量,但当前公开 vLLM 0731 报告曾受限于约 121K context |
| H100 + H20 异构 | 176GB | 名义约 7TB/s | 异构 TP/EP,无成熟官方拓扑 | 1.0–1.3kW | 约 16–21 万 | 驱动、kernel、负载均衡和显存分片复杂,不推荐 |
| Atlas 300I A2 64GB ×8 | 512GB HBM | 名义 12.8TB/s | 8 张 PCIe 卡,经 CPU/PCIe switch;无 Atlas 800 HCCS | 3.0–3.8kW | 乐观 32–45 万;公开价可超过百万 | 容量足够,但跨卡 MoE 通信和软件支持不确定 |
| RTX PRO 6000 ×2 | 192GB | 3.584TB/s | PCIe 5.0 主机桥,无 NVLink | 1.1–1.4kW | 约 18–23 万 | 已有约 210 tok/s 单流、约 700 tok/s@10 的公开 V4 测试,但超预算 |
H200 官方规格为 141GB HBM3e 和 4.8TB/s;国内公开平台 2026 年 7 月参考价格约 282,000 元,因此“二手单 H200 十万元以内”不应作为正常采购假设。
H20 公开规格通常为 96GB HBM3、约 4TB/s、400W 和较低的 Hopper 算力。它的优势是带宽和中国市场生态,而不是单卡容量;公开的双 H20 0731 部署记录还曾出现实际 KV 字节数高于预期、最大上下文仅约 121K 的问题,因此不能根据 192GB 总 HBM 直接断言可以稳定运行 1M。
双 RTX PRO 6000 的公开 benchmark 说明 RTX Blackwell 路线具有很高潜力:原始约 160GB 权重在 2×96GB 上实现约 210 tok/s 单流、约 700 tok/s@10,并使用 FP8 KV 支持 262K;但两张卡本身已明显超过十万元,而且无 NVLink,依赖特定 sm_120a 内核和 PCIe 感知的 NCCL 调优。
上下文、并发与吞吐估算
一百万上下文容量
| 方案 | 1M 理论 KV 余量 | 理论 1M 满深度会话数 | 公开验证结果 | 结论 |
|---|---|---|---|---|
| 2× DGX Spark | 约 18GiB 实际 KV 池 | 约 2.38 条 | 1M 已验证,曾推到 1.5M;0731 典型单流约 55 tok/s | 可用 |
| 1× DGX Spark | 估算 8–12GiB | 1 条 | 单会话 1M、裸服务测试至 1.2M;跨会话共约 766K live tokens | 可用但并发受限 |
| R9700 + Strix Halo | 名义剩余较多,但快速侧工作区受 32GB R9700 限制 | 理论 1–2,未验证 | 公开测试只到 16K | 实验性 |
| RTX PRO 6000 ×1 | Q2 后约 3–8GiB | 0–1 | 无可靠单卡 1M 记录 | 不建议以 1M 为采购目标 |
| H100 ×1 | GPU 侧接近 0;依赖主机内存 | 0 | 无完整本地 1M | 不适合 |
| H100 ×2 | 量化后约 50–70GiB;原始权重后接近 0 | 理论 5–9 | 缺少 0731/1M 同条件实测 | 有条件可行,但超预算 |
| H200 ×1 | 量化后约 35–50GiB | 理论 4–6 | 未见目标配置公开验证 | 理论可行、经济性差 |
| H200 ×2 | 原始权重后约 90–110GiB | 理论 10–14 | 大型 Hopper 路线合理但无十万元意义 | 可行、严重超预算 |
| H20 ×1 | 约 3–8GiB | 0–1 | 未验证 | 不推荐 |
| H20 ×2 | 量化后约 60–80GiB | 理论 6–10 | 当前公开软件路径曾仅到约 121K | 容量够,软件尚未兑现 |
| H100 + H20 | 理论约 50–65GiB | 理论 5–8 | 无成熟异构 TP/EP 路线 | 不推荐 |
| 300I A2 ×1 | 不能加载模型 | 0 | 无 | 不可行 |
| 300I A2 ×8 | 估算 100–160GiB | 理论 13–20 | 无 300I 0731 公开验证 | 仅理论拼装 |
单 Spark 的当前社区实现报告了 517,963 token 在 667 秒完成 prefill、约 28 tok/s 的 12K 对话解码、约 22 tok/s 的 240K 解码、十二并发合计 59 tok/s,并明确测试了单会话 1M 和裸服务 1.2M。
双 Spark 的 0731 路线使用 TP=2、DSpark 和实验性 NVFP4 KV;修复 DSpark 权重加载后,1M 配置的平均单流从约 32.7 tok/s 提升到约 55.4 tok/s,峰值约 66.1 tok/s。该提升依赖社区补丁,未打补丁时吞吐可能接近减半。
多并发 aggregate tokens/s
下表给出的是工程估算区间。双/单 Spark 以公开实测为锚点;其他方案主要依据单流测试、带宽、权重放置和类似硬件扩展效率外推。带 † 的数字不代表存在相同条件下的公开 benchmark。
| 方案 | 8 并发 aggregate tok/s | 16 并发 aggregate tok/s | 32 并发 aggregate tok/s | 估算可信度 |
|---|---|---|---|---|
| 2× DGX Spark | 240–280 | 290–330 | 315–350 | 中高;有 C8/C16 和持续批处理数据 |
| 1× DGX Spark | 45–55 | 55–62 | 58–65 | 中高;十二并发实测 59 |
| R9700 + Strix Halo | 90–130† | 110–150† | 115–160† | 低;只有单流、短上下文数据 |
| RTX PRO 6000 ×1,Q2/FP4 | 80–140† | 120–180† | 140–200† | 低;由双卡结果和容量约束外推 |
| H100 ×1 + CPU offload | 25–45† | 30–60† | 35–70† | 很低;受 PCIe/CPU 内存拖累 |
| H100 ×2,量化 | 110–190† | 150–240† | 180–290† | 低;超预算且没有 0731 同条件数据 |
| H200 ×1,量化 | 90–160† | 130–220† | 160–270† | 低 |
| H200 ×2 | 280–450† | 400–650† | 500–800† | 低;仅容量与 Hopper 性能外推 |
| H20 ×1,量化/offload | 25–50† | 35–65† | 40–75† | 很低 |
| H20 ×2 | 80–150† | 120–220† | 140–270† | 很低;且当前 1M 尚未实现 |
| H100 + H20 | 70–140† | 100–190† | 120–230† | 很低;异构调度未验证 |
| 300I A2 ×1 | 不可加载 | 不可加载 | 不可加载 | 高 |
| 300I A2 ×8 PCIe 假设 | 120–250† | 200–350† | 250–450† | 极低;无目标软件路线 |
双 Spark 在不同软件版本中存在较大离散:较早的完整 1M 配置报告过约 67 tok/s 单流和约 182 tok/s 六并发;200K profile 报告过约 253 tok/s@8 和 315 tok/s@16;更新的 CUDA graph/连续批处理配置在六并发附近报告过约 340 tok/s。报告中的区间采取保守折中,而不是选择最高数字。
Lucebox 的 51.1 tok/s 是约 2K 输入、128 token 输出的单流中位数;上下文由 2K 增长到 16K 时,速度从约 51.0 降至 42.9 tok/s。当前没有公开的 8/16/32 连续批处理数据,因此表中多并发值只是一种“软件能够实现较好 batching”条件下的潜力估算。
图中的 DGX Spark 曲线由公开实测锚定;R9700+Strix Halo、单 RTX PRO 6000 和单 H100 曲线为本报告的工程外推,不应作为厂商承诺或采购验收指标。
成本、功耗与单位 token 经济性
计算模型
本报告使用:
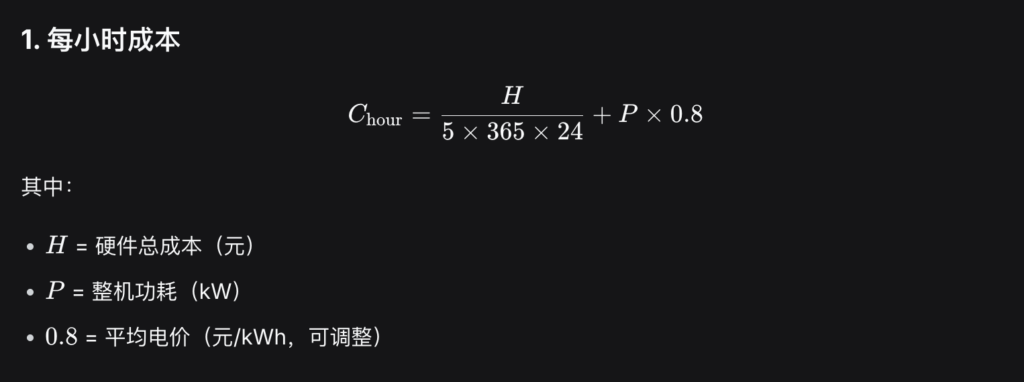
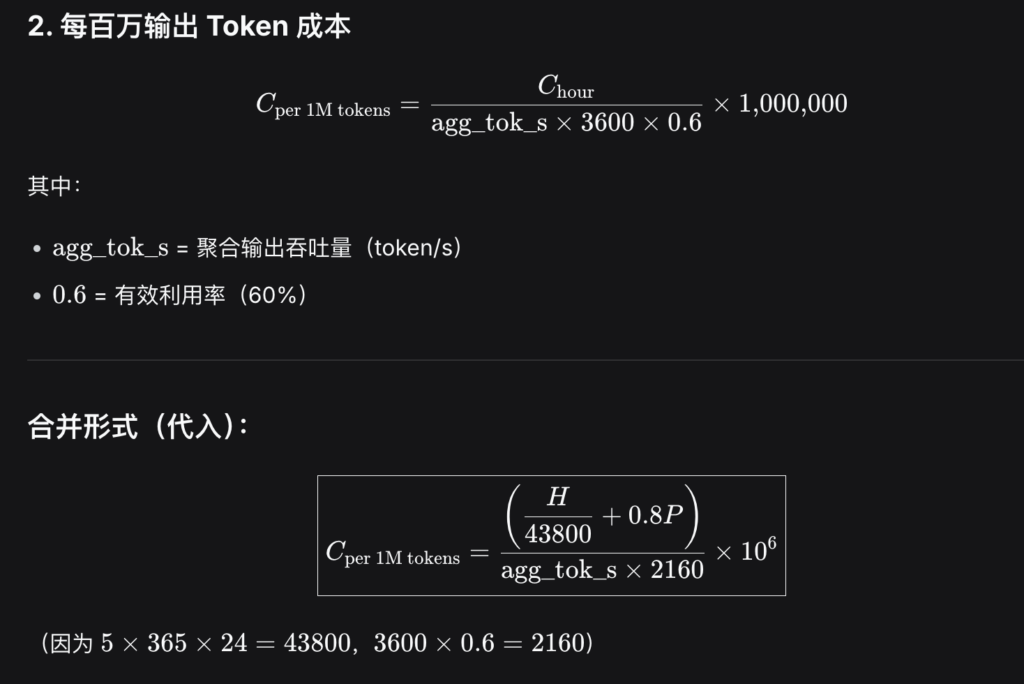
该口径假设机器平均有 60% 时间按 16 并发中位吞吐生成 token。它没有计算输入 prefill token、制冷 PUE、维修、工程师、网络、融资成本和质量损失。实际利用率只有 20% 时,单位 token 成本大致会升至表中约三倍。
成本和能效结果
| 方案 | 成本中位数 | 墙上功耗 | 16 并发中位 tok/s | W / tok/s | 折旧+电费 RMB/h | RMB / 百万输出 token | 是否满足十万与 1M |
|---|---|---|---|---|---|---|---|
| 2× DGX Spark | 8.5 万 | 0.38kW | 310 | 1.23 | 2.24 | 3.35 | 是 |
| 1× DGX Spark | 4.2 万 | 0.19kW | 60 | 3.17 | 1.11 | 8.57 | 是 |
| R9700 + Strix Halo | 5.8 万 | 0.50kW | 130† | 3.85 | 1.72 | 6.14† | 预算是;1M 未验证 |
| RTX PRO 6000 ×1 | 10.0 万 | 0.75kW | 150† | 5.00 | 2.88 | 8.90† | 边缘;1M 未验证 |
| 二手 H100 ×1 | 7.5 万 | 0.60kW | 45† | 13.33 | 2.19 | 22.55† | 预算是;完整本地 1M 否 |
| 二手 H100 ×2 | 12.5 万 | 1.05kW | 195† | 5.38 | 3.69 | 8.77† | 否 |
| H200 ×1 | 28.2 万 | 0.75kW | 170† | 4.41 | 7.04 | 19.17† | 否 |
| H200 ×2 | 56.0 万 | 1.45kW | 525† | 2.76 | 13.95 | 12.30† | 否 |
| H20 ×1 | 10.5 万 | 0.55kW | 50† | 11.00 | 2.84 | 26.27† | 通常否;1M 否 |
| H20 ×2 | 20.0 万 | 1.00kW | 170† | 5.88 | 5.37 | 14.61† | 否 |
| H100 + H20 | 18.0 万 | 1.10kW | 145† | 7.59 | 4.99 | 15.93† | 否 |
| 300I A2 ×8 | 42.0 万乐观值 | 3.20kW | 275† | 11.64 | 12.15 | 20.45† | 否 |
这些数字揭示了一个容易被忽视的结果:双 Spark 不只是购买成本低,其多请求能效也可能优于单 Spark。 双机增加了约一倍内存和功耗,但在批处理下 aggregate throughput 可增加约五倍,因此折旧、电费和 W/tok/s 都更好。前提是业务真的有足够并发,使第二台机器不长期闲置。双 Spark 的单请求提升没有这么大,单流通常只是从单 Spark 的约 22–35 tok/s 提升到约 55–66 tok/s。
R9700 + Strix Halo 的成本结果看起来接近双 Spark,但这是低置信度值:已公开的 51.1 tok/s 是单流,不是连续批处理;若实际 16 并发只能做到 70 tok/s,其单位 token 成本将由约 6.1 元升至约 11.4 元。
单 H100 的单位 token 成本反而很差,因为模型无法完整放在 80GB HBM 中,PCIe/CPU offload 使昂贵 HBM 和 Tensor Core 无法持续饱和。对于本模型,容量不足时,算力和 HBM 带宽不能替代容量。
图中水平虚线是十万元预算上限。单 H200、双 H100/H20、异构 H100+H20 和八卡 300I A2 均不属于严格预算内方案;单 RTX PRO 6000 只有在已有主机、二手成交或特殊渠道下才可能压线。
即使双 Spark 的本地输出 token 成本估算约为 3–4 元/百万,它也未必比 DeepSeek 官方 API 便宜。自建的主要价值是数据不出域、离线可用、固定延迟、模型可修改、无外部限流和可建立内部 prefix cache,而不是单纯击败官方边际 token 价格。官方 API 定价若继续维持低位,中低利用率用户很难从纯财务角度收回硬件。
综合排名与采购部署建议
严格十万元内综合排名
| 排名 | 方案 | 性价比 | 可用性 | 部署难度 | 扩展性 | 推荐场景 |
|---|---|---|---|---|---|---|
| 第一 | 2× DGX Spark | 优秀 | 较高,已有 0731/1M 可复现路线 | 中高,需要双机网络、容器和补丁 | 好,可做 TP2;未来可拆分任务 | 私有 Coding Agent、RAG、内部 API、8–32 并发 |
| 第二 | 1× DGX Spark | 良好 | 最高的单机确定性 | 中;已有一键式社区安装器 | 一般,后续可再购第二台 | 个人开发、1–4 用户、长上下文研究 |
| 第三 | R9700 + Strix Halo | 潜力优秀 | 中低,依赖特定版本和定制引擎 | 高 | 中;异构扩展复杂 | 愿意调 ROCm、追求中短上下文单流速度 |
| 第四 | RTX PRO 6000 单卡 | 一般 | CUDA 通用性高,但 V4 容量不足 | 中 | 好,未来可加第二卡但成本高 | 同时运行视觉、训练、小模型和 V4 量化版 |
| 第五 | 二手 H100 单卡 | 较差 | 卡本身成熟,目标模型不合适 | 中高,涉及 offload | 加第二卡后成本超标 | 已经有 H100 主机,而非专门为 V4 购买 |
| 第六 | Atlas 300I A2 单卡 | 对该模型差 | 无法加载完整模型 | 高,CANN/Ascend 栈 | 单卡用途有限 | 国产化小模型、Embedding、72B 级模型,而非 V4 Flash |
条件性和淘汰结论
双二手 H100只有在已经拥有兼容双卡服务器、能以极低价格获得两张经过完整检测的 PCIe H100,并接受量化权重时,才可能接近十万元。即使卡价压到预算内,散热、电源、PCIe 拓扑和售后仍可能让整机越界。
单或双 H200是性能方案,不是十万元性价比方案。单 H200 虽有 141GB HBM3e,仍不足以无压缩容纳原始 160–167GB 权重;双 H200 很强,但价格约相当于六到七套双 Spark。
H100 + H20 异构组合应直接排除。 vLLM 的常规 tensor parallel 假定参与设备具有相近算力、kernel、显存和通信特征;H100 与 H20 混用会导致慢卡同步、显存分片不均和 kernel 选择复杂。除非自行开发 expert placement 和异构调度器,否则它不会自然获得“两个 GPU 优点相加”的结果。
八张 Atlas 300I A2 PCIe 拼装不等于 Atlas 800I A2。 前者跨卡 MoE 流量要穿过 PCIe switch/CPU,后者是华为为多 NPU 设计的整机互联拓扑。即使八张卡提供 512GB HBM,采购价、3kW 以上功耗、服务器底盘和 CANN 调优都会使其远离十万元目标。vLLM‑Ascend 的官方 V4 路线应以 Atlas 800 A2/A3 文档为准。
推荐采购配置
对于本地私有 API 和 8–32 个并发 Agent,推荐配置为:
| 部件 | 建议 |
|---|---|
| 计算节点 | 2× DGX Spark 128GB |
| 节点互联 | 合规 200Gbps ConnectX‑7 QSFP 直连线 |
| 存储 | 每台保留至少 500GB 模型与构建空间;最好使用原装 4TB NVMe |
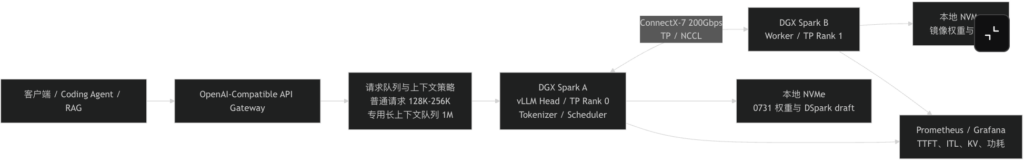
| 网络 | 业务入口可走 10GbE,TP 通信走独立 ConnectX‑7 |
| 软件 | 当前社区验证的 vLLM/DSpark 容器、0731 权重加载补丁、NVFP4 KV |
| 并行模式 | TP=2;先验证单流,再启用连续批处理 |
| 上下文 | 默认 API 限制建议设为 128K–256K;仅特定队列开放 1M |
| 并发 | 初始 max_num_seqs 设 6–8,稳定后再逐步扩展 |
| 监控 | 记录 TTFT、ITL、KV 使用、DSpark acceptance、节点网络吞吐和 OOM |
| 验收 | 使用自有 8K、64K、256K、1M 提示集,而不是只跑短 prompt tok/s |
双 Spark 的 1M 路线当前仍依赖社区 NVFP4 KV 和 DSpark 补丁,因此采购验收不能只检查“模型能启动”。至少应验证连续运行、冷启动、长提示 prefill、多个独立请求交错到达、prefix cache 命中、节点断连恢复和输出质量。社区记录显示 0731 在未修复 draft 权重加载时仍能给出正确输出,但 speculative acceptance 和速度会显著下降。
简要部署拓扑
最终采购决策
预算 4–5 万元:买一台 DGX Spark。 它是最低成本、已有 0731 单机 1M 验证、维护风险最小的选择;适合个人和少量用户,但不要期待高并发下接近双机吞吐。
预算 8–10 万元:买两台 DGX Spark,并把 200Gbps 互联线、税费和备用散热空间一起计入预算。 这是本报告的明确第一名,也是当前十万元内唯一同时满足容量、1M、并发吞吐和软件成熟度的方案。
追求中短上下文单流速度并愿意开发内核:考虑 R9700 + Strix Halo。 在公开短上下文测试中,它的 51.1 tok/s 非常有竞争力,但采购前必须要求供应商现场运行 0731、至少 256K/512K 长上下文以及连续批处理;不能仅凭 2K prompt benchmark 接受“完整 1M 生产可用”的承诺。
不要专门为 V4 Flash 0731 购买单张 H100、H20、RTX PRO 6000 或 Atlas 300I A2。 它们都落入“算力很强但容量不足”的陷阱。若已经拥有这些卡,可以尝试 Q2/FP4 和 CPU offload;若从零采购,双 Spark 更符合该模型的实际内存结构。
主要参考来源
| 类别 | 主要来源链接 |
|---|---|
| 模型官方资料 | DeepSeek‑V4‑Flash 官方模型卡;DeepSeek‑V4‑Flash‑0731 |
| 昇腾部署 | vLLM‑Ascend DeepSeek‑V4‑Flash 部署指南 |
| DGX Spark 官方规格 | NVIDIA DGX Spark Hardware Overview;NVIDIA DGX Spark 产品页 |
| DGX Spark 官方价格 | NVIDIA Marketplace DGX Spark |
| 双 Spark 0731 实现 | 2× DGX Spark 1M NVFP4 KV GitHub |
| 单 Spark 0731 实测 | NVIDIA Developer Forum:1× Spark 0731 |
| AMD 异构实测 | Lucebox R9700 + Strix Halo DeepSeek V4 |
| AMD 官方规格 | Radeon AI PRO R9700;Ryzen AI Max+ 395 |
| RTX PRO 6000 | NVIDIA RTX PRO 6000 Blackwell |
| H100 与 H200 | NVIDIA H100;NVIDIA H200 |
| Atlas 300I A2 | 华为 Atlas 300I A2 官方规格 |
| 国内硬件行情 | 算力之光设备参考行情;Atlas 300I A2 公开市场参考 |
