
一个引用检查器给一段含 3 条论断的段落返回了 3 行结果:2 行标为「有来源」,1 行标为「范围不清」。我打开第三条脚注,看到的是一张没有任何数字的着陆页。表格在字面意义上没有出错,但它回答的是一个更窄的问题:这里点了谁的名,而不是来源究竟说了什么。脚注只能证明某个来源存在,不能证明这个来源支撑了这条论断。
正是这个落差,让主张-证据-引用映射器值得像读编译器警告那样去读,而不是像读判决书那样去读。它挂在文本处理标签下,也可以在 Elysia Tools 的文本处理分类里找到。下面说的是测量在哪里停住,以及那四个标记究竟能换来什么。
一个正则决定了什么算作引用标记
模型一次都还没被调用,本地会先扫一遍原始文档数据,找三种形态:方括号数字、Markdown 链接,以及你自己提供的模式。
方括号模式接受 [1]、(1) 和 {1},左右符号各自独立匹配,所以 [1) 和 (2] 也算标记。由此产生两个后果:方括号里的年份不算标记,因为模式最多认三位数字,[1880] 仍被当作正文;而数学句里的圆括号编号,比如把 (2) 当作「第二种情形」,会被算成文档里根本没写过的引用标记。计数虚高,没有任何提示;一个随手写下的幅值标号就能把数量加上去,来源一个都没多。
Markdown 链接只有落在窄窗口内才计数:链接文字 1 到 60 个字符,URL 4 到 200 个字符。像 x 这样过短的写法扫描不到,而用裸上标写成的脚注,从来不会出现在计数里。
你自己的正则在两轮扫描之后运行,以全局模式编译。模式写错了会被静默吞掉:你得到的仍然是内置那两轮的结果,也没有任何报错告诉你写的模式根本没跑过。先拿样本试一次。匹配不到任何东西的模式,和一个没有任何引用的文档,输出完全一样。
标记计数把你的参考文献也算进去了
本地扫描读的是整段文档字符串,所以计数统计的范围包含你为提供背景而粘贴进来的文字。参考文献列表如果也放在同一个输入框里,每一条以 [1] 或 [2] 开头的记录同样会被算成标记。
一节含 12 条论断的文字,配上 12 条参考文献一起粘进文本输入框,会报出 24 个标记。把同一份参考文献挪到工具单独保留的「引用」输入框,标记数就掉到 12。同一份文档,数字减半。两种读数都没有错,但只有一个是你要的数字。一条规则就够用:运行之前,先把参考文献从文本输入框里挪走。
论断抽取在 24,000 字符处悄悄停止
表单最多接受 30,000 个字符。调用模型时,只有前 24,000 个字符经由 text.slice(0, 24000) 发出。
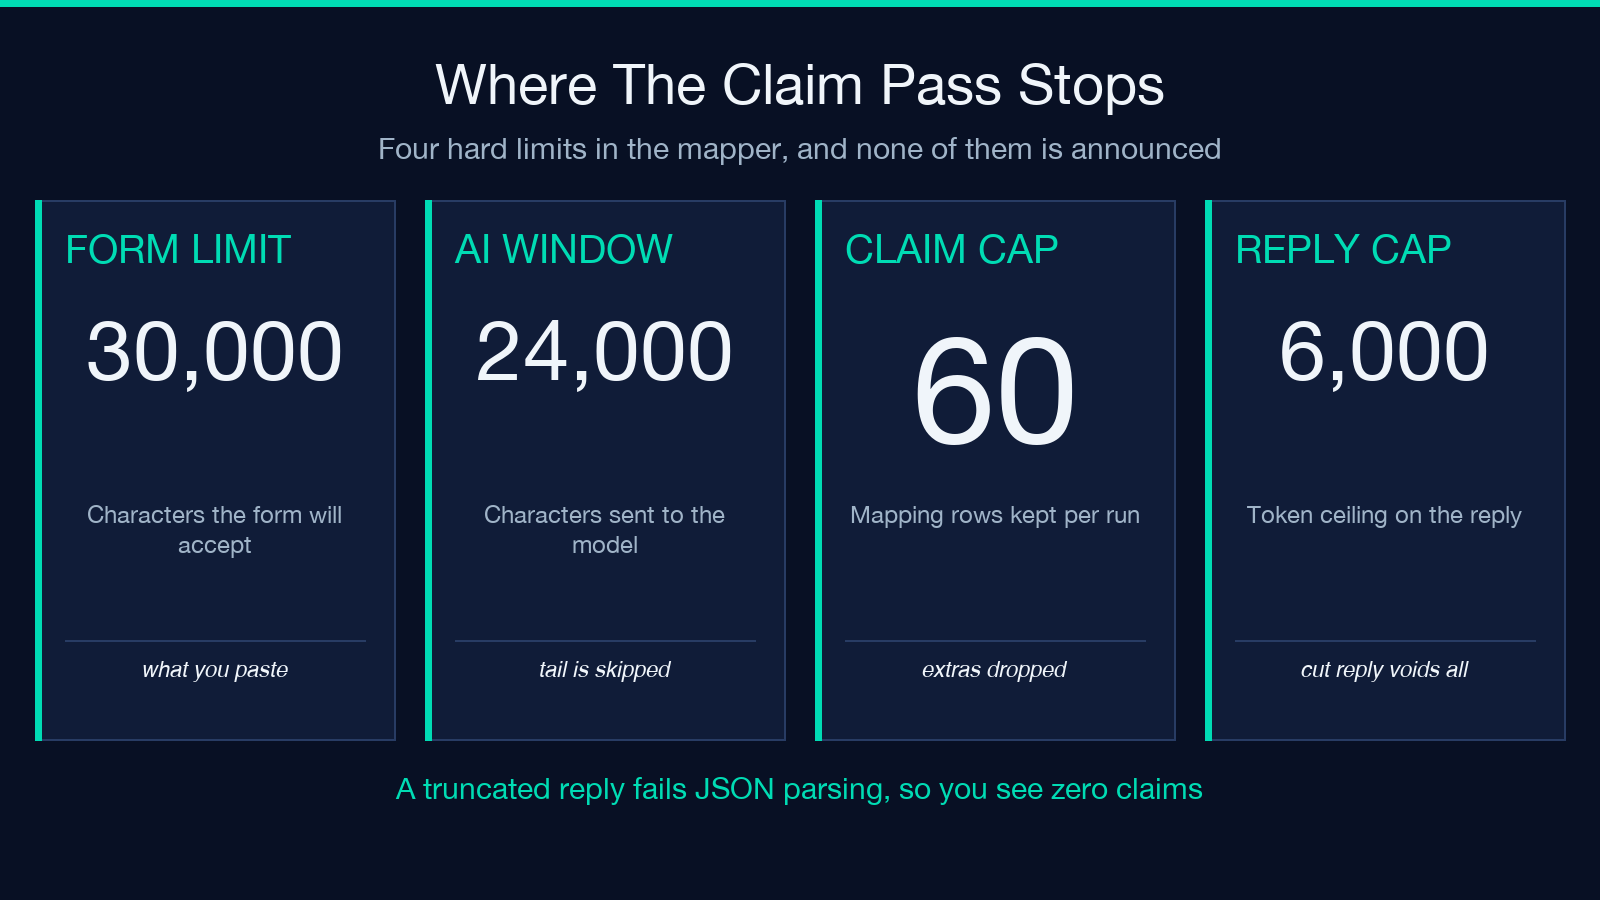
后果是这张表悄悄只描述了文档的开头部分。粘进 28,000 字符的文献综述,再接上你的讨论,讨论部分会得到零行,而输出里没有一个字说明原因。标记数是按全部 30,000 字符统计的,论断抽取只覆盖 24,000 字符,两个数字量的甚至不是同一段文字。在上限替你做出武断切割之前,自己先切好。
每节多花五分钟,换来的是没有任何一条论断被跳过的保证。这是整个流程里最便宜的保险,而面板永远不会提醒你这么做。
四个风险标记,没有一个是测量结果
每一行被标为 sourced、weak source、no source 或 ambiguous scope,汇总面板按标签分组显示数量。四个标签全部来自模型,温度设为 0,每条都在备注列附一句简短理由。
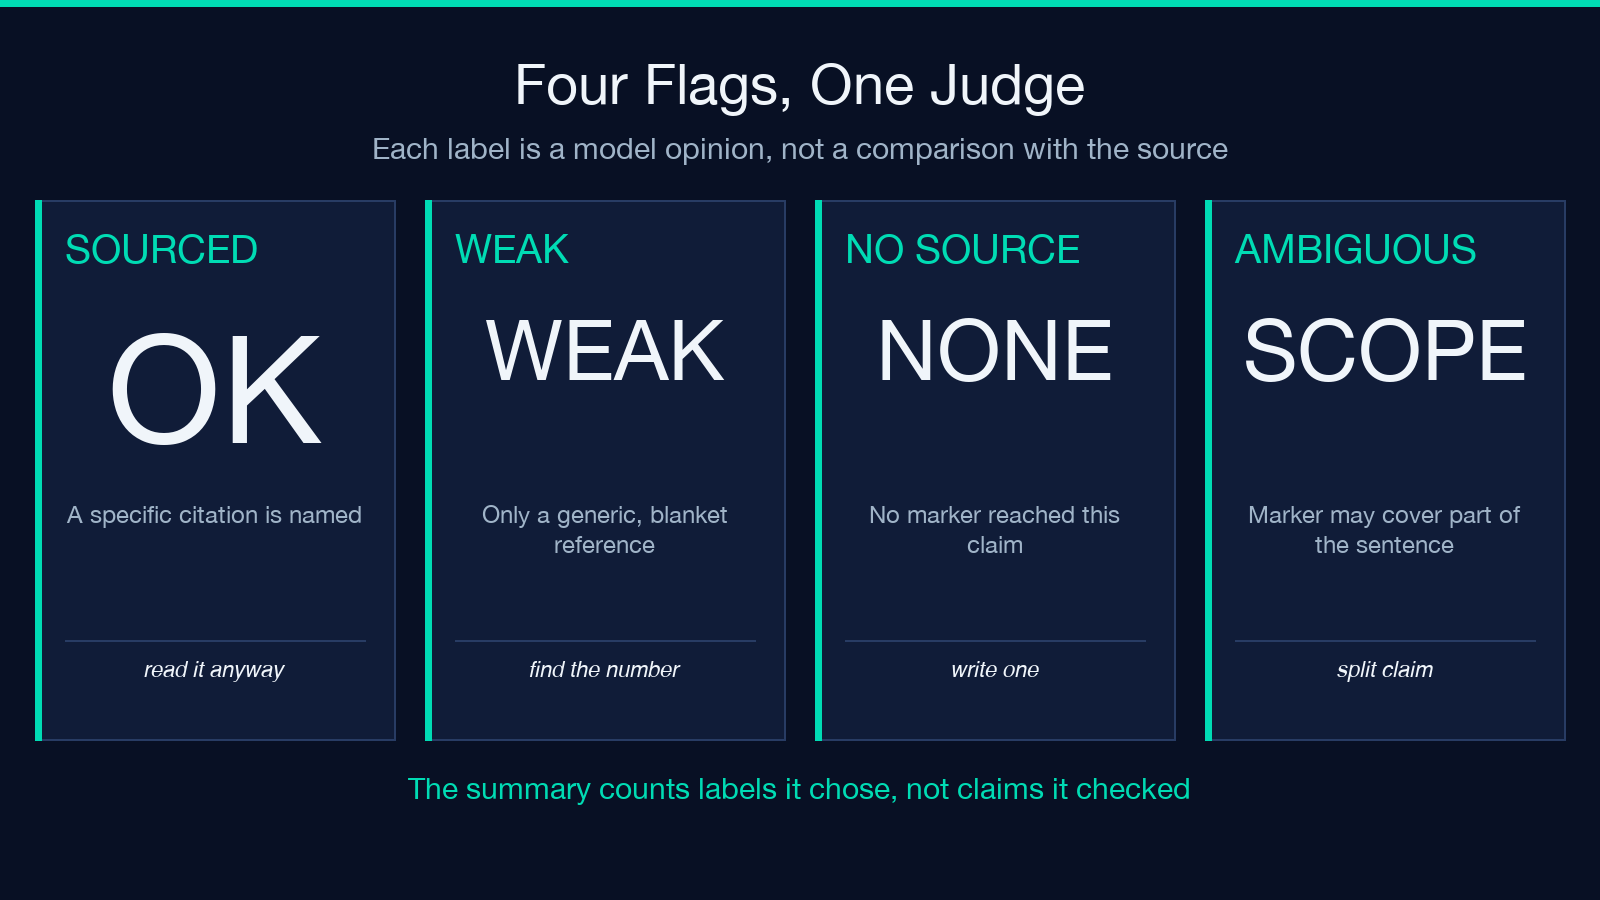
工具里没有任何代码会把你的句子和参考文献数据做比对。所以「0 条无来源」说的是模型选了哪些标签,不是你的论断站得住。这个数字由模型报出、由模型判定、也由模型打分。把标签换成一条你亲自读过的引用,这条论断就变成你要负责辩护的东西。
其中两个标记,用手工就能低成本证伪。打开被模型判为有来源的那条引用,读摘要,再和你的句子对照。最坏的情况是你发现那项研究说的是相邻的另一件事,而多数「弱来源」就是这样得到这个标签的。
更大的不对称,在于那些从未进入表格的东西。模型没有抽出来的事实性论断,没有对应行、没有标签,也不参与任何计数。汇总里的每个数字都是「已抽取论断」的分式,而分母是在没人通知的情况下变动的。
论断计数与汇总行可能对不上
顶部计数显示的是 claims 数组的长度。汇总则通过一张四键查找表按状态计数。当模型返回集合之外的状态时,该行在显示上回落到「无来源」,而计数器写下的第五个键,没有任何汇总行会打印出来。
结果是计数写着 9 条论断,下面四行加起来只有 8。这个缺陷很小,但值得在意:它正是你该手工核对总数、而不是眯着眼盯面板的理由,也是你该在报告里说清自己引的是哪个数字的理由。
模型回复遵循同样的全有或全无规则。解析器按贪婪匹配取出一段花括号文本,交给 JSON.parse。回复在 6,000 token 上限处被截断时,解析抛错,catch 块丢弃整个结果,页脚显示「AI 映射不可用」。你看到的是零条论断和一条关于 API 的提示,而模型其实已经给你的文档标完了大半。一篇 40 条论断的论文,撞到 token 上限远比撞到字符上限要早。
纯本地模式才是诚实的默认值
AI 复选框默认关闭,本地结果比听起来有用,因为它是这个工具里唯一确定的部分。它不接触任何模型,也不解读你的任何数据。
关掉 AI,你得到的是一份标记数、一份引用数,以及一条说明论断抽取需要模型的提示。这两个数字能廉价地拦住一类问题:标记多于引用,或者引用在正文里从未出现。12 个标记对 12 条引用,就是你的基准线。它们不会告诉你哪个标记是孤儿,因为把标记和条目配对是模型的活,所以把这一对数当作警戒线,别当作诊断。两个实测数字胜过一个推断出来的标签。养成先跑纯本地、再打开模型的习惯。
用工具自带的示例跑一遍
随工具附带的示例是三句话、两条引用:
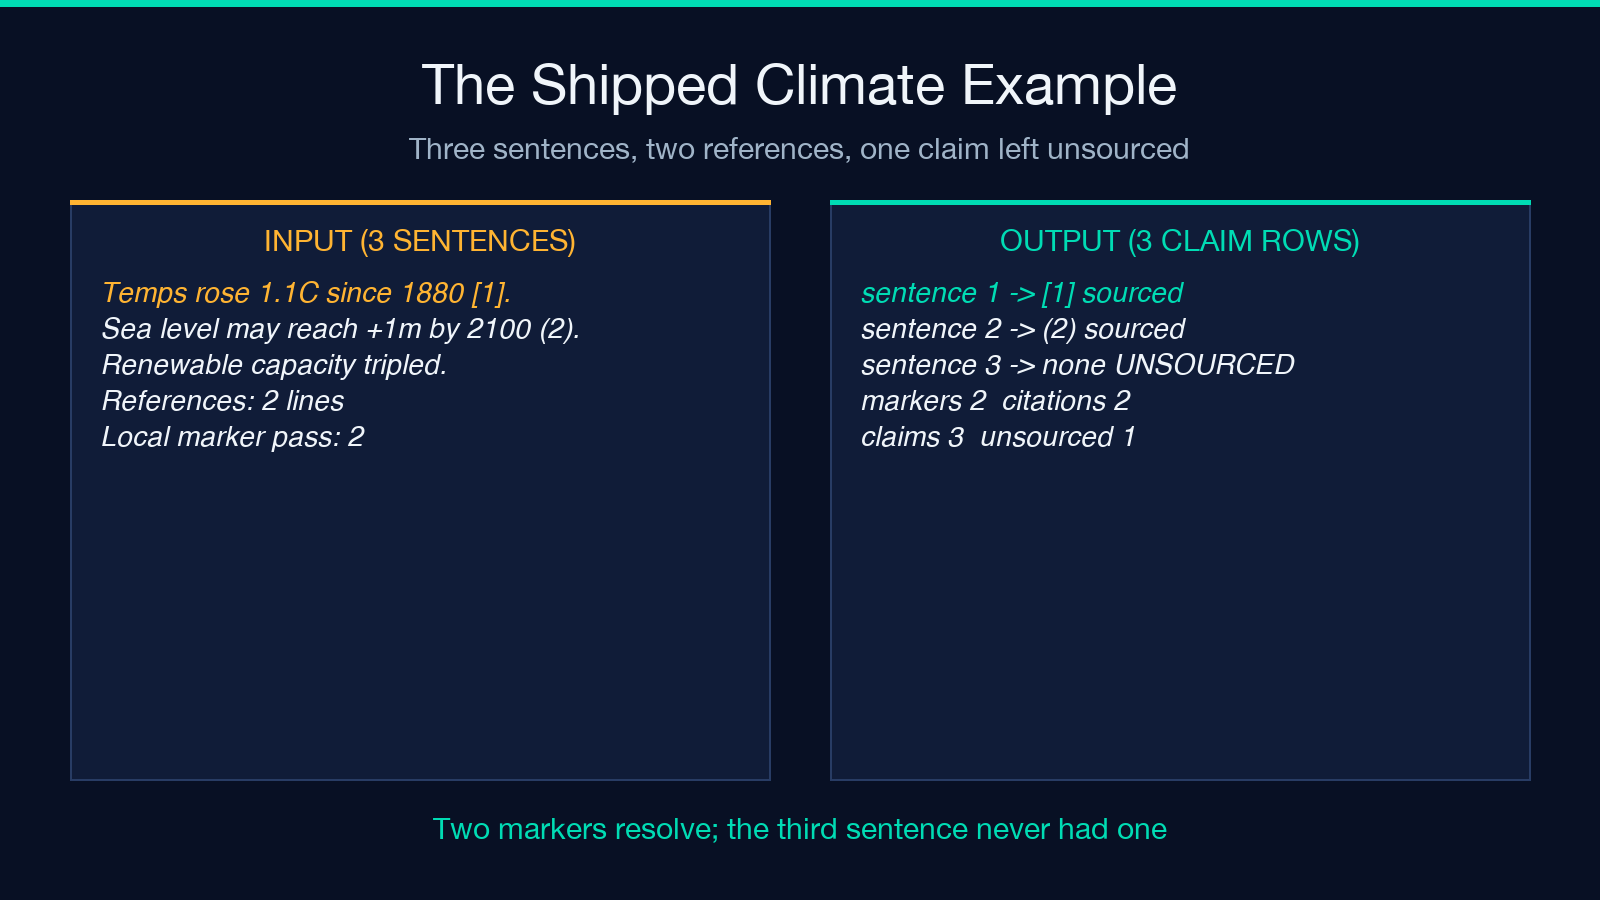
- 全球气温自 1880 年以来上升约 1.1°C [1]。
- 海平面到 2100 年可能达到 +1 米 (2)。
- 可再生能源装机容量在过去十年增至原来的三倍。
本地扫描找到两个标记,括号底下都是裸数字:1 和 2。引用计数为 2。开启 AI 之后,映射表有三行,其中一行无来源,因为第三句根本没有带标记。另外两句的证据,则落到编号所指向的那一条参考文献上。
第三行就是运行这个工具的全部理由。那两条确认你本来就能自己给出;真正有价值的是那句你凭记忆写下、从未标注来源的句子。一个只找出这一行、别的一无所获的检查器,已经在流程里挣到了它的位置。这个示例对上界也是个公正的标尺:3 条论断放进 6,000 token 的回复绰绰有余,一篇真正的论文则放不下。用主张-证据-引用映射器跑一遍你自己的稿子,看看哪些行回来是空的。
把表格当作问题清单,而不是判决
把输出读成针对你自己文档的一组问题。这条引用是对的那条吗?那个范围不清的标记覆盖整句,还是只覆盖半句?哪一条论断,我下笔的把握超过了研究能支撑的程度?
这样读,「无来源数很低」的含义就变了。它不是一个分数,只是模型碰巧看到、又挂不到任何来源上的论断条数。按面板页脚的说法,每一条映射都是待核实的建议,这句话比它上面的那些计数更诚实。更多工具见 elysiatools.com。
这些都不说明映射表是错的。它只说明这张表比文档小,也说明每个标签都是附了理由的意见。投稿前跑一遍,改掉它挑刺的那几行,然后去读你最确信的那三条引用。关键在于,你最确信的那几条,恰恰是你从未核对过的。你稿子里哪一条引用,从粘贴进来那天起就没再打开过?

Pingback: Your Footnote Proves a Source Exists, Not That It Supports the Claim - COSESAI