
一个转换数为 10 s⁻¹ 的酶,可以排到每秒转换 100,000 次的酶前面。这跟测定有没有错无关:只用 kcat 排序,问的就是一个错的问题。除以 Km,排行榜会重新洗牌;接下来撞上的那道上限,跟化学没有关系。
两种酶,一个底物,排名颠倒
取两种作用于同一底物的水解酶。
酶 A 很快,转换数 100,000 s⁻¹,米氏常数 50 mM。酶 B 迟缓,10 s⁻¹,Km 为 1 µM。只看 kcat,A 领先四个数量级。
换成催化效率,B 反超五倍:
- 酶 A:100,000 s⁻¹ ÷ 50 mM = 2.0 × 10⁶ M⁻¹s⁻¹
- 酶 B:10 s⁻¹ ÷ 1 µM = 1.0 × 10⁷ M⁻¹s⁻¹
这种颠倒正是这个指标的全部意义。Km 是酶跑到最大速率一半时的底物浓度,等于给底物标了价。需要 50 mM 才够到最高速的催化剂,在细胞维持的浓度下并不快;而在 1 µM 就饱和的慢催化剂,全程都贴着自己的上限跑。
酶催化效率计算器(kcat/Km)正反两个方向都能算这个比值:直接输入 kcat 与 Km,或者由 Vmax 与酶浓度反推 kcat。
kcat/Km 是二级速率常数,不是速度
单位已经说明你在量什么。kcat 的单位是每秒,Km 是浓度,两者相除得到 M⁻¹s⁻¹,正是二级速率常数的标志。它确实也就是这个:游离酶与底物相遇、结合、进而生成产物的表观速率。
在 Briggs-Haldane 稳态下,这个比值有闭式解:
- kcat/Km = k₁k₂ / (k₋₁ + k₂)
由此落出两个极限,文献里大部分混乱都能靠它们解释。1977 年 Knowles 与 Albery 关于催化完美的研究,整篇论证就建立在这个恒等式上;Fersht 在《Structure and Mechanism in Protein Science》里讨论特异性,也从同一处出发。
当化学步骤相对于解离很慢(k₂ ≪ k₋₁)时,比值化简为 k₂/KD。它量的是结合加催化,这正是多数实验台科研人员口中的“特异性”。
当化学步骤很快(k₂ ≫ k₋₁)时,比值趋近 k₁,即结合速率常数。到这一步,测的其实是扩散,酶已经不在被测之列。
拿数字验证。取 k₁ = 10⁹ M⁻¹s⁻¹、k₋₁ = 10⁵ s⁻¹、k₂ = 10³ s⁻¹,比值是 9.9 × 10⁶ M⁻¹s⁻¹,与 k₂/KD 一致。把 k₂ 提到 10⁷ s⁻¹,比值升到 9.9 × 10⁸ M⁻¹s⁻¹,紧紧压在 k₁ 上。再想往上推,祝你好运。
一处换算,悄悄把答案砍掉 60 倍
我在各种报告里见到的坏数字,多数由单位造成,跟代数关系不大。三处换算最伤人:60、1,000 和 60,000 倍。
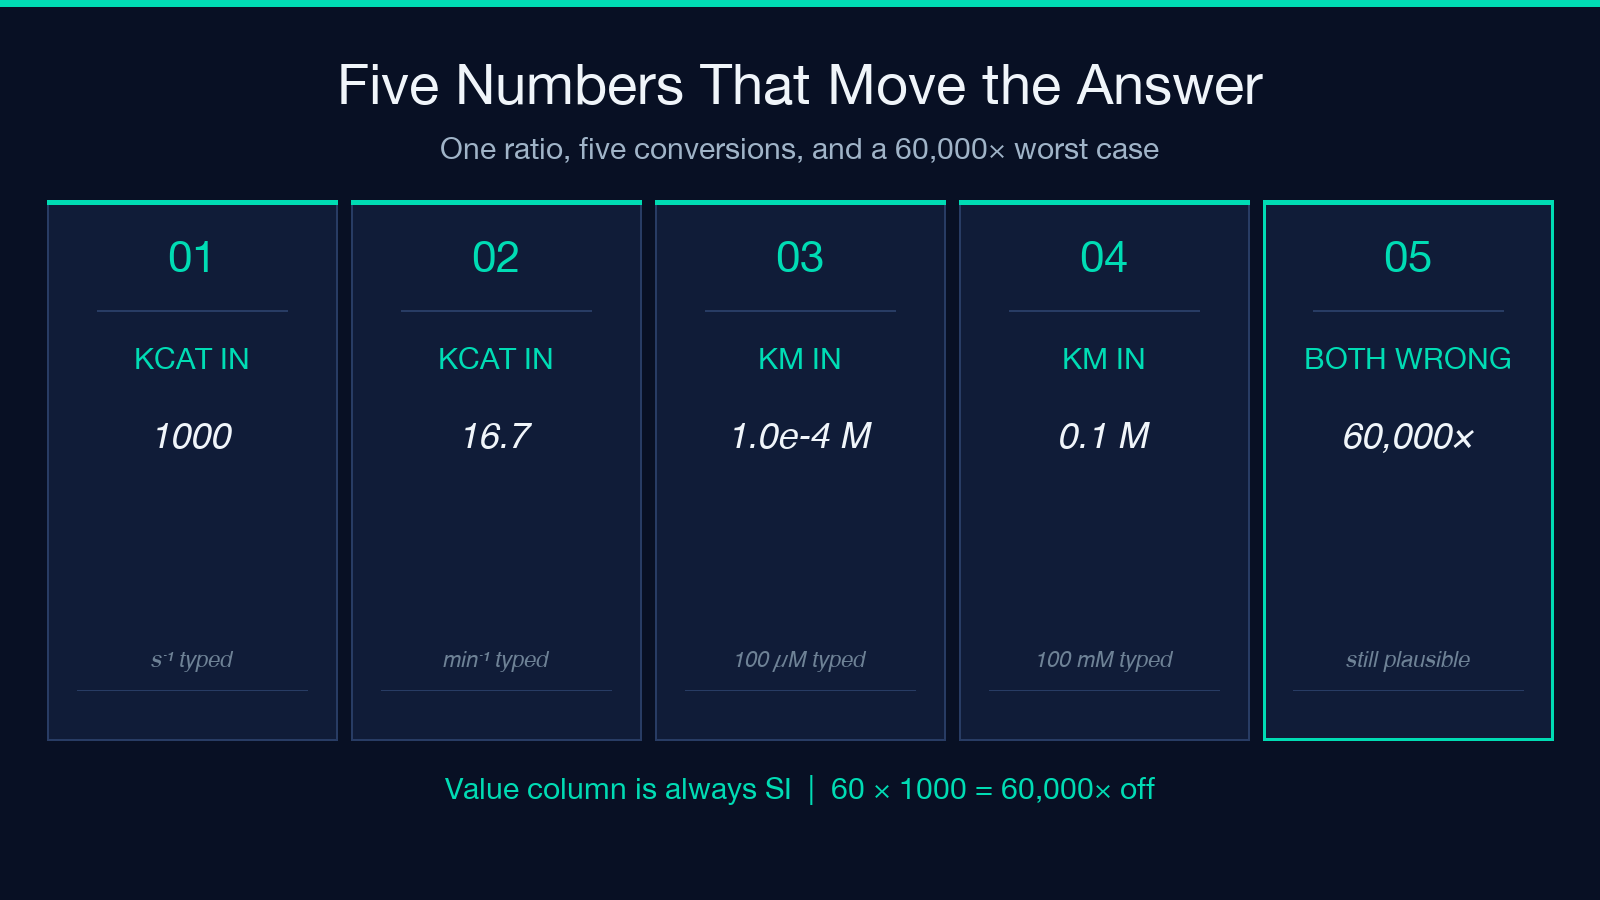
转换数按分钟计。kcat 输成 1000 min⁻¹ 而不是 1000 s⁻¹,答案就差 60 倍。Km 取 100 µM 时,这就是 1.00 × 10⁷ M⁻¹s⁻¹ 与 1.67 × 10⁵ M⁻¹s⁻¹ 之间的差距,整整一档再加一个数量级。用 Vmax 模式,这一步除法工具替你做。例如 50 µM/min ÷ 2 µM = 25 min⁻¹,再 ÷ 60 = 0.4167 s⁻¹。忘了第二个除数,你交出去的数就大六十倍,看上去却仍然合理。
Km 的前缀写错。1 mM 等于 1,000 µM,也等于 1,000,000 nM。该填 100 µM 的写成 100 mM,答案掉 1,000 倍:从 1.00 × 10⁷ 降到 1.00 × 10⁴ M⁻¹s⁻¹,往下掉两档。
活性位点与总蛋白。kcat 要的是催化位点浓度,不是纯化蛋白的质量。一个二聚体酶,每个亚基有一个功能位点,2 µM 的溶液就是 4 µM 的位点,这个二倍因子会一路传进比值。
前两处叠在一起,就能交出一个错 60,000 倍的答案,而每一步单独看都很像样。
数字从哪里开始与化学无关
大约在 10⁸ 到 10⁹ M⁻¹s⁻¹ 之间,小分子底物遇到折叠良好的活性位点,已经和扩散允许的速度一样快。这道上限不是等你去破的纪录,是一堵物理的墙,教科书里的三个范例就贴在墙上:磷酸丙糖异构酶、碳酸酐酶、乙酰胆碱酯酶。第一个常引 Radzicka 与 Wolfenden 1995 年的基准数据。
有两个后果影响解读。
其一,上限之上的差异是噪声,不是信号。报出的 2 × 10⁸ 与 1 × 10⁹,差的是测定条件,不是演化水平。就这个数所能表达的唯一意义而言,两种酶都是完美的。
其二,这个比值只在底物浓度远低于 Km、酶浓度远低于底物浓度时成立。碰上紧密结合的抑制剂或紧密结合的底物,测得的值可能受结合速率限制,而不受任何催化步骤限制,推出公式所用的稳态假设也随之失效。两个实验室相隔十年测同一种酶,能报到相差十倍;测得的值既属于蛋白,也属于测定方法。
区间只是读数辅助,其中一条边界随你的舍入移动
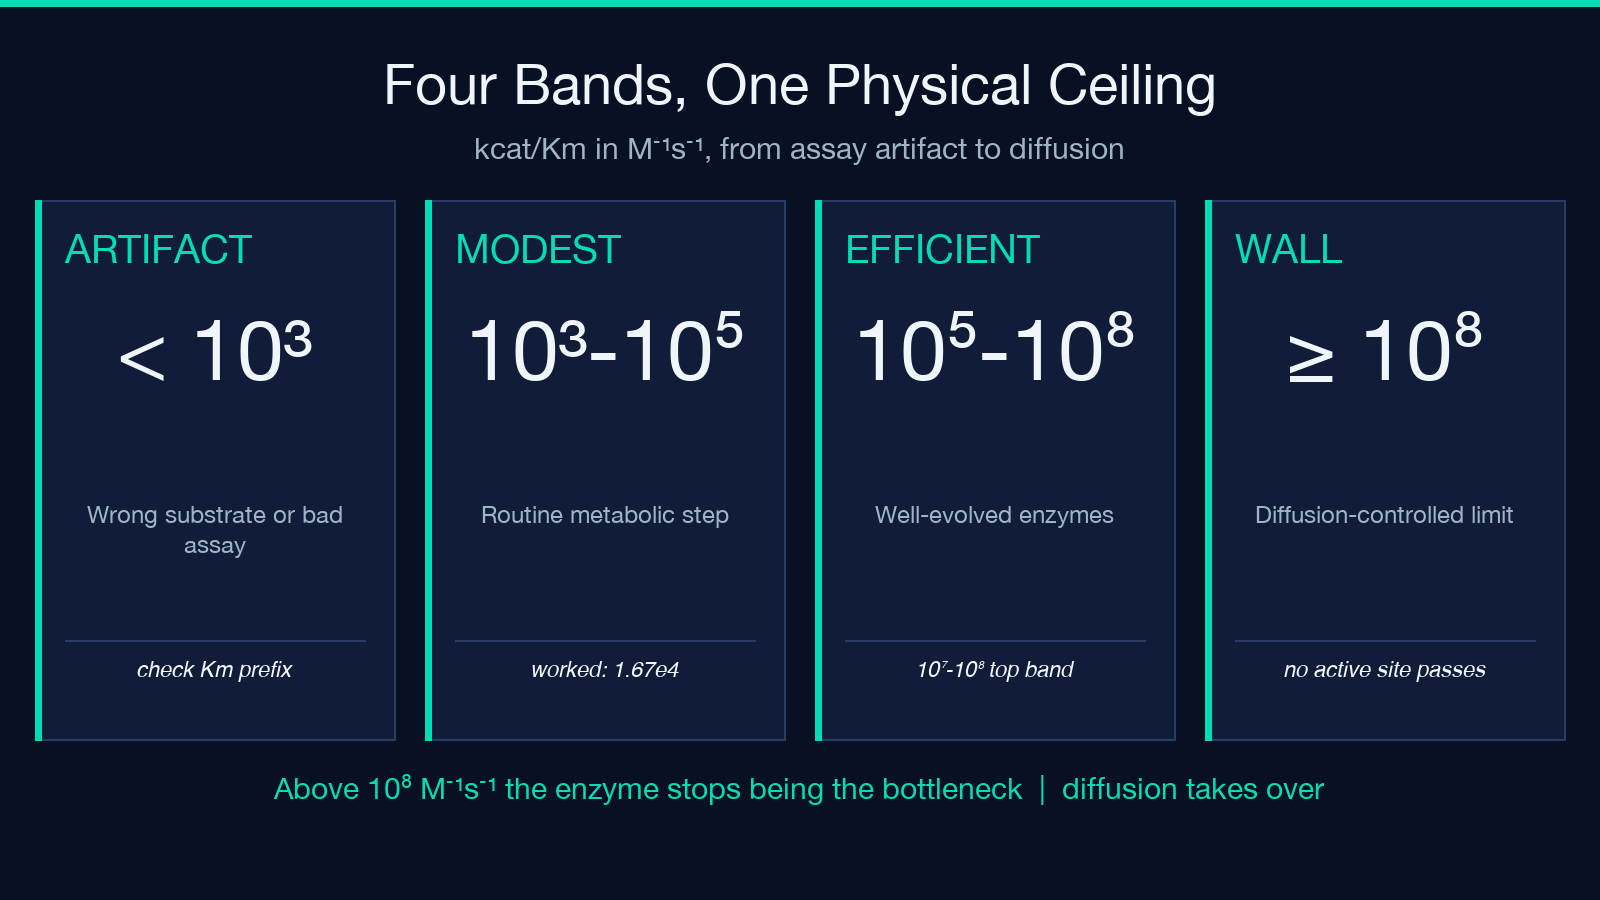
计算器会给结果分档:低于 10³ 低效,10³ 到 10⁵ 中等,10⁵ 到 10⁷ 高效,10⁷ 到 10⁸ 再上一档,10⁸ 及以上属于扩散控制区。
对这个阶梯,有两条老实话要说。
区间是按四舍五入后的结果判的,所以小数位设置能改变结论。小数位设成 0,999.6 M⁻¹s⁻¹ 的测量值会进到 1000,被读成“中等”,而不是“低效”。数字没变,标签变了。
10⁷ 这条边界也落在上一档,不属于当前档。结果正好是 1.00 × 10⁷ M⁻¹s⁻¹(工具第一个公开示例就是这个数),返回的是 10⁷ 到 10⁸ 的标签,而上面的正文把 10⁵ 到 10⁷ 称作“高效”。把这些区间读成上端开放的取值范围,别当成能写进图注的形容词。
还有一处更锋利的边缘。kcat 接受 0,因为校验器只拒绝负数。空白或绑定错误的字段传进来是 0,工具就会果断诊断出一个低效的酶,而不是报错。Km 的校验严一些,直接拒绝 0,因为那里比值无定义。如果你的结果在最后一位上显示低效,先确认 kcat 字段填了值,再相信读数。
一个可以手算复核的实例
下面两个例子都取自工具的公开示例,每一步都能复现。
直接模式。kcat = 1000 s⁻¹,Km = 100 µM。把 Km 换成摩尔浓度:100 µM = 1.0 × 10⁻⁴ M。1000 除以 1.0 × 10⁻⁴,得 1.00 × 10⁷ M⁻¹s⁻¹。比扩散上限低一个数量级,落在 10⁷ 到 10⁸ 这一档。
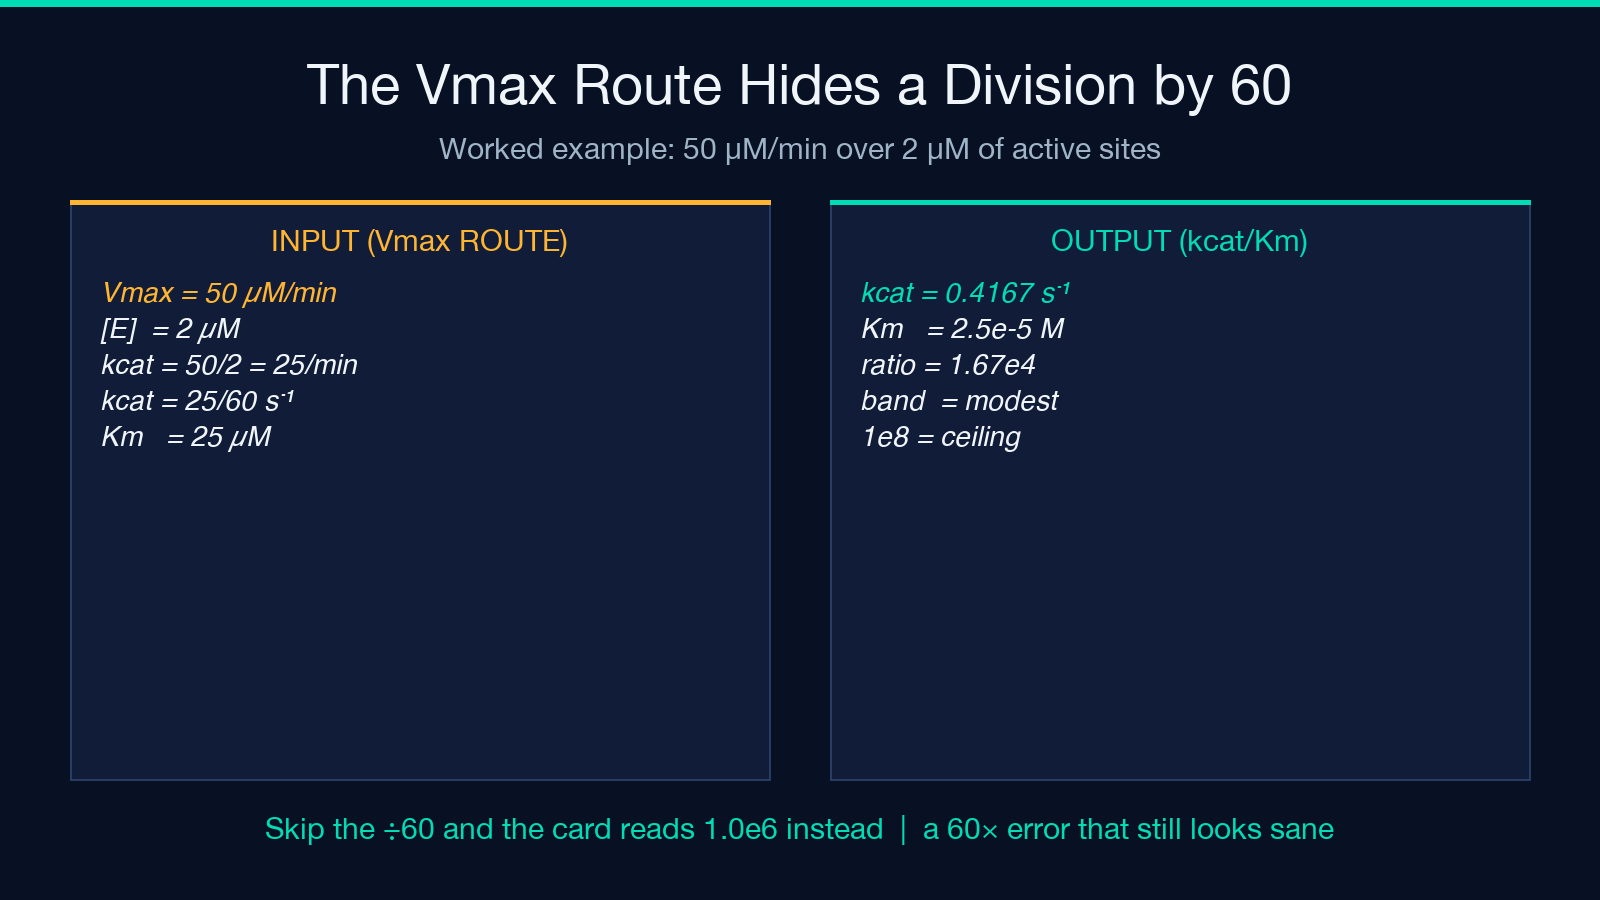
由 Vmax 反推。饱和测定给出 Vmax = 50 µM/min,活性位点 2 µM,于是 kcat = 25 min⁻¹ = 0.4167 s⁻¹。Km = 25 µM 时,0.4167 除以 2.5 × 10⁻⁵ M,得 1.67 × 10⁴ M⁻¹s⁻¹,判为中等。这是常规代谢步骤的水平,不是扩散极限,标签也这么讲。
两个例子上手各算一遍。亲手算过,换算就不再抽象;只看数量级,你就能发现 Km 前缀填错了。
报告一对数,而不是只报比值
比值会把输入藏起来,综述里同一种酶出现互相矛盾的值,多半就是这么攒出来的。把 kcat 与 Km 分开报,各自带单位,与比值并列。
还要写清会让这两个数漂移的条件:温度、pH、缓冲液、离子强度、拟合所用的底物浓度范围,以及 kcat 来自带活性位点滴定的 Vmax 还是直接测量。25 °C 下测的 Km 搬不到 37 °C 的测定里用;用总蛋白而不是活性位点推出来的 kcat,差着一个审稿人也找不回来的未知因子。
要是比较本身重要,就固定条件,只改一个变量。同一缓冲液、同一温度、同一批酶,只换底物。这样比值排的是底物;改两个变量,它排的就是你的移液手感。
引用论文之前,先自己算一遍
酶催化效率计算器(kcat/Km)存在的意义,是那步枯燥却值钱的工作:拿手里的数对上前面那些换算。它用数值和科学计数法同时给出结果,报出所属区间,并把稳态假设写进注意事项,免得你作图做到一半就忘了它。
工作流的其余部分有两个邻居接手。酶转换数计算器(kcat)由 Vmax 与酶浓度反推 kcat;酶抑制常数计算器(Ki 与 IC50,Cheng–Prusoff)处理抑制常数,当你的底物比较变成竞争实验时用得上。想把周边的动力学工具集中在一处,可以浏览教育类工具全目。
把两个输入喂进去,然后把区间当作合理性检查,而不是评级。
我原本想论证 kcat/Km 才是诚实的数字,kcat 是虚荣的数字。这个说法有一半能在算术面前站住。
给同一种酶的不同底物排序,比值是唯一公平的比较,还能在审稿人之前抓出 60 倍的换算疏漏。把一种酶跟另一种酶比,它量的则是离扩散上限有多近,而那道墙没有哪个活性位点能靠工程绕过去。这两件事都真实存在,可它们都不是字面意义上的“效率”。
那么,问问你上一张图的图注派给了这个数什么任务,再问这句话能不能当众说出口?这才是关键。

Pingback: The Enzyme With the Highest kcat Usually Loses - COSESAI