
大多数降噪器要求你先相信它。这个工具先测量,然后让你拿测量结果去对照它贴在旁边的标签。我按工具自己的实现重建了那条判定链,找到的缺口很具体:在白噪底座上叠 −55 dBFS 的 60 Hz 交流声时,档案记录下了这声交流声,标签却写成白噪声嘶声,于是那道保护性的高通滤波器根本进不了链路。这个缺口为什么重要?
因为决定哪个滤波器运行的是标签,不是测量值。提取器用精确频率的 Goertzel 算法探测市电交流声,把结果写进 JSON。
分类判定链只在第三个分支里才去看这项探测结果。交流声可以明明白白地写在文档里,本该处理它的那个分支却始终轮不到。工具没有骗你,它只是按一种会藏起自己部分答案的顺序回答问题。
提取器测了什么
Elysia Tools 上的 噪声样本提取器 接收一个音频文件、一个时间区域和一个模式,返回一份 JSON 指纹,可选再给一份整份文件的降噪副本。
区域才是关键。你要圈出一段只含有想去除的那种噪声的音频:句与句之间的室内本底、空调声、磁带嘶声、市电交流声。
工具对这个选择有硬边界:区域至少 0.5 秒,最长 30 秒。文件本身不能超过 10 分钟,分析器到这里就停。
在圈定的区域内,工具解码成 44.1 kHz 单声道,跑 8192 点 FFT,步长 4096 个采样。决定全部结果的配置是:8192 点、4096 采样步长、44.1 kHz 分析采样率。频率分辨率算出来是 5.3833 Hz,这是定位窄带音调能达到的最细刻度。工具对该区域内每一帧的功率谱取平均,档案后面每一个数字都从这一步来。
这份频谱产出五个数字,每一个都能拿去和你耳朵的判断对照。
第一个是 dBFS 的 RMS 电平,算法是 20 乘以均方根的对数(底数 10),旁边配一个峰值电平。第二个是噪声底,在这个工具里就是同一个 RMS 数保留一位小数。第三个是频谱平坦度,也就是维纳熵:功率谱的几何平均除以算术平均。纯白噪声的这个值接近 1.0。
第四个是低功率占比,即中心频率在 125 Hz 及以下的三分之一倍频程频带所占总功率的份额。第五个是市电交流声,用精确频率的 Goertzel 探测在 50 和 60 Hz 上找。最后这一项值得细说,工具最精确的地方就在这里。
对 50 Hz 和 60 Hz,工具先算出该精确频率上的功率,再把邻近三个探测频率取平均作为参考:−12 Hz、+12 Hz 和 +30 Hz。门限是:基频 10 dB,各次谐波 3 dB。探测点一共是 50 Hz、60 Hz,加上 38、62、48、72、80、90 Hz 作为参考。基频必须比参考高出 10 dB 以上才算数。算数之后,工具再去查基频两倍和三倍处的二次、三次谐波,只要它们比同一参考高出 3 dB 以上,一并计入。
这个设计是有意的。市电交流声是窄带的,窄带探测才找得到,只靠宽带指标会漏掉。举例来说,纯 60 Hz 音调的平坦度是 0.000,同一个音调叠在宽带底座上则是 0.971。两种情况下 Goertzel 探测都能抓到它。
七个标签,以及判定顺序
分类是一条判定链,顺序决定结果。这是理解这个工具最要紧的一点:这些分支并不并列,它们排成一个优先级队列。链的顺序是交流声、隆隆声、平坦度、粉红噪声、混合、宽带。
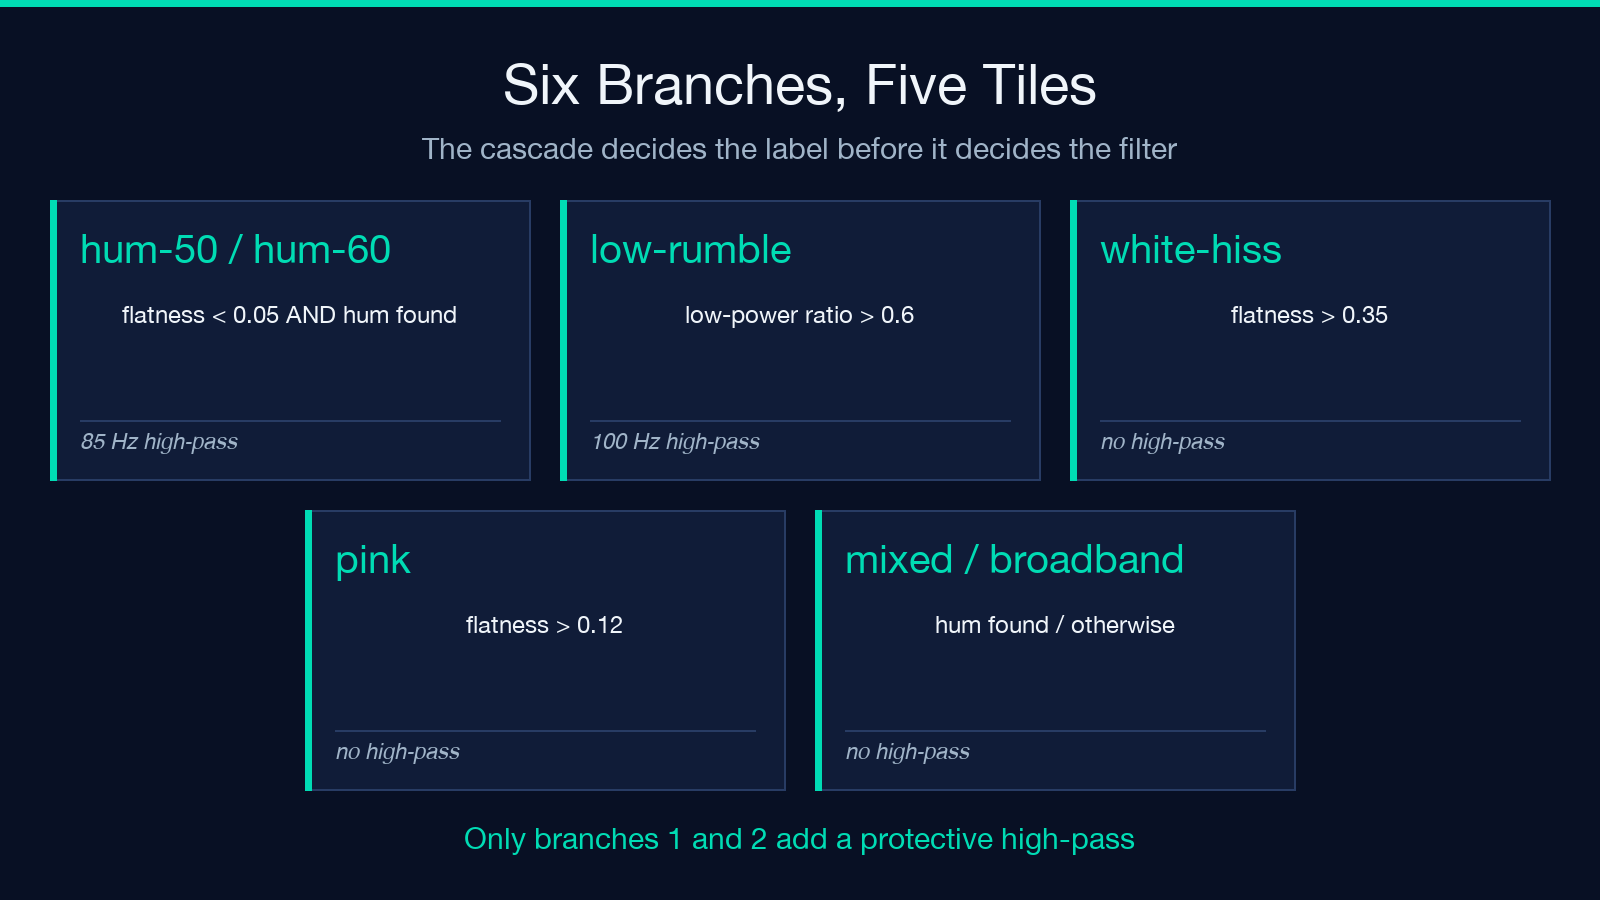
第一分支:如果找到交流声基频,且频谱平坦度低于 0.05,标签就是 hum-50hz 或 hum-60hz,取哪个看检测到的是哪个基频。
第二分支:如果低功率占比超过 0.6,标签是 low-rumble。
第三分支:如果频谱平坦度超过 0.35,标签是 white-hiss。
第四分支:如果频谱平坦度超过 0.12,标签是 pink。
第五分支:只要存在交流声基频,标签是 mixed。
第六分支:以上都不成立,标签是 broadband。
这个顺序带来的后果,看标签名字看不出来。交流声分支排第一,听起来很照顾它,可它的门槛是平坦度 0.05,这个门槛太低。平坦度接近 1.0 意味着频谱完全平坦,叠在平坦底座上的交流声再怎么加也压不到 0.05。
隆隆声分支排第二,大多数交流声都是被它截走的。50 或 60 Hz 的音调必定落在中心频率低于 125 Hz 的三分之一倍频程频带里,交流声加的功率正好加进低功率占比统计的那些频带。交流声一旦大到有影响,先越过 0.6 的是低功率占比,标签就成了 low-rumble,不再是 hum-60hz。
只有当交流声强到把平坦度压到 0.05 以下,交流声分支才终于开火。顺序就是:中段归隆隆声,尾巴留给交流声。
所以标签取决于交流声有多响,这个规律不合直觉。宽带底座上轻微的交流声被叫作白噪声嘶声,中等强度的被叫作隆隆声,响的才被叫交流声。
分类器从来不会先问那个显而易见的问题,也就是有没有检测到交流声,它得先问完另外三个问题才轮到。我测到的一个例子里,工具拿到了正确答案,然后没有用上它。
这是设计者能想明白、用户看不见的行为,所以档案必须自带证据。藏在优先级队列里的测量值,就是永远不会被你检查的测量值。档案的存在就是为了解决这件事,大体上也确实解决了,只有一个我能复现的缺口。
藏住已记录交流声的那个标签
具体故障是这样的,值得说准确,因为其中每一个单独的数字都没错。
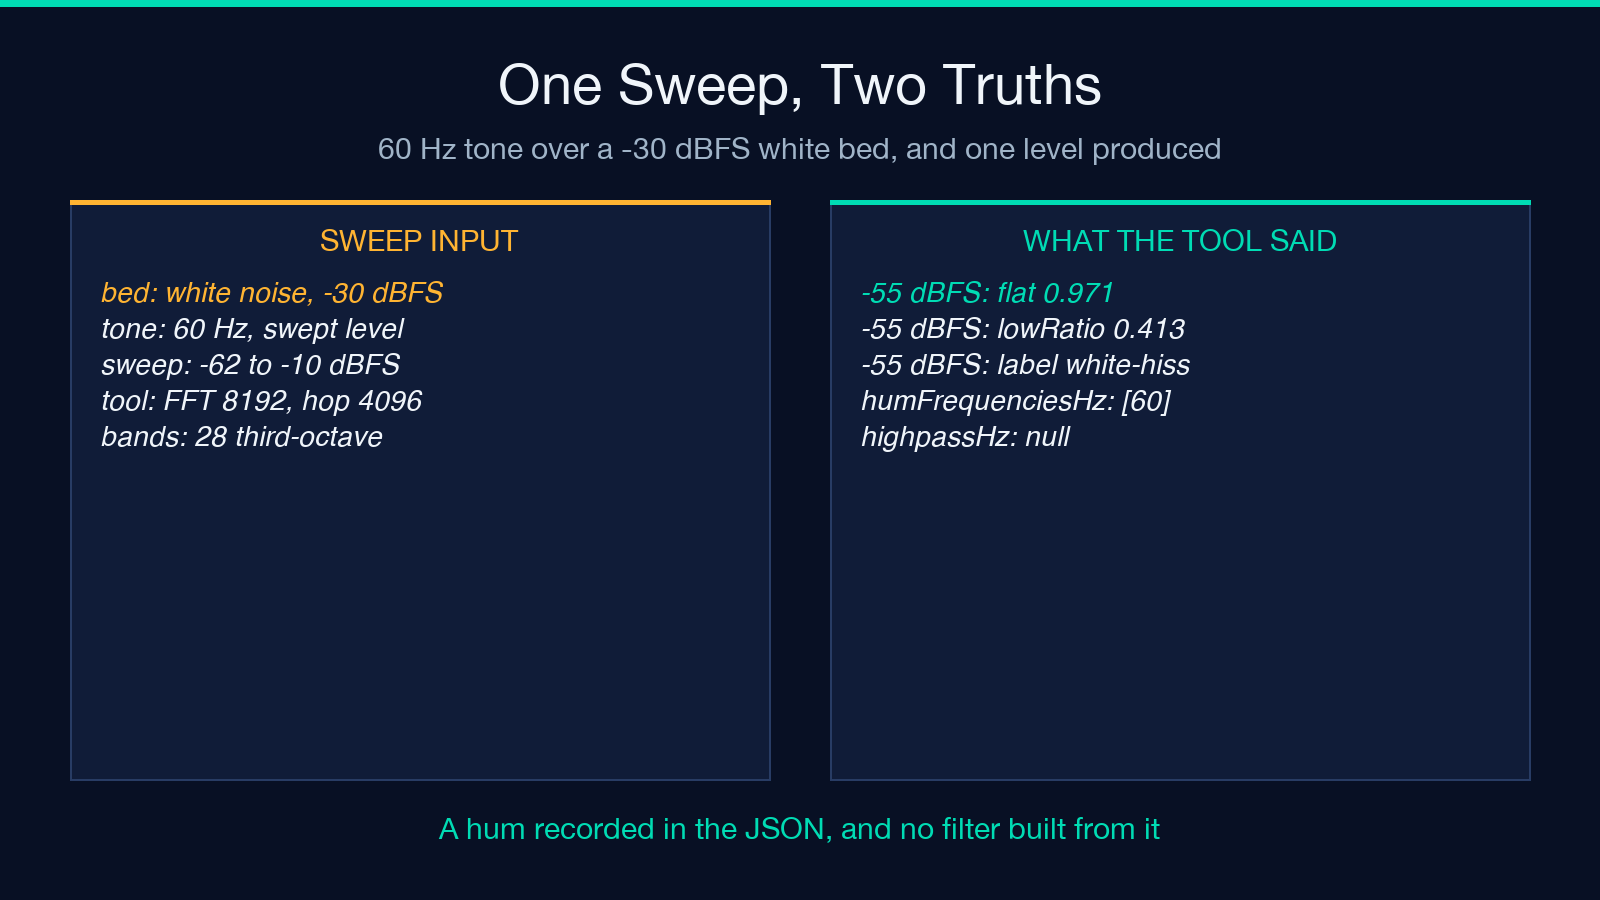
我按工具自己的实现重建了测量链,把 60 Hz 音调扫过白噪底座,底座固定在 −30 dBFS,音调从 −62 dBFS 往上加。复现逐项对齐:8192 个采样的周期 Hann 窗、4096 采样步长、跨帧平均功率谱、31.5 Hz 到 16 kHz 的 28 个三分之一倍频程频带,以及相同门限的同一组 Goertzel 探测。源码里低带截止点设在 125 Hz,隆隆声判定就是从这里开始的。
音调电平为 −55 dBFS 时,档案给出的结果是:平坦度 0.971,低功率占比 0.413,标签 white-hiss。因为 white-hiss 既不是交流声标签也不是隆隆声标签,推荐的高通是 null,降噪链路里也就没有高通。
同一时刻,档案记录着 humFrequenciesHz: [60]。Goertzel 探测找到了这声交流声。60 Hz 的基频比参考高出 10 dB 以上,于是被写进 JSON,显示在元数据里。测量数据里有一声交流声,还有一个并不存在的滤波器。
档案里既有记录下来的交流声,也有一道并不存在的保护性滤波器。测量躺在文档里,从测量得出的结论没有。
工具没有把交流声判错,它把补救措施判错了,因为本该处理这项测量的分支始终轮不到。JSON 里每个数字都是对的。
决定你的音频会遭遇什么的,只有标签。只看标签的审阅者会完全漏掉这个毛病,看一眼交流声列表的人一眼就能抓到。这个差别,就是把档案当文档而不是当判决书的全部理由。
这个边界很窄,但不是刀锋。扫描在 −60 和 −55 dBFS 两档都复现了这个结果。到 −50 dBFS,低功率占比越过 0.6,标签变成 low-rumble,这个标签是有 100 Hz 高通的。交流声被记录、却不加高通的窗口,大致就是这两点之间那 10 dB 的区间。
这个窗口落在交流声本身轻到几乎听不见的位置。举例来说,−30 dBFS 底座下 −55 dBFS 的交流声,比底座低 25 dB,所以贴错标签也能躲过认真听的人。要看出问题,你得拿原始档案去对标签,而答案早就在工具放好的那份档案里。
档案里存了什么
工具输出的 JSON 是一份小而具体的文档,依赖它之前值得弄清里面装着什么。
档案里有版本号、源文件时长、你选的区域边界、RMS 电平、峰值电平、噪声底、频谱平坦度、低功率占比、分类结果、检测到的交流声频率列表、28 个三分之一倍频程的频带电平(含中心频率和以 dB 计的功率),还有一个推荐滤波器对象,里面装着降噪量、噪声底参数和高通频率或 null。频带表从 31.5 Hz 到 16 kHz,共 28 个三分之一倍频程中心,边界按 2 的六分之一次方划分。中心频率依次是 31.5、40、50、63、80、100、125 Hz,之后从 160 Hz 起按标准三分之一倍频程步进上去。
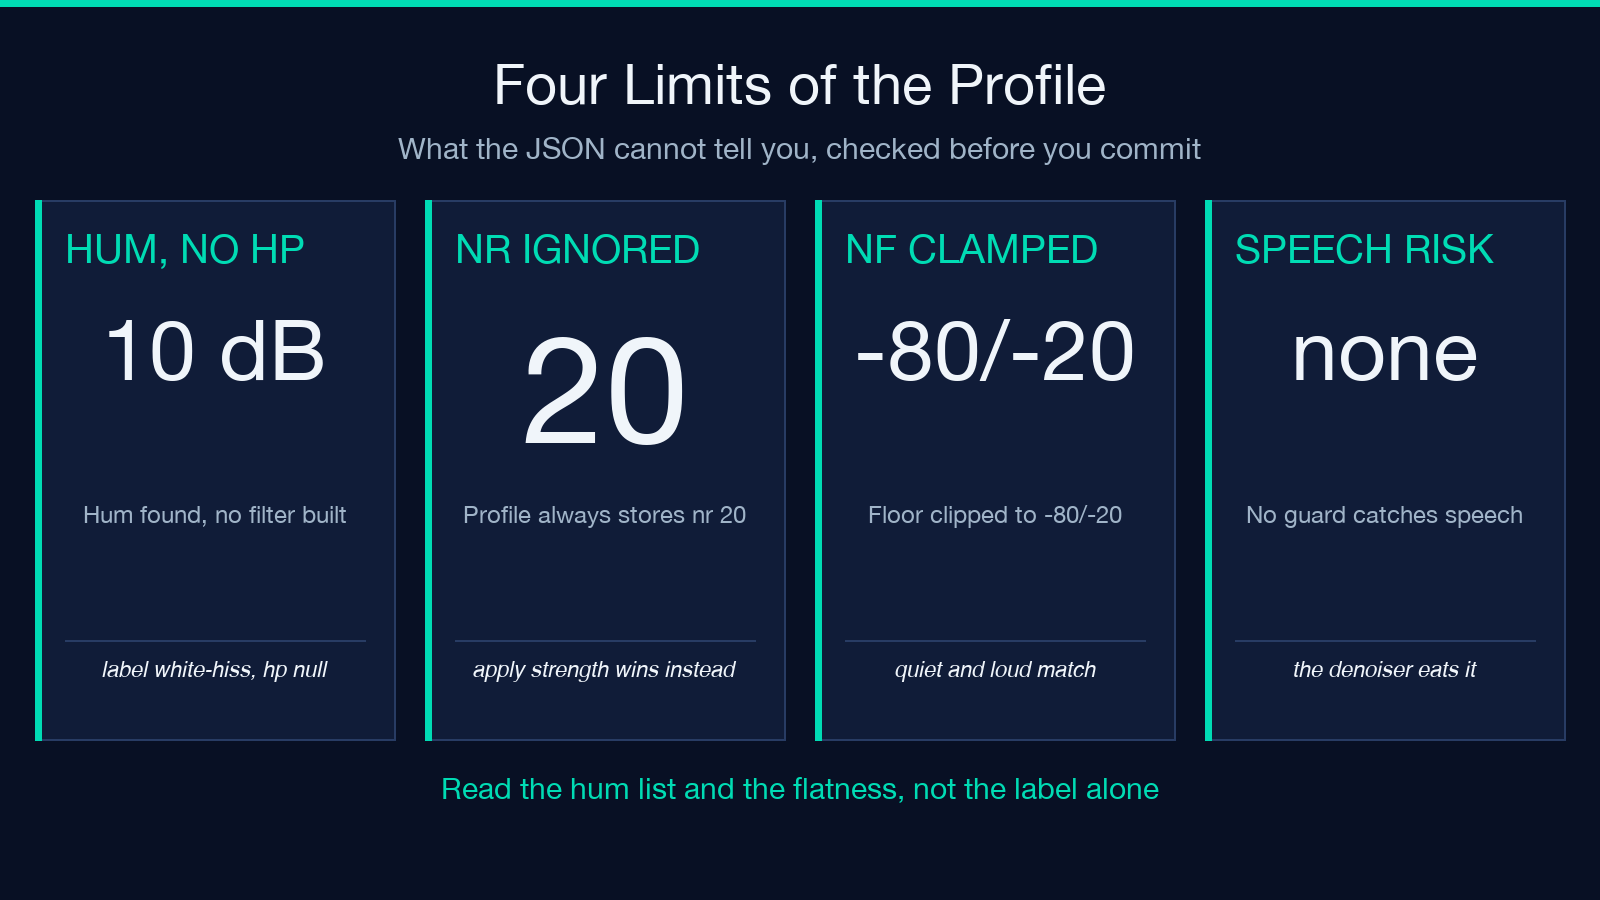
第二个问题藏在那个推荐滤波器里。里面的 nr 值永远是 20,提取那一刻写死成标准强度,不管你选的是哪一档。之后加载这份档案去处理别的文件时,链路按你当前的强度选择重建:轻 12、标准 20、强 28。全程活着回来的只有 nf,也就是测到的噪声底。
所以你用「强」提取一份档案,降噪量 28,存下来给本次会话后面用,JSON 里写的却是 20。之后你还用「强」去应用,得到 28,数字对了,这只是因为你又选了「强」。同一份档案改用「轻」应用,得到的是 12。文件里那个数从来没被查过。也就是说,一档强度下存下的档案,无法记录它将被以什么强度应用。
工具报告它测到了什么、推荐了什么,偏偏漏掉记录你要求了什么的那一个字段。这个遗漏比看上去严重,因为存档正是复用路径的全部意义。工具自己对 JSON 的说明是:"load it with apply-profile mode to denoise any file from the same environment."
链路确实会从档案的推荐滤波器重建,只是重建得只有一半。重建出的链路是 afftdn=nr=<strength>:nf=<measured floor>,标签要求时在前面加一道高通。噪声底被信任,降噪量被覆盖。
如果你需要跨批次的审计记录,强度得自己记,文件不会替你记。
三种模式,以及拦住坏区域的校验
工具提供三种模式,它们之间的差别,就是测量、清理和复用之间的差别。
提取并降噪是默认模式。它测量圈定区域,按测量结果构建滤波链,再通过 FFmpeg 的 afftdn 滤波器渲染出整份文件的降噪副本。默认输出 24 位 WAV,也可以选 FLAC。
仅提取只把指纹写进 JSON 文件,不碰音频。想在一场录音之前先把房间测一次、只要文档不要清理时,用这个模式。
应用档案加载之前存下的 JSON,用它给任意文件降噪。链路按档案里的推荐滤波器重建,原始分类会在元数据里回显,模式记为 apply-profile,这样事后能分辨某份输出是哪条路径产生的。
强度映射是轻 12、标准 20、强 28,作用在 afftdn 链的降噪量上。它在构建链路时才应用,不在测量时应用,这正是存档里的数字和输出里的数字会不一致的原因。
还有一个参数值得留意,因为它会被夹紧。交给 afftdn 的 nf 是测到的噪声底,会被夹进滤波器 −80 到 −20 dB 的有效范围。因此 −95 dBFS 的区域传进去的是 −80,−12 dBFS 的区域传进去的是 −20。测量值不是被悄悄丢掉了,但它落在滤波器接受范围之外时,也不是原样传进去。
换句话说,安静的房间和吵闹的房间可能得到同一个滤波设置,输出能在输入基础上改善多少也就被限住了。夹紧保护了滤波器,同时也给安静录音能挣到的收益封了顶。
工具还会直接拒掉几种输入,每一次拒绝都带着线索,说明什么样的档案才有用。校验会拒掉过短的区域、过长的区域、过长的文件、静音的区域。边界是:最短 0.5 秒、最长 30 秒、文件最长 10 分钟、最低 −70 dBFS。区域短于 0.5 秒,报错信息是 "The noise region must be at least 0.5 s long - pick a stretch of pure noise." 区域长于 30 秒,报错是 "shorter honest regions profile better than long ones." 文件超过 10 分钟,报错是 "Audio is 11 min - the profile extractor analyzes up to 10 minutes."
还有两条最影响准确度的校验。如果你所选区域的实测 RMS 电平低于 −70 dBFS,工具会拒绝,报错是 "The selected region is (near) digital silence - a noise profile needs an actual noise floor." 挑一段噪声听得见的区域。
而你如果喂进去一段含人声的区域,没有任何校验会拦,因为没有校验拦得住。工具自己的描述说得很直白:含人声的区域会被当成噪声,降噪器会把说话声吃掉。
最后这一条最该记在心里。别的拒绝都是工具能替你执行的规则,这一条它执行不了。
它也是后果最糟的一条,因为用说话声建出来的档案不只是偏了,它是有破坏性的。它把说话声当噪声测量,学到它的噪声底,然后把整段录音后面所有像人声的能量一并削掉。
操作顺序在这里同样重要。先测量,测量是必须对的那一环。清理位于下游,依赖的是你挑对那两秒写出来的文档。没有校验能替你重建这份文档,也没有滤波器能撤销一份坏的。
复用路径什么时候值回成本
值得存档案、而不是每次都重新推导,理由在于测量是房间的属性,不是文件的属性。
房间有它的噪声底,也有它的交流声,后者取决于照明回路、空调和供电走线。只要在同一地点、用同一套设备录,每条都带着同一份交流声。磁带有一成不变的嘶声,同一盘磁带走几遍都是它。话筒和前置放大器有自噪声底,几次录音之间不会漂移。
房间声学的研究从另一头得到同样的结论:固定的噪声源最好按固定源去除,别按文件去猜。举例来说,在磁带嘶声底座上测到的 −62 dBFS,应该用在同一盘磁带的每一遍上,而不是每一遍各自猜一个。复用档案,是把一连串猜测换成一条测出来的事实。
能值回成本的工作流是这样。用同一支话筒、同一位置、同一增益,录两秒空房间。提取档案,存下来,然后把这一份档案用在本次会话的每一条上。
你不是在逐份独立降噪,你在从多条录音里减去同一个已知环境。复用路径存在的意义,就是让这个环境只被测一次。
这也是这个工具的兄弟工具都在同一族里的原因。如果你追的是一个特定的音调杂音、不是宽带噪声底,电噪音去除 直接对准市电成分。如果你要做的是加而不是减,有声书环境音插入器 走的是反方向,把室内本底铺进一段本来没有的录音里。如果要通用方案而不是针对性方案,降噪 是更宽的那个滤波工具。
每一种覆盖一种不同的失效模式,选对兄弟工具可以省掉一整轮取档案再检查的工作。举例来说,被提取器标成 white-hiss 的 60 Hz 交流声,更适合交给电噪音去除,因为出错的正是在这条档案路径上。
要拿素材来试,Elysia Tools 上的 WAV 示例集 提供五种未压缩 PCM 音频,包括瀑布环境声和已经混入室内本底的冥想曲。瀑布录音是个好用例,宽带水声和嘶声那一类非常接近。冥想曲有用是另一个原因:它的噪声底平滑、没有瞬态,正好能看出滤波器会不会把低电平内容吃掉、把真实信号留下来。
诚实地读这份档案
实用版的说法很短。圈一段只含噪声、不含别的东西的区域,长度要够有意义,又不能长到失真。然后拿标签去对旁边的数字。
档案写 hum-60hz,你得到 85 Hz 高通,因为这是两个会触发保护性滤波器的标签之一。写 low-rumble,你得到 100 Hz 高通。写 white-hiss、pink 或 broadband,你完全没有高通,这时就该自己去查交流声列表。要是 humFrequenciesHz 不为空、标签却写着 white-hiss,那就是上面说的那个缺口,正确做法是自己在链路里加高通,别信自动那一道。
下决定之前还有两个数字该看一眼。频谱平坦度接近 1.0,说明这段区域基本是完全宽带的,白噪声嘶声是这样,一个上面压了大量嘶声的纯音调也是这样。低功率占比超过 0.6,说明大部分能量在 125 Hz 以下,不管工具有没有选这个标签,这都是隆隆声的特征。
举例来说,平坦度 0.97、交流声列表里写着 60 Hz,意思是频谱还平着,交流声已经高过邻居,而这恰好就是不会产生高通的那种情况。这项检查只要一行,补上的却是自动路径留下的缺口。
值得带走的那个问题,跟降噪器有没有把你的文件弄干净无关。它问的是你据以做判断的那份文档,描述的到底是不是你遇到的噪声。工具测得好,标签大体上也对,可标签是一条判定链的摘要。摘要这种主张,可以在平均意义上正确,却在你这间屋子里错掉。实际做法上,修它只要一行检查,不修的代价是一道永远不到的高通。
接下来往哪儿走
这个工具是一台附带清理功能的测量仪器,测量那一半才有意思。它产出的是小而可审计的文档:以 dBFS 计的噪声底、一个平坦度、一个占比、一份交流声频率列表,还有一组频带电平,可以拿去和你耳朵的判断对照。这份文档才是耐用的资产,降噪后的 WAV 只是它的副产品。
值得记住的坑,跟这个工具有没有毛病无关。它在于:正确的测量和正确的结论是两件事,而这个工具是从优先级顺序推出结论的,不是直接从测量值推。
交流声被一项专门探测抓到,门限比邻近高出 10 dB,然后这项探测只被排在第三位的分支查阅。测到的和你想的一样,被处理的是判定链先碰到的那个。
想亲眼看这些数字,噪声样本提取器 会把完整 JSON 交给你,Elysia Tools 上的更大目录覆盖了音频工具集的其余部分。
下次降噪器给出你没预料到的结果时,有用的动作就是档案邀请你做的那个:别再跟标签较劲,去读旁边的测量值。说到底,要紧的不是工具有没有把你的文件弄干净,而是你据以做决定的那份文档,描述的是不是你遇到的噪声。
