
一份补位导出的三行内容。解析器按我设定的方式切开了:每个值都落进正确的字段,什么都没丢,也没有报错。报告上的有效行数却是 0。接着我给一个名字多打了一个字符,同一个解析器就把整份文件的某一列改了名,两个字段并成一个。异常计数只动了一格。定宽解析的陷阱就在这里:报告给出的长度数字,你读成了数据数字。
我把这个解析器 247 行的 TypeScript 源码移植到 Node,先复跑了它自己公布的两个示例,确认移植没有走样。两个都对上了:显式模式示例得到 rows.0.NAME = Alice、rows.1.SCORE = 87、anomalyCount = 0;推断示例得到 schema.0.name = CODE、rowCount = 2,另有 1 条 extra-data 异常。下面写的东西都来自这个移植版的复跑,不是读着说明文档猜的。
换单位,就是换表结构
工具里有个 positionMode 选择器,两个取值:characters 和 utf8-bytes。看着像偏移量的显示偏好,其实不是。它决定列在哪里存在。
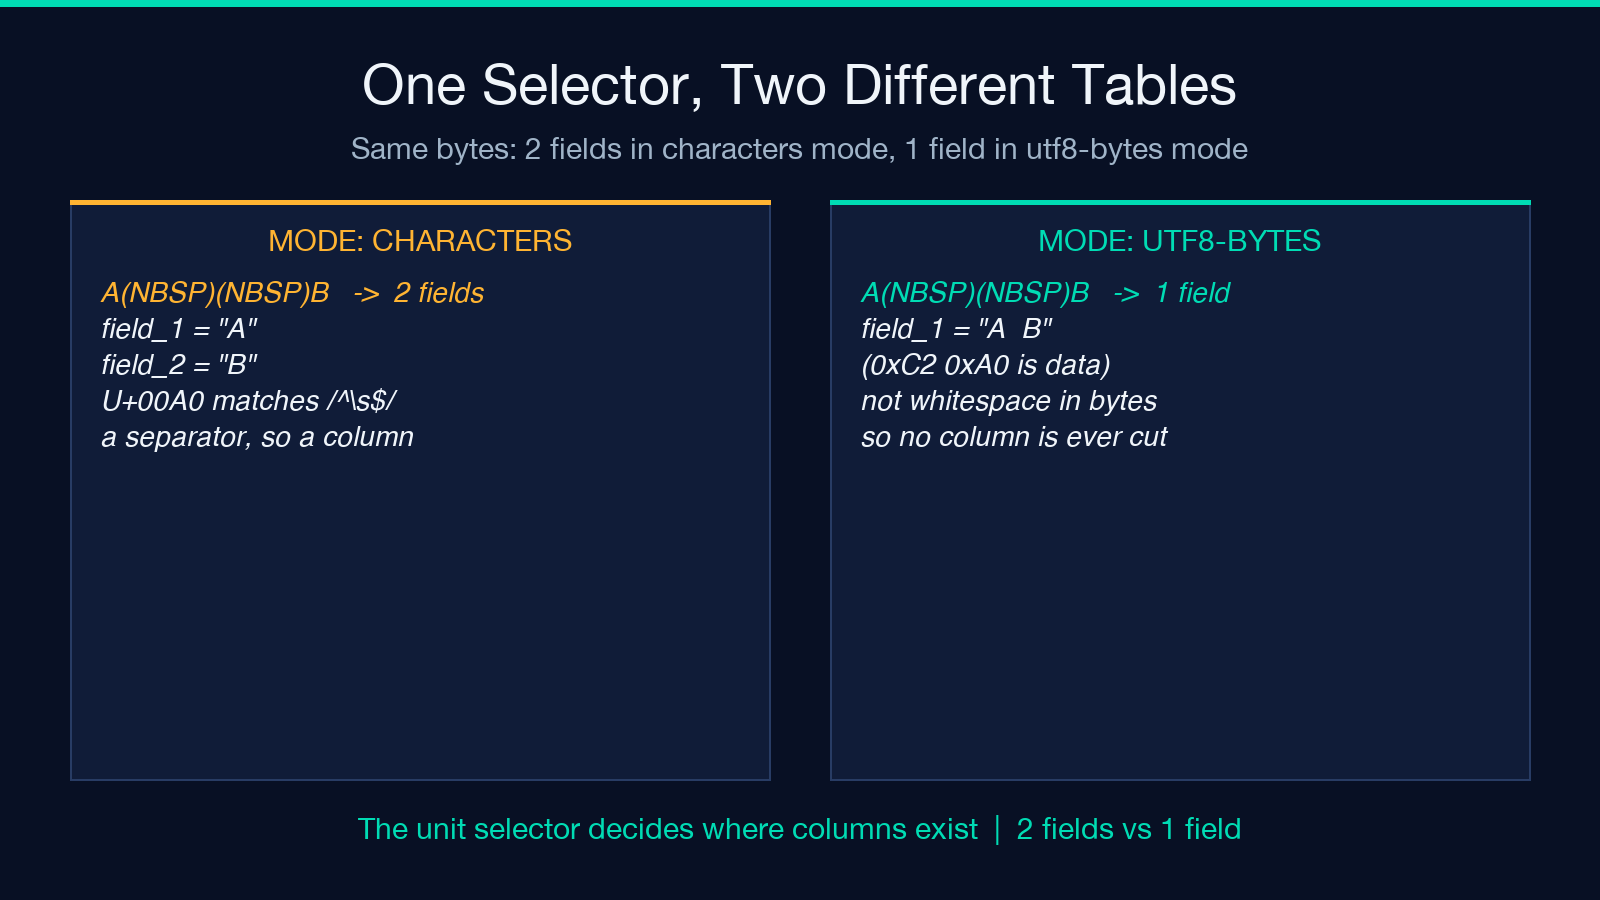
拿两条用不间断空格而不是普通空格补位的记录,A<U+00A0><U+00A0>B 和 C<U+00A0><U+00A0>D,不开表头直接跑:
characters返回 2 个字段。行结果是{field_1: "A", field_2: "B"}和{field_1: "C", field_2: "D"}。utf8-bytes返回 1 个字段。行结果是{field_1: "A<U+00A0><U+00A0>B"}和{field_1: "C<U+00A0><U+00A0>D"}。补位空格还留在值里面。
同样的字节,同一个文件,两张不同的表。原因在空白判定上,代码写了两份。字符模式下是 /^s$/,JavaScript 的 s 高高兴兴就匹配了 U+00A0 和 U+3000。字节模式下只认四个字节值:9、10、13、32,别的都不算。U+00A0 占两个字节,0xC2 和 0xA0,两个都不在那个列表里。于是一列不间断空格在一种模式下是分隔符,在另一种模式下是数据本身。
这件事要紧,因为文件只要经过表格软件导出、Word 表格或 PDF 转文本这类环节,补位用的往往就是不间断空格。屏幕上两种补位长得一模一样。只有单位模式知道区别,它却不会告诉你自己做过选择。
三字节的字符没有中间
字节模式还意味着字段边界可能落在字符内部。01 東京 99 这行是 8 个字符、12 个字节。切第 3 到第 9 个字节,拿回来的是干净的 東京;切第 3 到第 8 个字节,得到 東 加一个 U+FFFD,也就是替换字符。
不抛异常,不记异常计数,validRowCount 仍然把这一行算作有效。U+FFFD 是完全合法的字符串,于是它作为城市名流进数仓,任何维表都匹配不上,你唯一的发现途径是一次静默返回空结果的 join。举例说,東� 在任何数据库里都 join 不到 東京,按行做的长度检查也看不出这个差别。
另一头也有同样的算术。01 😀 98 是 11 个码点、12 个 UTF-16 单元、14 个字节。解析器在字符模式下数码点,这个 emoji 算一个位置。数据库的 LENGTH() 大概又是另一个答案。「这一列有多宽」因此有三个都说得通的答案,文件不会替你挑一个。
一个过长的值能改掉整张表的列名
这个缺陷值得放进 PPT。列推断逐个位置往下走,只问一个问题:这个位置在每一行上都是空白吗?只要有一行的值伸进了分隔符,答案就是否,分隔符对整份文件都不再存在。注意「整份」这两个字的分量。一行出错,另外一千行的表结构(schema)一起失效。
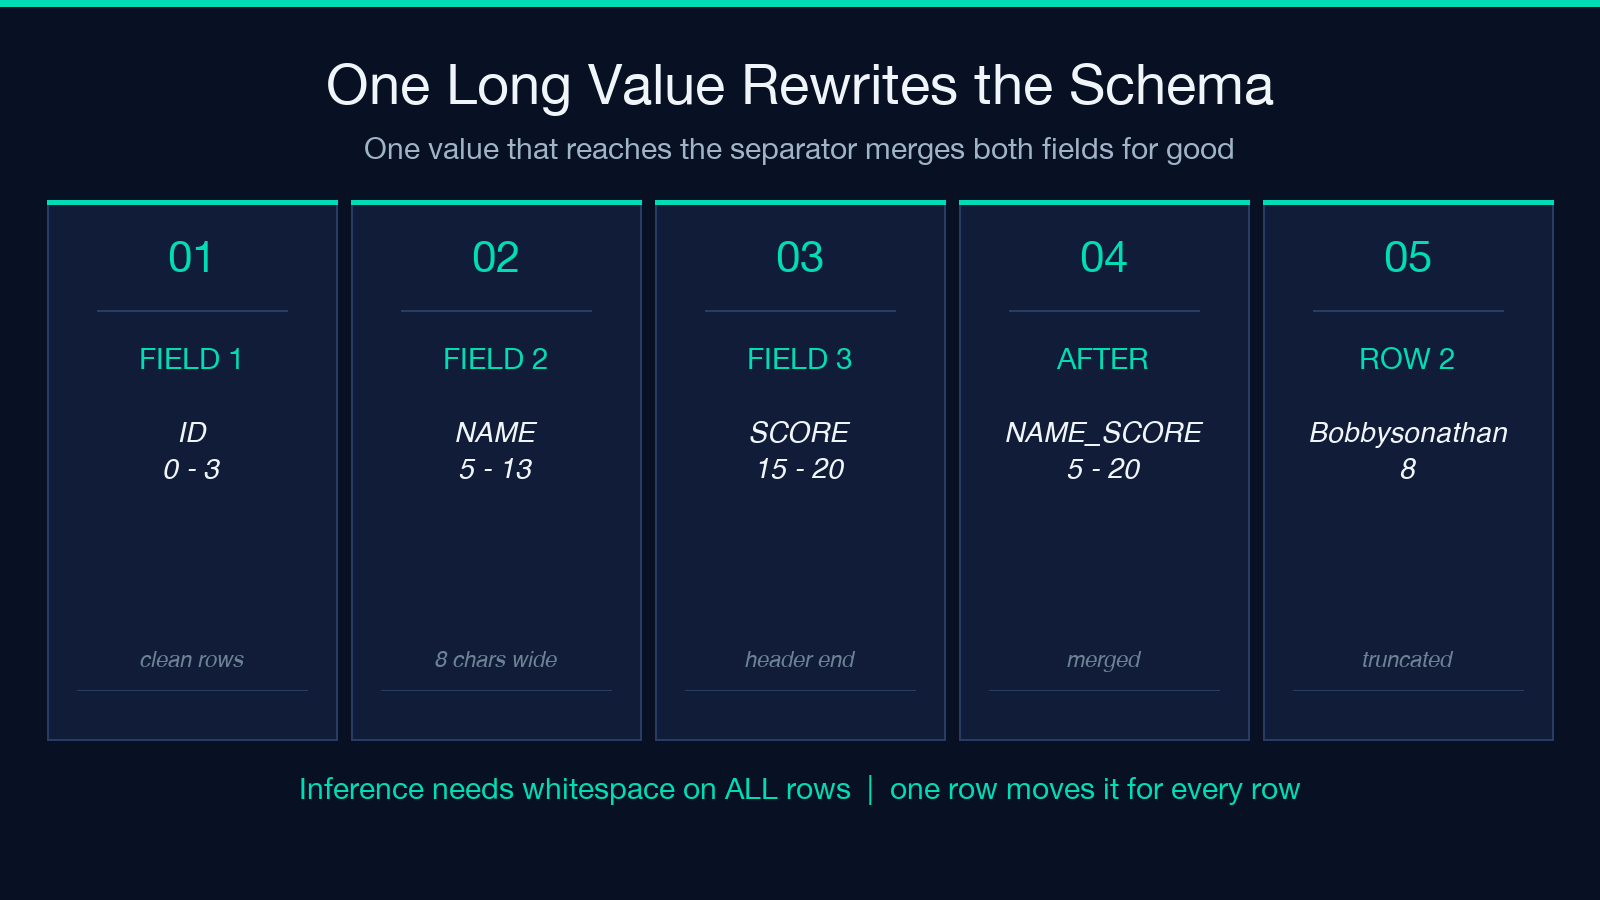
先看表头 ID NAME SCORE 和两条记录 001 Alice 98、002 Bobbysonathan 87。第二条记录里的名字超出了列宽。推断只返回两个字段,不是三个:ID 从 0 到 3,然后 NAME_SCORE 从 5 到 20。表头改名器把 Alice 98 整个切成一个叫 NAME_SCORE 的字段,第二条记录变成 Bobbysonathan 8。
输出 JSON 里的列名,取决于输入里最坏的那一行。下个月多进来一个九字符的姓氏,下游所有映射键全变,只记一条异常,没有东西提醒你表结构本身挪了位。九字符只是录入上的变化,跟表结构无关,解析器分不出这两者。
最后一列的宽度由表头决定
勾上「首行为表头」,推断量的是表头那一行的宽度,并把它当作整行总宽,取的不是最宽行。
于是表头 ID NAME 配一条记录 001 Alice,最后一个字段的范围是 5 到 9,取到 Alic,再加一条 extra-data 异常,因为这一行有 10 个位置,10 大于 9。一张再普通不过的表,同时被报告为数据被截断和存在多余数据。
把这两个字段对一下:字段范围 5 到 9,取出 Alic,承诺的是 Alice。第五个字符在任何输出里都没出现,它被当成多余数据报了出来,不是一个被截断的名字。
取消勾选,同样的字节给出不同答案:总宽变成 10,最后一个字段是 5 到 10,值是 Alice,那两条长度抱怨变成 short-row。这个勾选框改的不只是列名,它改的是抽出来的内容。
validRowCount 数的是补位空格
回到开头那三行。表头 ID NAME SCORE,记录 01 Ann 98 和 02 Bob 87。两条记录都解析得很干净:Ann 和 Bob,98 和 87,没有截断,没有替换字符。
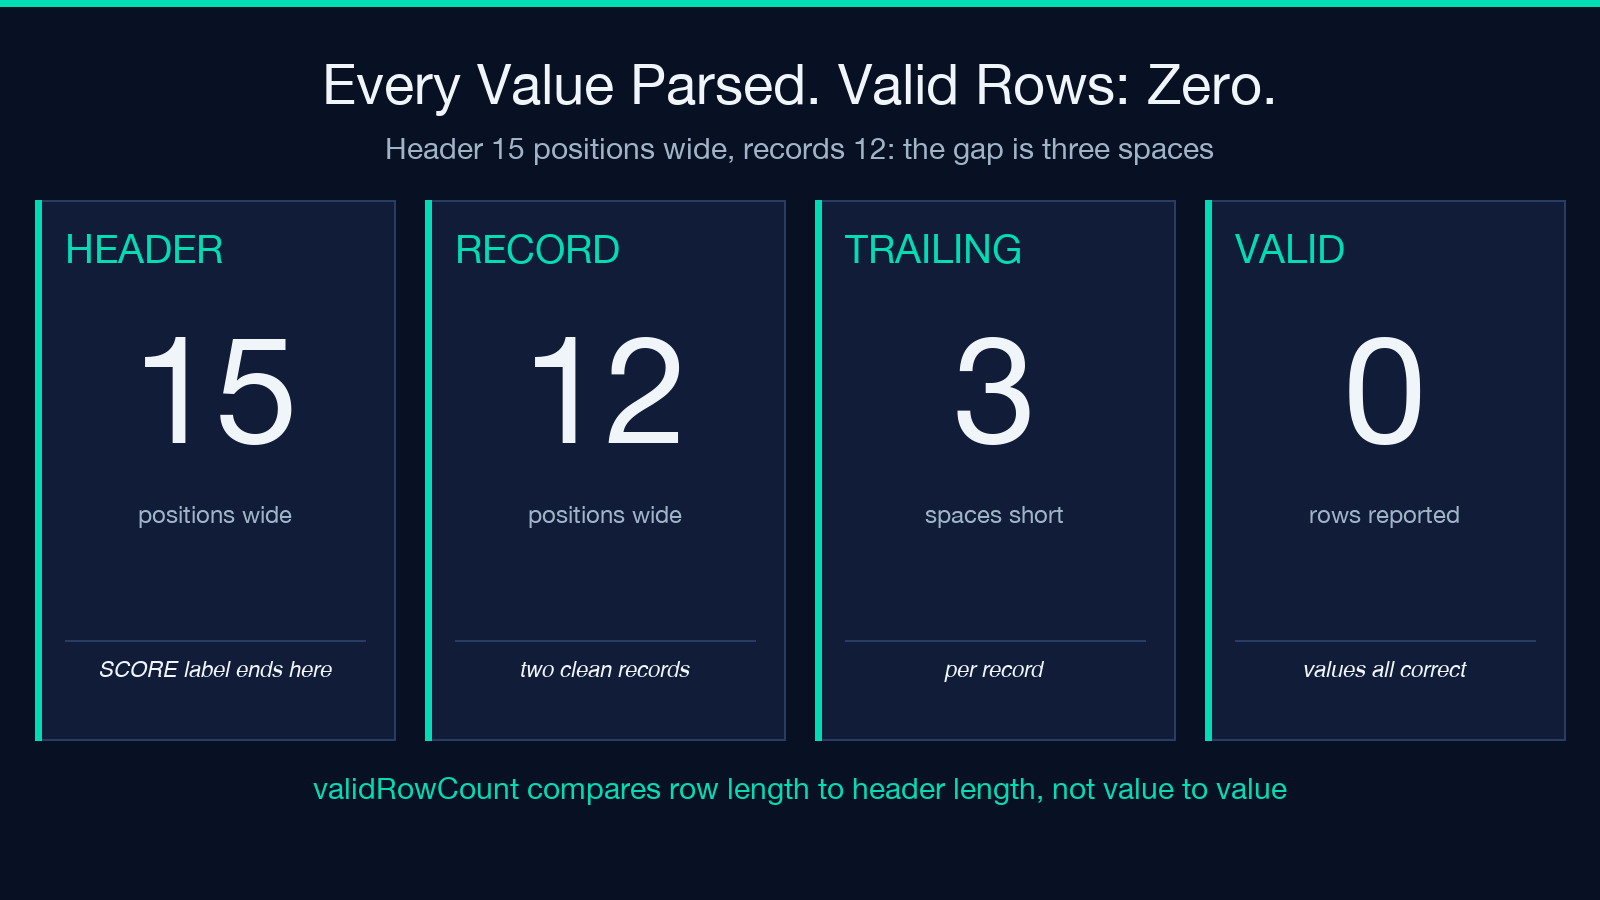
expectedLength 取最大字段终点,这里是 15,因为表头的 SCORE 标签到 15 结束。两条记录都只有 12 个位置,都被标成 short-row,validRowCount 是 0。
数据本身没毛病。每行比表头短三个空格,「短」被定义成错误。工具自己公布的第一份示例靠把记录补到 20 个字符绕开了这件事,这做法没错,也正是把问题藏起来的习惯。把 valid: 0 挂到看板上,就有人要花一天去追一个由尾部空格约定造成的“数据损坏”。
它完全看不见的东西
有三处盲区值得记住,每一处都会以一切正常的样子交付。
过长的值只要没超出整行总宽,就会被悄悄截断。某条记录的名字溢出字段、整行长度却刚好合规,异常数是零,值在字段边界被切断。长度检查针对行,截断发生在字段,两者只有一项被量到。
只有回车符的文件永远不会被拆行。代码只归一化 rn。纯 CR 的导出(一些老系统至今还在产出)整份变成一行,500 条记录解析成一行一列,没有任何异常指出原因。
制表符分隔的文件也会被接受。制表符是字节 9,字节 9 就在空白列表里。把制表符分隔的表头喂给它,field_2 返回的是字面字符串 NAME<TAB>SCORE,因为各条记录里的制表符位置对不齐。用错工具,拿回来的是一张看着像样的表,不是报错。
还有一处单位错配,出在防护层而不是解析器里:10 万字符的输入上限用 text.length 判断,它数的是 UTF-16 单元,内部的测量却数码点。六万个 emoji 就是六万个字符、十二万个单元,于是这份输入明明舒舒服服待在标称上限之内,却被判定超长而拒收。
一份你守得住的表结构
推断是图省事。凡是按计划定时跑的作业,都该切到 schema 模式,把范围写死。
范围是半开区间,起点含、终点不含,只有这种约定能让 0..5 和 5..15 首尾相接不留缝。校验器会拒绝零或负的起点、终点不大于起点、超过 100 个字段,以及任何重叠。它还会静默地按起点排序。排序意味着输出的键序跟着字节位置走,不按你在 JSON 数组里敲的顺序,所以写成 score, id, name 的 schema 回来是 ID、NAME、SCORE。
从表头取来的字段名要过一个清洗器,依赖它们之前得先知道规则。Order ID 变成 Order_ID,连续空白换成单个下划线。Qty (ea) 变成 Qty_ea,括号被丢掉。ID # 变成 ID_,尾部下划线留着,这种细节足以打断一份严格的列清单。单独一个 # 会塌成兜底的 field_1。两个文字相同的表头单元格变成 ID 和 ID_2。ASCII 之外的字母能活下来,欧元符号也不例外。
补位也要明确表态。trimValues 默认打开。关掉它,001 会保留尾随空格:补位本身有意义时这正是你要的,要拿这个值去比对键时就正好不是。
在这些问题面前依然成立的确定性检查
四项检查,按收益从大到小排。
在值旁边打印每个抽出值的实测长度,单位按你承诺的那个来。行级计数看不见字段级截断,逐值长度能看见:Alic 是四个字符,你预期的是五到十二个。
在 CI 里把同一份样本用两种位置模式各跑一遍,比对推断出的表结构。两者不一致,说明文件里有非 ASCII 补位,或者有多字节字符跨了边界。这该由人在某一刻做一次决定,不该变成凌晨三点炸掉一个批处理的 bug。
在每条记录末尾放一个校验列,比如计数或校验和。列缺失或错位时,报出来的是点名到记录的校验失败,不是一个改了名的字段在下游三次 join 之后变成一个谜。
逐行断言输出字段数等于 schema 里的字段数,不等就让批处理失败。schema 模式让这件事很便宜,也能把静默合并这一类缺陷变成硬停。
我最初只想把行数做准。查下来发现,这个计数从来没在数数据:它数的是补位,补位恰恰是定宽文件里唯一一处可以错得没人察觉的地方。所以修法不是换一个更严格的解析器,是在自己的输出里加一列:每个值的字节长度,拿去断言你承诺的宽度。这一列存在之后,表结构就不会在你脚下乱动了。
你手上正在跑的抽取作业,有几份在把这列打印出来之后还活得下来?

Pingback: Your Fixed-Width File Has 3 Lengths, Not 1 - COSESAI