
一次语义约定改名是一行 diff;一次语义约定迁移,是跨五种文件类型的全代码库搜索,而那五种文件你可能根本不知道在自己手里。当 OpenTelemetry 的 span 从语义约定 v1.20 迁到 v1.27,大约有三十个属性名发生变化。改名表是公开的、完整的、枯燥的。不枯燥的是发现其中一半用法躺在 Grafana 仪表盘的 JSON 里、Collector 的 transform 配置块里,以及一个由你从没共事过的团队维护的 Java 服务里。OpenTelemetry 语义约定 v1.20 → v1.27 属性迁移工具存在的意义,就是把那场搜索从一周压成一次操作,并且老实告诉你哪些部分它拒绝自动化。
v1.20 到 v1.27 之间究竟改了什么
语义约定的版本节奏,独立于使用它的 SDK 和 Collector。v1.20 实际上已是 HTTP span 属性仍带实验状态的最后一个修订版。v1.23.1 把 HTTP 提升为 stable,并在同一次发布里把这个组里的名字大多换掉,因为 stable 就是名字停止变动的时刻,改名恰好发生在它被允许停下来的那一点上。v1.24.0 把数据库组推进了一步。v1.27.0 收尾消息组。
这就造出一个没人预料得到的迁移面。实践中不存在 v1.20 到 v1.27 的单次跳跃,因为团队升级 SDK 有自己的时间表,升级 Collector 又有另一张。你真正面对的是一个矩阵:三种可能的源版本、三种可能的目标版本,每一对的属性差异都不相同。只认识两端的迁移工具,会在矩阵中段默默给出错误答案,所以有用的输入是版本对,不是单个下拉框。
弄坏每一块仪表盘的五处改名
五处一一对应的改名,解释了约定升级之后面板损坏的绝大多数情况。
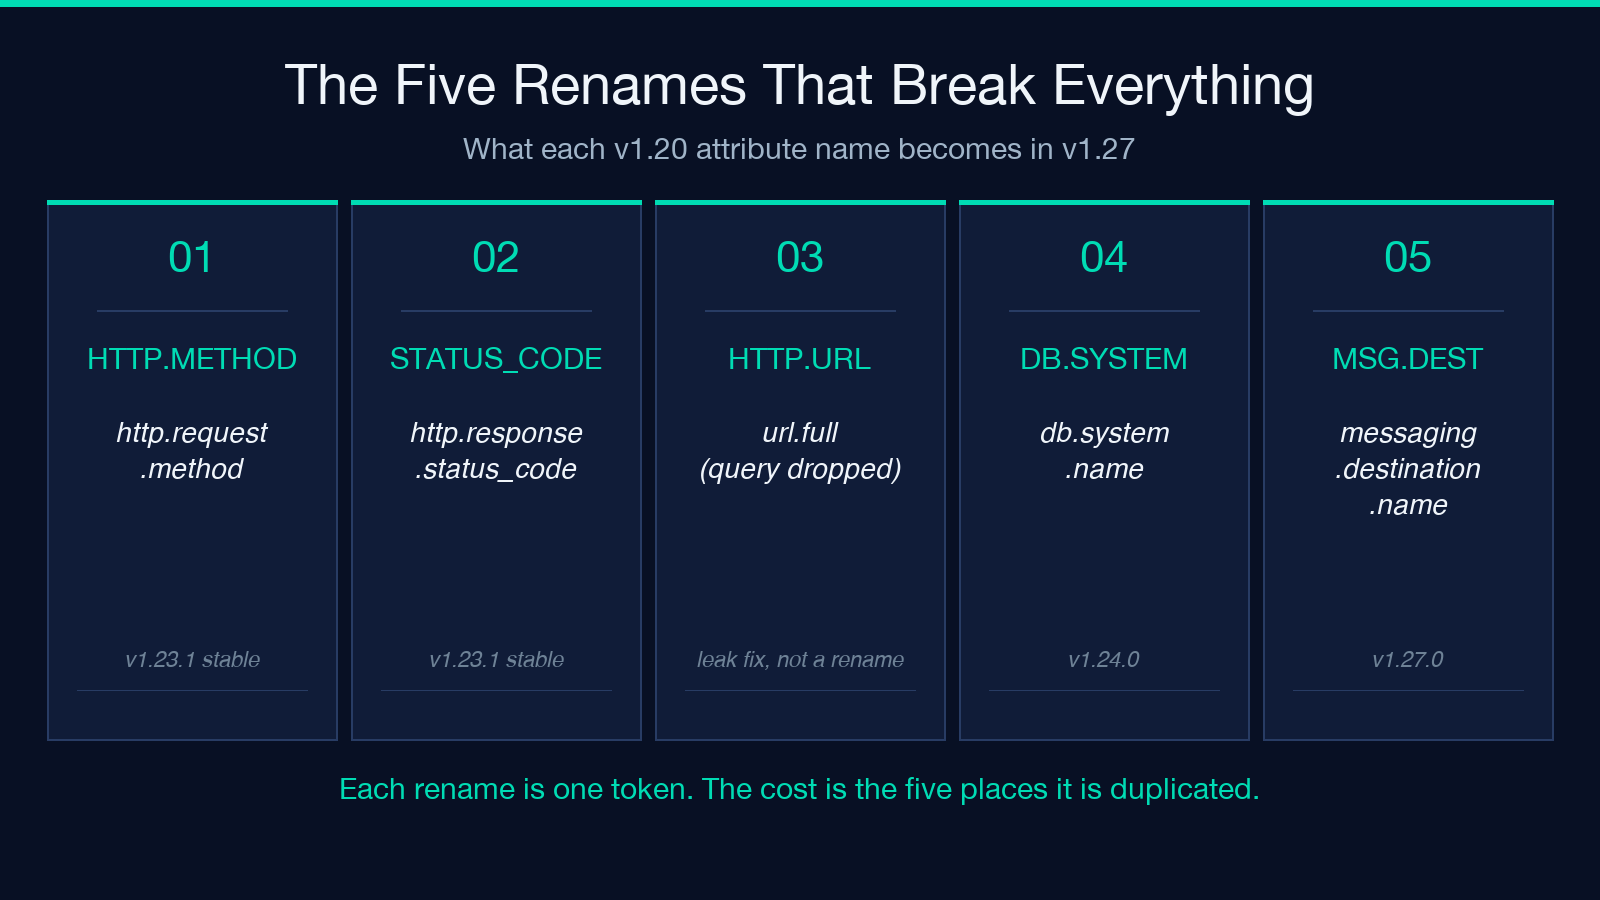
http.method改为http.request.methodhttp.status_code改为http.response.status_codehttp.url改为url.fulldb.system改为db.system.namemessaging.destination改为messaging.destination.name
每一处都只是机械操作。伤害不来自改名本身,来自滞后。一块按 http.method 写的 Grafana 面板,在 SDK 升级之后还能欢快地渲染好几个月,因为在 Prometheus 风格的查询里,属性缺失通常求值为空序列,而不报错。你会在一次事故里发现它,或者在一次容量评审里,或者从同事那句「服务延迟面板怎么一直平在零」里发现。
第二个结构性问题在于,url.full 根本不是精神上的改名。旧的 http.url 带完整请求 URL,含查询串。url.full 带绝对 URL,但不含查询串和片段,这是刻意的防数据泄漏修正。任何依赖嵌在这个属性里的查询参数的仪表盘或记录规则,就算改名成功,行为也会变。
先读 diff,再写修复
操作顺序比听起来重要得多。跑完迁移,先读逐属性的 diff 统计,再碰任何一个文件。这些统计回答一个靠肉眼绝对回答不了的问题:每个被改名的属性到底有多少处用法。
http.method 计数很高是好消息,意味着一次机械操作就能修完,评审也轻松。计数为零比计数很高更值得注意,因为它通常说明这个名字埋在抓取器默认够不到的地方,比如 Grafana 的 JSON 字符串,或者一段不在粘贴源码里的 Collector YAML。
未映射属性报告才是真正的交付物。它列出你用过的每一个没有自动映射的属性,按后文描述的三类结果分开。大多数团队会发现,真正的工程工作量在这份清单上,不在改名表上。
Collector transform 不是查找替换
每一处改名都有一个 Collector 侧的答案,而如果你第一反应就是伸手去拿它,那是个陷阱。一条 OpenTelemetry Collector 的 transform 语句,可以在摄取时用 rename_attribute 动作改名,动作写在 trace_statements 条目里,作用域是 span 上下文。它第一次就能跑通,不需要发布应用,而它建立的心智模型恰好是错的。
在 Collector 里改过名的属性,是新名字套着旧数据。你的应用源码还在发 http.method,你本地的调试会话还在显示 http.method,下一个在终端或性能剖析器里看 trace 的人,看到的名字在已发布的代码里根本搜不到。更糟的是,Collector 配置成了正确性的承重结构,于是回滚一次 Collector,下游所有地方就静悄悄地恢复了旧名字。
把 Collector transform 当作你没有权限的服务的过渡桥,而不是目的地。生成它,应用到第三方服务上,同时排期做源码侧的修复。
未映射属性才是真正的工作
工具不会自动处理的东西,全部落在三类里,类别决定它吃掉你多少时间。
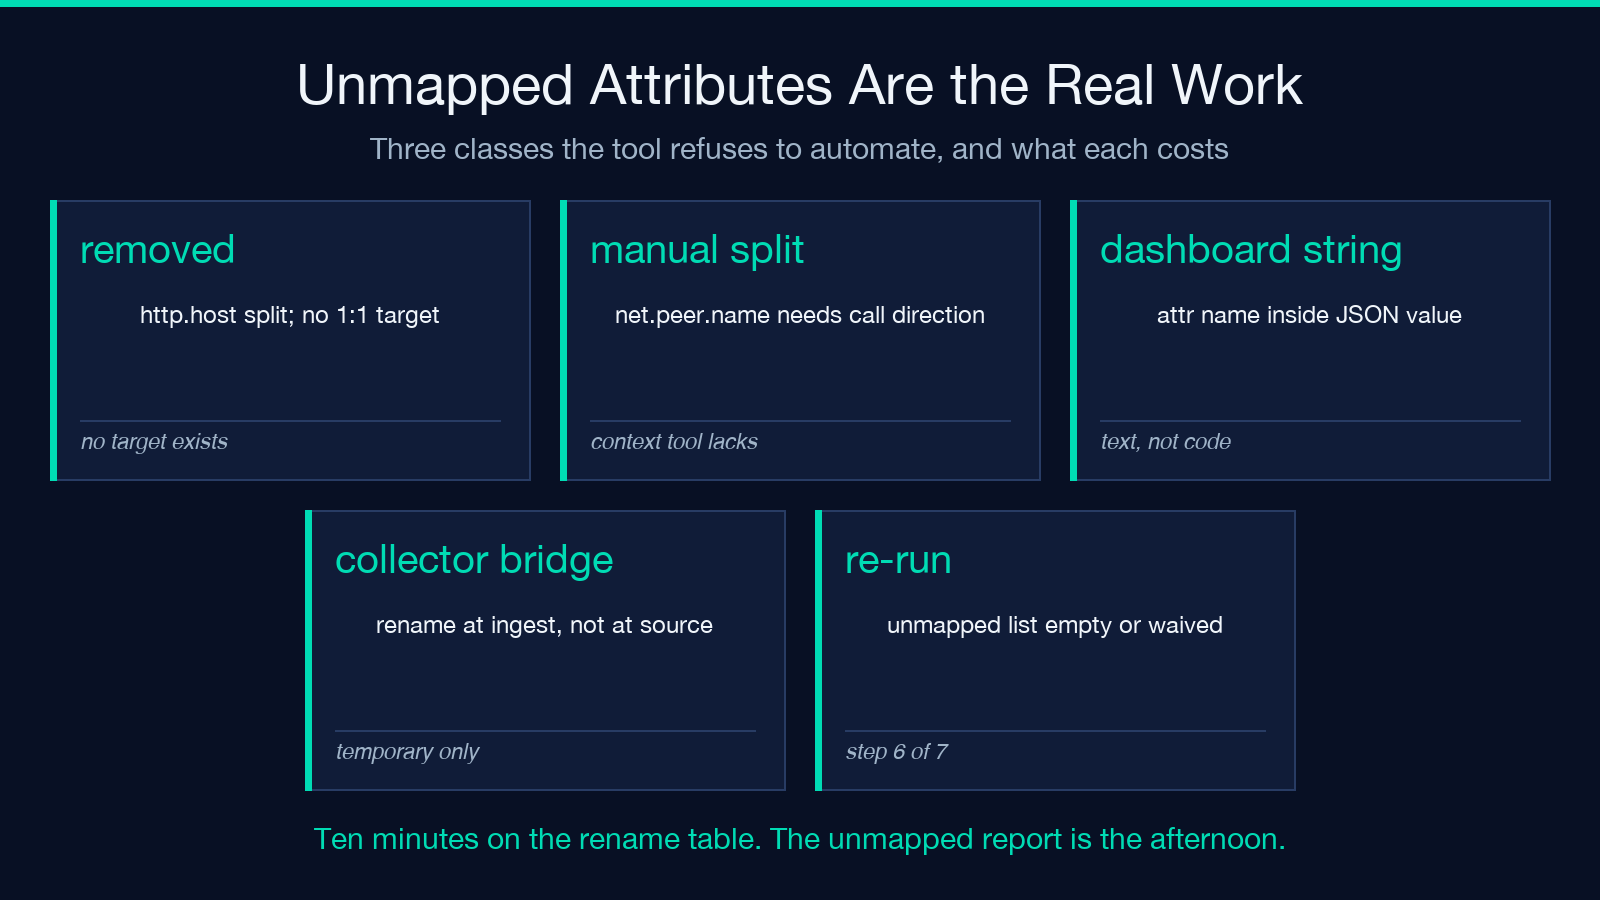
第一类是删除:有些 v1.20 属性在 v1.27 里没有对应物,因为约定作者判定这个概念定义不清或者对隐私不友好。http.host 是常见例子,它把服务器名和端口混在一起,替代方案把这个概念拆开了。这里没有唯一正确答案,所以警告是唯一诚实的输出,你得逐个服务判断这个属性是不是承重的。
第二类是人工拆分:一个旧属性变成两个新属性,任何自动工具在不知道你的拓扑的情况下,都判断不了哪一半该进哪个名字。net.peer.name 拆成客户端地址和服务器地址是典型例子,它算客户端还是服务器取决于调用方向,而这是抓取器不掌握的上下文。
第三类是仪表盘字符串:嵌在 JSON 值里的属性名是文本,不是代码,源码级改名够不着它。这是对另一批文件做的另一趟处理,也是最常被跳过的那一趟。
仪表盘也是 JSON,而且更难缠
Grafana 仪表盘把属性名至少存在四个不同的地方,只重写查询文本的迁移,仍然会留下一块坏掉的面板。
面板查询是最明显的一处。第二处是数据源覆盖块,旧名字在那里作为键出现,不是作为值。第三处是模板变量,它通常含一个匹配属性名的正则,于是匹配集一空就静默失败。第四处是注解定义,它很容易被漏掉,因为迁移时几乎没人打开它。
工具把这当成一个显式的可选项来处理:把同一张改名表应用到 JSON 字符串值内部。结构化重写 JSON 和文本重写属性名是两种操作,失败模式也不同。仪表盘进了版本库就打开它;仪表盘只活在共享的 Grafana 工作区里就关掉,那种情况下的脚本化编辑是权限问题,不是解析问题。
一份经得起代码评审的迁移清单
一份能过评审的迁移有它的形状,而这个形状主要关乎顺序和证据,不关乎聪明。
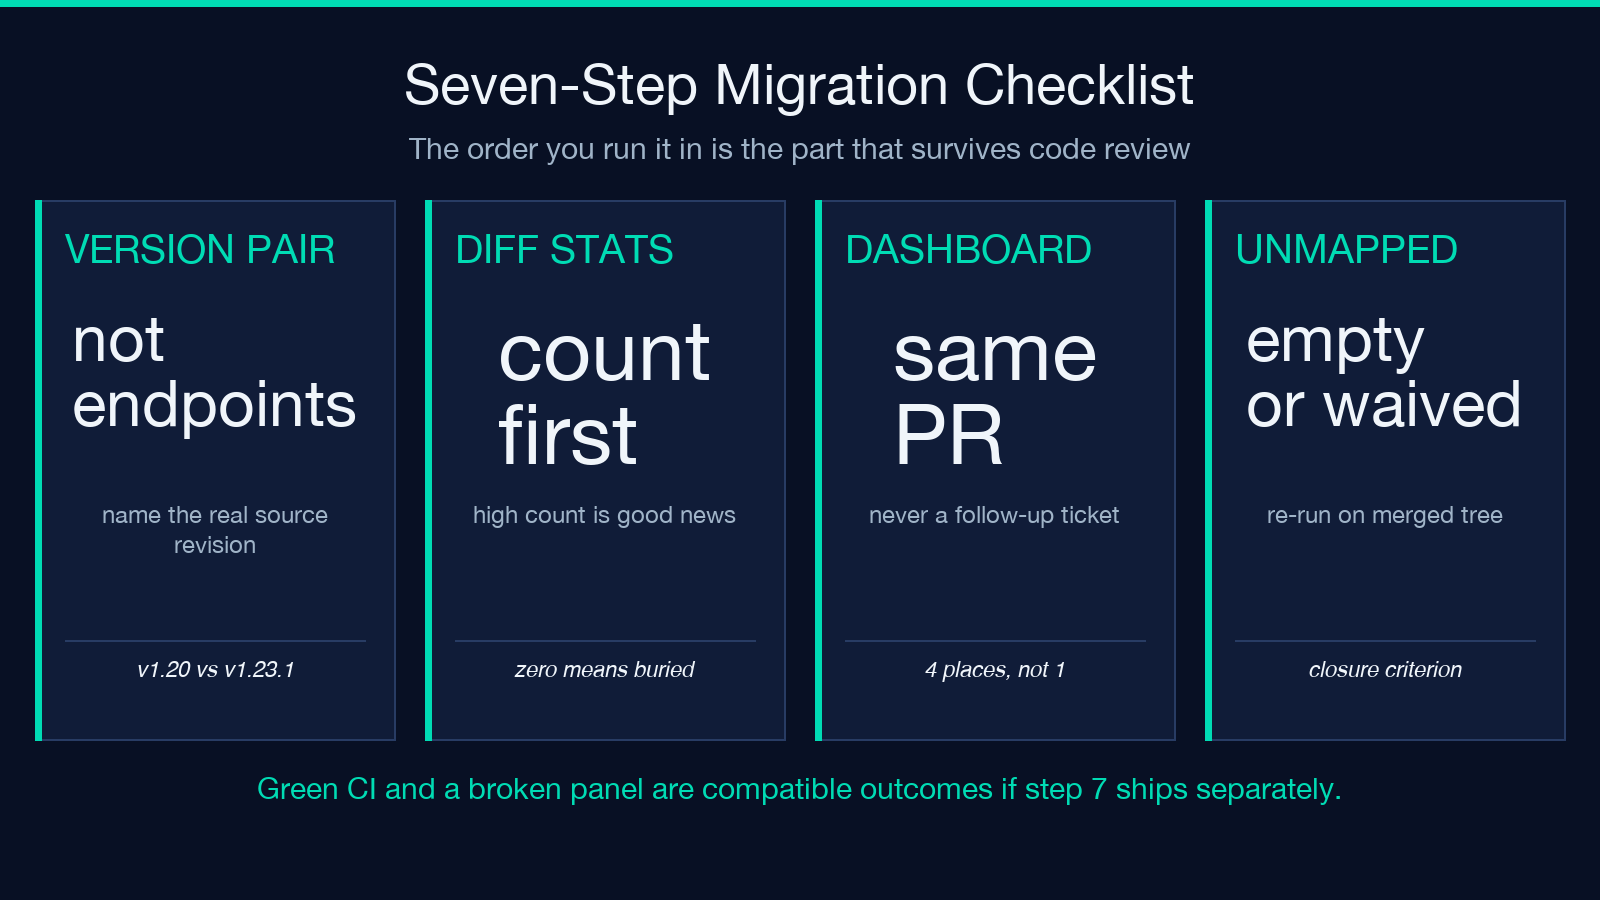
- 按你实际要跨越的版本对跑迁移,而不是按两端。
- 读 diff 统计,确认高计数的属性与你对代码分布位置的预期相符。
- 动手编辑之前,把未映射报告分诊成删除、拆分、仪表盘字符串三类。
- 在你拥有的服务里做源码侧改名,一个服务一个提交,让 bisect 保持有意义。
- 为无法部署的第三方服务生成 Collector transform,并在配置文件里就把它标成临时方案。
- 在合并后的树上重跑迁移,确认未映射清单已经清空,或者被显式豁免。
- 在同一个 pull request 里更新仪表盘 JSON 和消费它的仪表盘,绝不推到后续工单里。
第七条正是最常被跳过的那条,也正是它造出了那种每一道 CI 检查都是绿的、在生产里却已经错了一个月的迁移。
数字接下来该往哪儿去
迁移只是可观测性升级里枯燥的那一半。有意思的那一半,是名字对了、未映射属性清干净之后,你的 span 长什么样。属性名一旦稳定,同一份 span 数据就开始和那些为结构化遥测而生的工具配合起来,包括 Logfmt 与 JSON 结构化日志桥接,用来处理带着同一套属性词汇的扁平日志行。当你需要确认一个传播的上下文字段熬过了服务跳转,OpenTelemetry W3C traceparent / tracestate / baggage 与 OTLP 头传播验证器会直接查线格式。而当某次改名确实错落在了共享仪表盘上,JSON 差异可视化会指出到底是哪条查询变了。跑完迁移,关掉未映射报告,然后到 elysiatools.com 看更多工具。

Pingback: OpenTelemetry semconv v1.20 to v1.27: the renames that quietly break your dashboards - COSESAI