
两个不同的 JSON 对象,扁平化之后得到同一个键。{"a.b": 1} 和 {"a": {"b": 1}} 都塌缩成 a.b,可反扁平化工具拿到这个键,分不清你最初拿走的是哪棵树。每个 JSON 反扁平化工具都是一次重建,面板上那一排开关代替的是没人记录下来的证据。下面是通过实测看清这些开关各自做了什么。
扁平键是断言,不是路径
扁平化看起来是这项操作里安全的那一半。遍历树,用点把每条路径连起来,每个叶子写一行。表面上什么都没丢。可扁平化其实抹掉了分隔符与数据之间的边界:一个恰好含点的键,从此和嵌套对象无法区分,传到下游的文件里也不再保留这个差别。
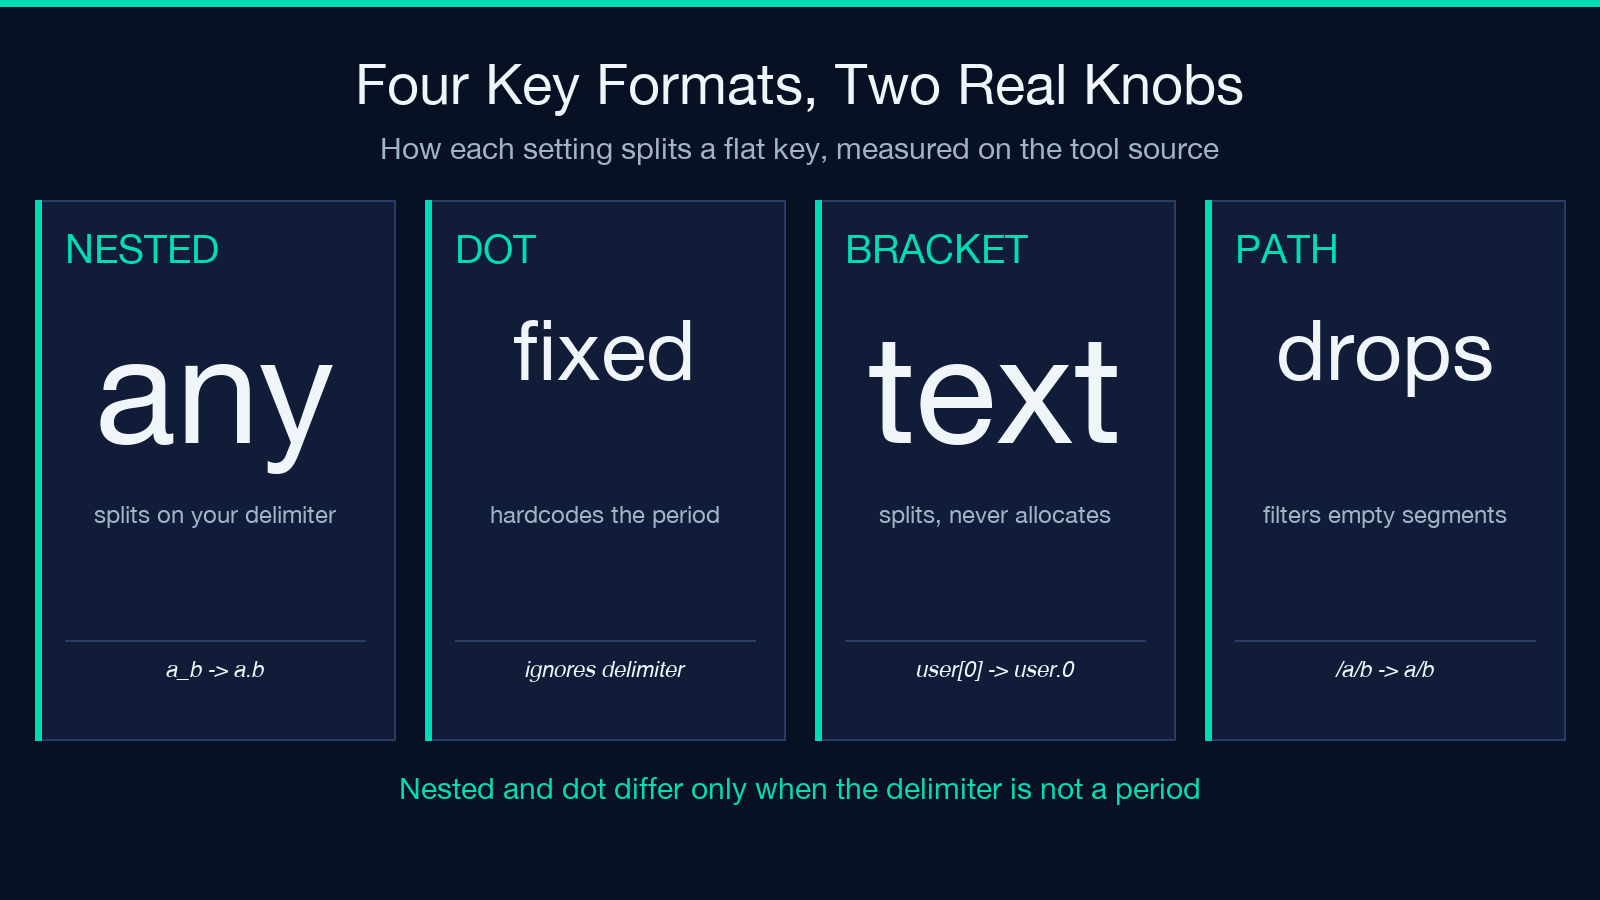
工具提供四种键格式,其中两种其实是同一个旋钮。nested 按你给的分隔符切分。dot 把句点写死,完全忽略分隔符字段。用默认分隔符时,这两种设置产出的结果逐字节相同。把分隔符改成下划线,输入单个键 a_b,两者立刻分道扬镳:nested 返回 {"a": {"b": "x"}},dot 返回 {"a_b": "x"}。
整个面板里没有任何转义语法。你没有办法声明某个点是字面量。键 a..b 会生成 {"a": {"": {"b": "v"}}},空字符串成了真实的属性名;末尾多一个点,同样的效果会出现在上一层。如果你见过带 "" 键的 JSON 载荷,那就是这个产物。比如用 join 拼路径的导出工具,只要有一段为空,就会发出这种形状。
这个结论值得直说,因为它改变了整件事的性质:反扁平化不是扁平化的逆运算。它是在一张丢弃了证据的映射表上能做到的最好重建。你可以在JSON反扁平化工具上试一试,本文余下的部分讲回程时怎么挑设置,才能少丢东西。
两个键,一条路径,两种不同的失败
拿两张扁平的映射表,键相同,只有顺序不同。这是我测到的最锋利的例子,而且它出在工具自己的代码里,不是我构造的输入。
{"a": "scalar", "a.b": "leaf"}会失败,报错Attempted to assign to readonly property.循环走到a,写入字符串,然后试图把b挂到这个字符串上。{"a.b": "leaf", "a": "scalar"}返回{"a": "scalar"},并报告conflictsResolved: 1。嵌套对象先建起来,随后被覆盖,叶子没了。{"a": null, "a.b": "leaf"}返回{"a": {"b": "leaf"}},因为这条代码路径把 null 槽位当作空位,不当作一个值。
一张扁平映射表,只改了键的顺序,得到三种结局:崩溃、静默丢数据、结果正确。扁平映射表不保证顺序,你拿到哪一种,取决于生产方当初怎么写出那些行。
这个实测细节在运维上有分量。崩溃不属于那种能针对某个字段捕获并上报的校验错误。它表现为一次普通的转换失败,于是遇错就重试的流水线,会在一个结构上完全合法的输入上一直重试下去。
类型推断在 JSON 输入上根本不运行
面板上有一个叫 Data Type Inference 的控件,三个选项:auto、string、smart。输入是 JSON 时,三个都不起作用。值解析器只在 key=value 分支里被调用。输入格式为 JSON 时,值来自 JSON 解析器,解析成什么样就用什么样。
我把同一张映射表用三种设置各跑了一遍,三次结果逐字节相同:{"user": {"age": "30", "on": "true", "n": 42}}。age 还是字符串,标志位还是字符串 true,唯一一个真正的数字还是数字。这就是三种模式在这种输入格式下全部可观察的差别。
这一点要紧,因为工具自带的示例恰好就是这种形状,user.age 存的是带引号的 "30",settings.notifications 存的是带引号的 "true"。载入默认示例、点运行,你拿回来的还是 "age": "30",不是 30。想要类型转换,必须强制改用 key=value 输入格式,那是另一个解析器,规则不同,失败方式也不同。
自动检测会把五位邮编怎么样
在 key=value 形式下,推断相当激进。我直接把值解析器拿来跑了二十个字符串,逐个记录返回值。
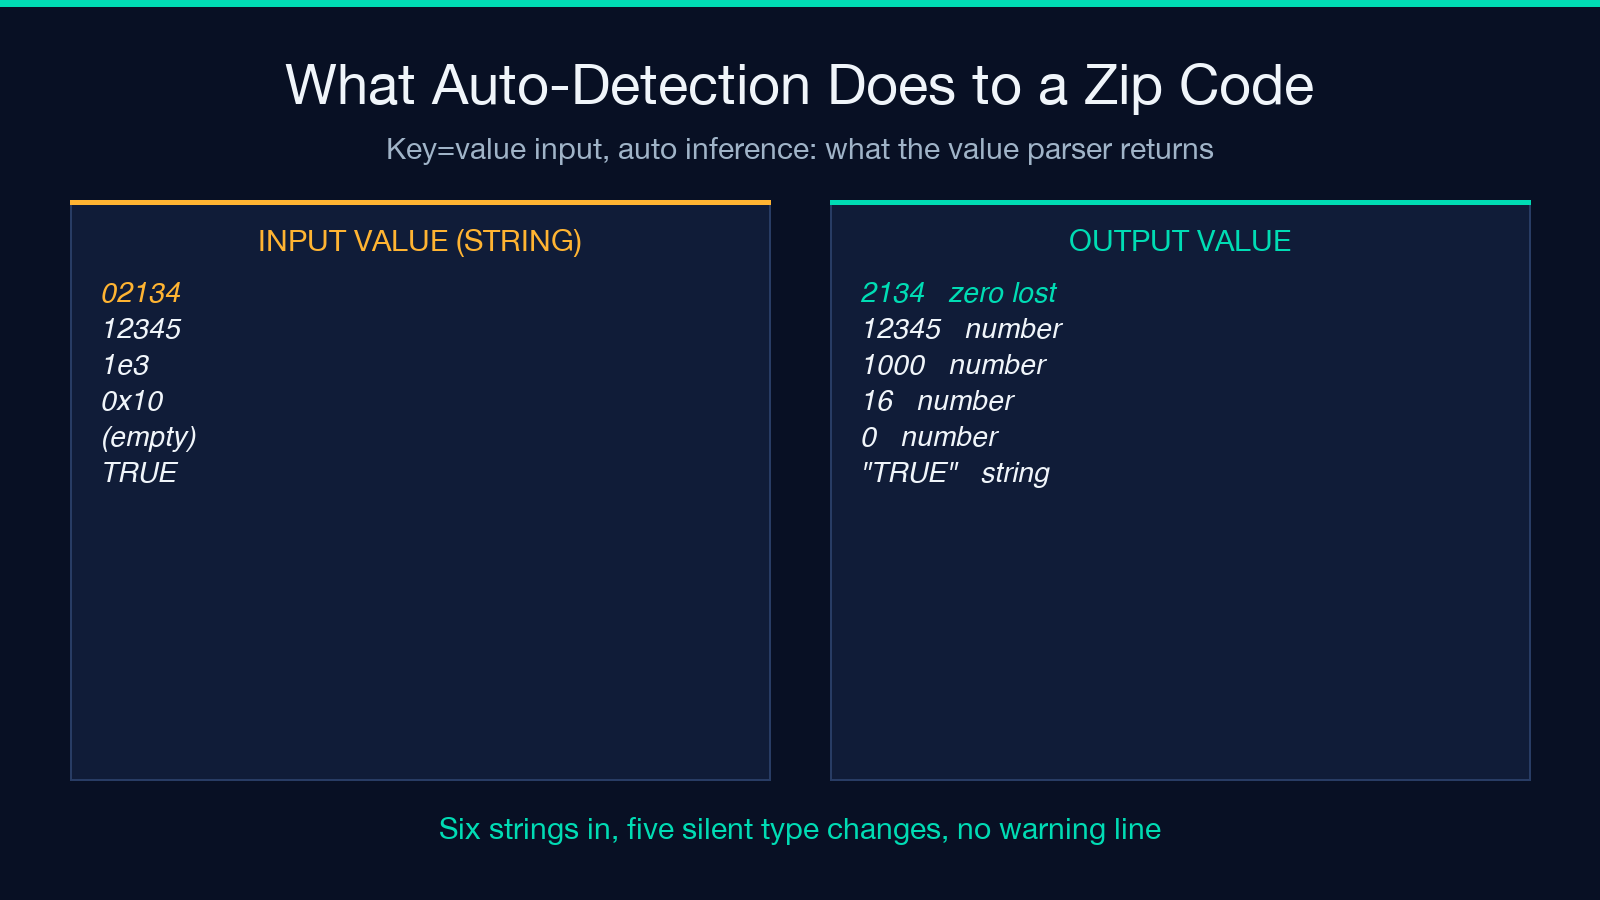
02134返回2134。前导零不属于那种下游还能补回来的显示偏好,它在值里就没有了。12345返回数字12345。波士顿的邮编能活下来,只是因为它恰好不以零开头。1e3返回1000,0x10返回16。两者都是合法的 JavaScript 数字字面量,所以都能解析。- 空值返回
0,因为数字解析器接受空字符串。一个空格子变成了零。 TRUE保持字符串,true变成布尔值。混用大小写的来源,会让同一列里出现两种类型。infinity保持字符串,NaN也一样。
失败的样子值得留意:有些标识符以数字形态活下来,有些被弄坏,活下来的那些,类型已经悄悄变了。两种结局都没有警告行。对一列产品编码来说,结果集里有对有错,比整列一片错更难发现,因为有一半的相等性检查仍然通过。
如果这些值是标识符,把模式设成 string 并一直保持。这一个选择就消掉了整类缺陷。
一个永远不会触发的数组开关
Array Detection 提供三个选项,其中一个不可能起作用。判断是否要分配数组的那个谓词,在 bracket 模式下无条件返回 false,理由是方括号键由键解析器处理,而键解析器只切分文本,从不分配任何东西。
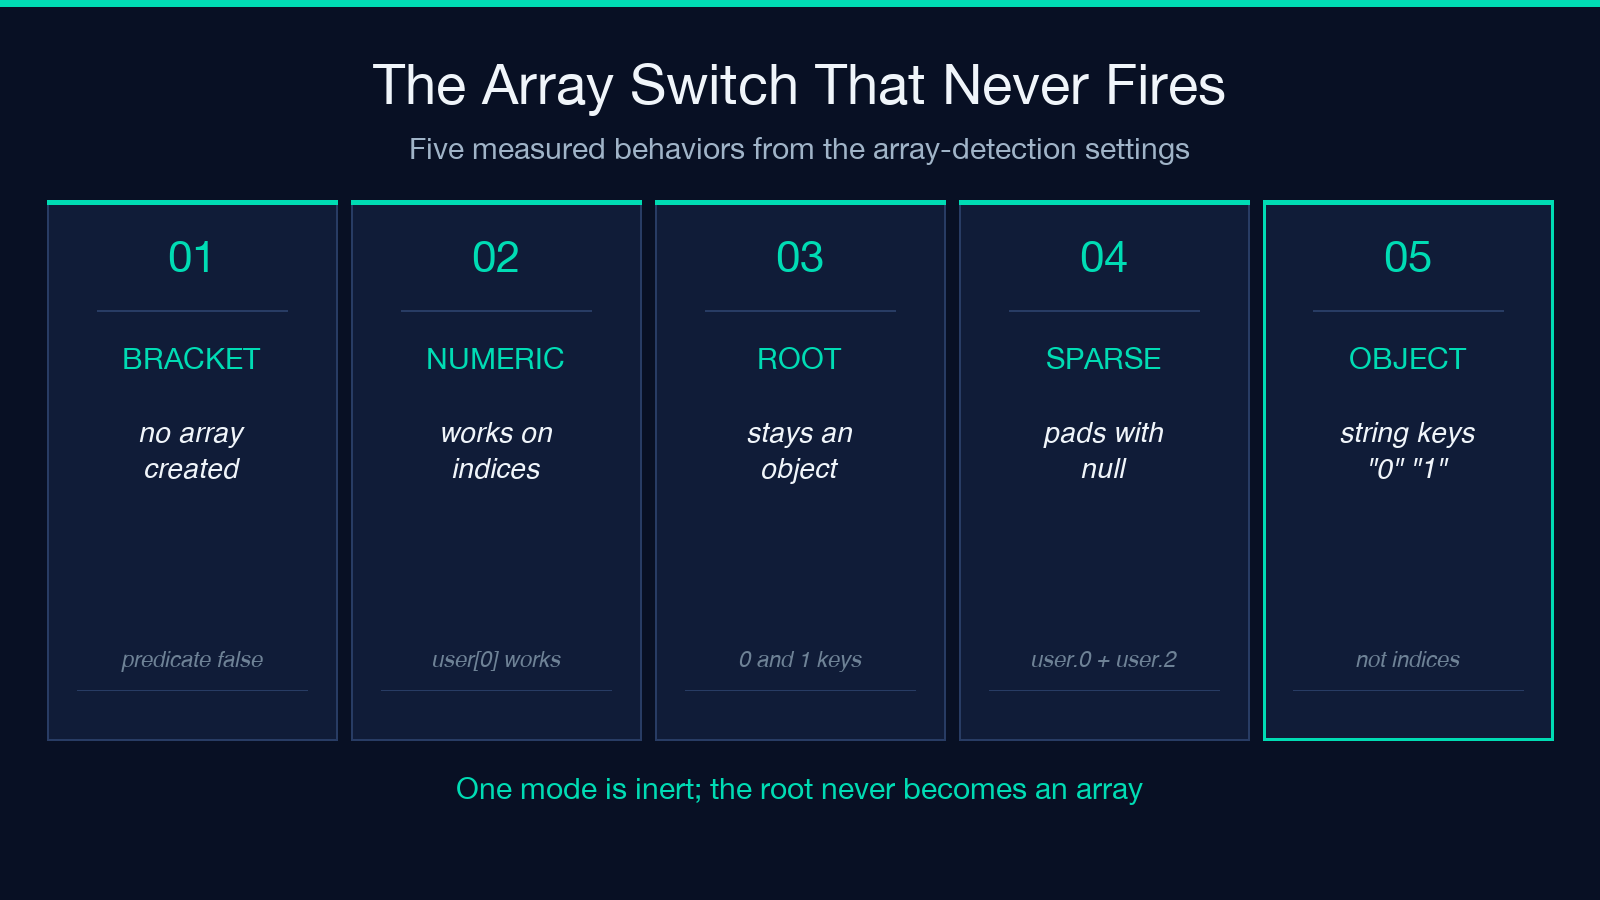
实测显示这个开关确实触发不了。把 {"user[0]": "a", "user[1]": "b"} 在数组模式设为 bracket 时喂进去,得到 {"user": {"0": "a", "1": "b"}},一个用字符串作键的对象。换成 numeric 模式,同样的方括号键会造出 {"user": ["a", "b"]}。
同一条笔记里还该记两种行为。数字检测只对中间层段生效,所以顶层键是 0 和 1 的映射表,返回的是对象,永远不是数组,因为根在任何键被读取之前就已经按对象分配好了。稀疏下标会用 null 填充:键 user.0 和 user.2 返回 {"user": ["a", null, "c"]},这个 null 是重建过程自己编出来的空洞,不是任何人给的值。
从映射表的来历反推设置
综合上面这些,这些设置关乎映射表的来历,与个人偏好无关,而每个断言通常只要向生产方问一个问题就能定下来。
- 来自用点拼路径的日志流水线:nested 格式、string 推断、numeric 数组打开。生产方没有类型信息,凭空造一个类型,就是把猜测包装成功能。
- 来自电子表格,或者 key=value 行的 CSV 导出:key=value 输入、string 推断。单元格是文本,要不要转换,是你之后该做的一个显式决定。
- 来自已知的 schema 或 OpenAPI 文档:上面三条都不适用。按 schema 重建,因为证据在你手上,扁平映射表把它扔掉了,启发式规则只能跟它竞争。
第三种情况最常被跳过。当你能从 schema 重新生成这棵树时,反扁平化工具严格来说不如 schema,无论开关怎么设。
重建还在哪里说谎
另外还有四种我验证过的行为,都属于「控件做的事和它的标签不一样」这一类。
- 合并策略在类型冲突时毁掉值。输入
{"a.b": "1", "a.0": "2"}并选中 merge,返回{"a": ["2"]}:对象按设计转成了数组,叶子b在转换过程中被丢掉。冲突计数器读数 2,所以工具确实报告了发生过事情。 - 重复键只在 path 格式下能够构造。因为空段会被过滤掉,
/a/b和a/b解析到同一条路径,错误策略能接住它。在 nested 格式下,我根本造不出重复键。 - 最大深度把值已被丢弃的键也算进去。关闭 preservation 时,一张含一个存活键和一个深层空键的映射表,返回两层结果,却报告最大深度为 5。
- 关闭 preservation 会丢掉空字符串、null 和 undefined,且不计数。结果对象里没有这些属性,响应中也没有任何字段说明少了几个。
诚实的总结是:统计块描述的是输入,不是输出。把 objectsCreated 和 maxDepth 当作工具所见内容的诊断信息,至于它产出了什么,得自己读返回的那棵树。
往返比对能终结争论
有一个比读完上面所有内容更省事的测试。把输出再扁平化一次,与输入做 diff,然后把差异归到三类之一。
- 只有键序变了。往返是精确的,可以上线。
- 某个值变了类型,但仍保留原文本,消费方也能容忍。带上一条流水线备注,可以上线。
- 某个值换了位置、消失了,或者多出一个 null。停下:这张扁平映射表对该键本就是有歧义的,没有任何设置能解决数据从未记录过的歧义。
最后一类不是谁提得出来的 bug。它是这项操作的边界,恰好出现在分隔符落在键内部的那些输入上。把这个 diff 放进测试套件一次,这个问题就不再依赖判断。结构化数据的其他转换工具可以在Elysia Tools的分类页里找到,反扁平化工具本身见JSON反扁平化工具。
从往返比对开始,别从设置导览开始:把输出扁平化,与输入 diff,逐行读差。如果变的只有键序,就到此为止。如果某个值移动或消失了,接下来值得回答的问题是:该改数据,还是该改导出器。

Pingback: Two Keys, One Path: Why Unflattening Cannot Be Exact - COSESAI