
大多数 CSV 管道都栽在第三步转换上。 一次干净的重命名顺利过关,一次类型转换把下一列收拾妥当,然后 add_column 的公式引用了上一步刚刚改过形态的东西:你正要送去仪表盘的那一行,模型期待整数的地方现在是个字符串。解决办法是把这些操作串成一个有序列表,而不是为每个缺陷单独写一个脚本。CSV转换器 走的正是这条路:一个由定型操作组成的 JSON 数组,从左到右依次执行,handleErrors 决定某一行无法强制转换时怎么办。
有四个操作听起来像同一件事,实际行为差得很远,初次上手的人最容易在这里栽跟头。rename 改写表头;convert_type 改写该表头下的每一个单元格;calculate 写入一个已存在的列,覆盖原值;add_column 写入一个新列,源列原样保留。把这四个操作叠进同一个转换数组,一个能用的 ETL 片段就成形了,全程不必离开浏览器标签页。
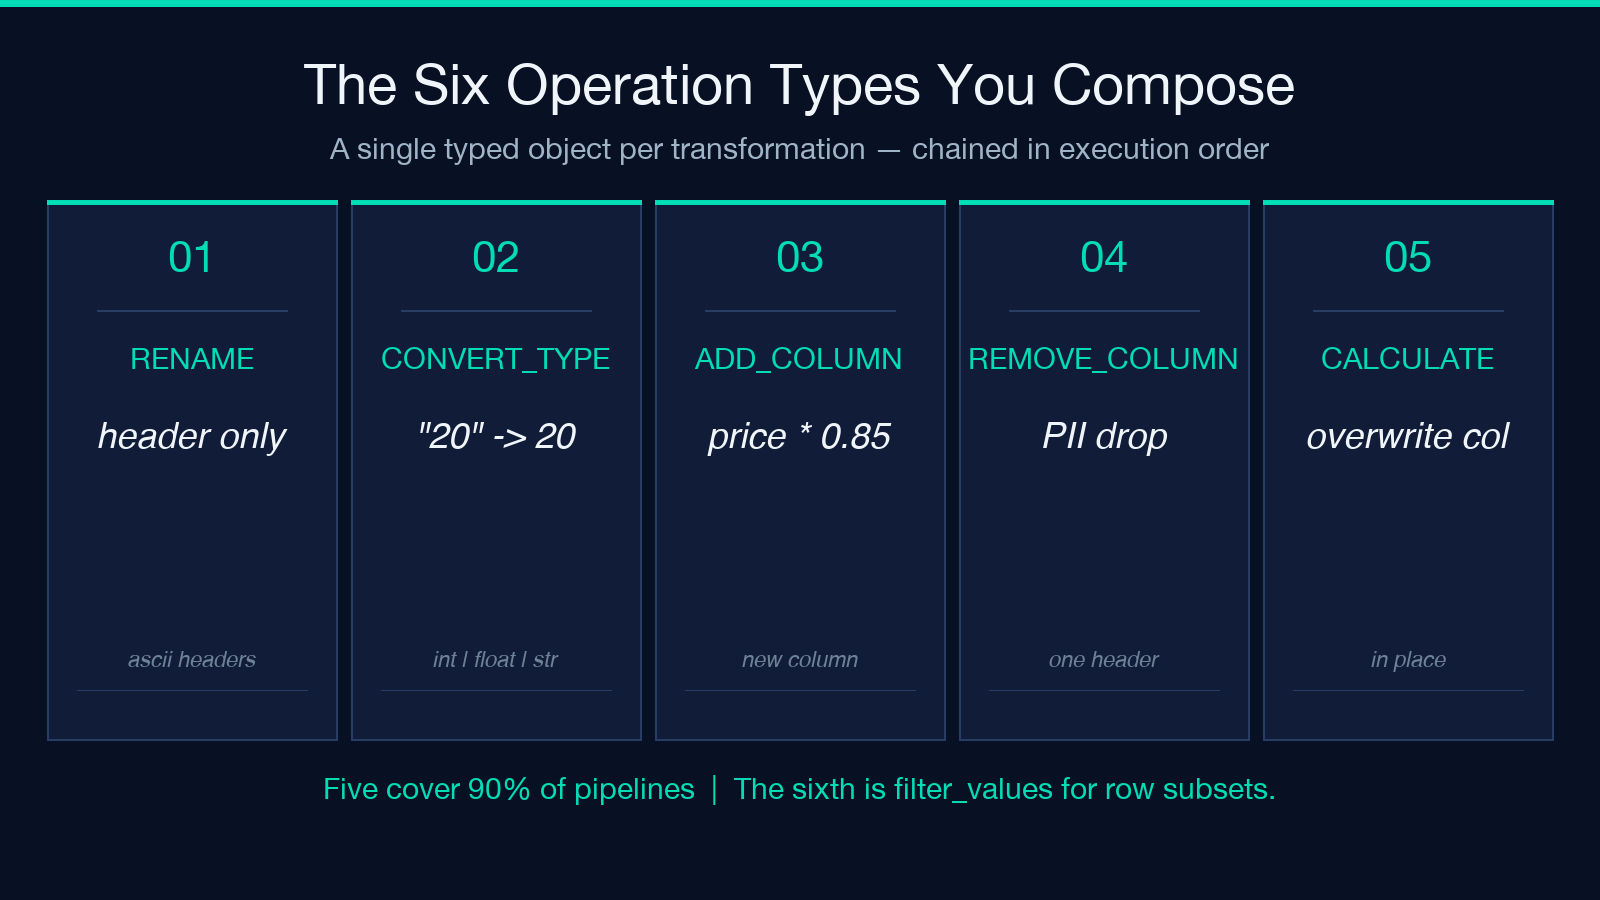
六种操作类型,按你实际的用量排序
CSV转换器只定义了六种操作类型,每一种都是一个定型对象,至少带一个 type 字段和一两个操作数:rename、convert_type、add_column、remove_column、calculate、filter_values。其中 rename、convert_type、add_column 三种大约覆盖了真实管道的 90%,其余的在更窄的场景里才有用,所以单独放到后面一节。
每个文件都会用到的三种
重命名表头是入口。像 01-simple-students.csv 这样的中文文件,表头是 姓名、年龄、性别,人看得懂,下游模型却只认 ASCII 标识符。一次 rename 就地改掉它们:[{"type": "rename", "column": "姓名", "new_name": "name"}, {"type": "rename", "column": "年龄", "new_name": "age"}, {"type": "rename", "column": "性别", "new_name": "gender"}]。链条上的下一环看到的就是 name,age,gender,不必再做翻译。
类型转换把字符串列变成 SQL 或 pandas 能直接吃下去的东西。上面那份学生表里,年龄 是以文本形式到达的,把 "20" 送进一次数值 join,这一行会被悄悄丢掉。带上 target_type: "integer" 的 convert_type 会改写该表头下的每个单元格。这里要留意错误设置:handleErrors: "keep_original" 保留无法解析的值,handleErrors: "drop_row" 删掉整行。审计日志用前者,数据仓库入库用后者更稳。
计算列是多数管道显本事的地方,也是它们最容易翻车的地方。假设一份商品文件里有 价格,你想再加一列折后价格,转换写成 [{"type": "add_column", "new_column": "discounted", "formula": "price * 0.85", "default_value": "0"}]。注意公式里用的是 rename 跑过之后的英文列名,不是原来的 价格。此时源列若还是中文,公式引用的就是一个已经不存在的表头。
组合操作:一个完整示例
最实用的套路是把整条管道打包成一个有序数组。以商品文件 02-products-price.csv 为例(8 行 5 列:产品ID,产品名称,价格,库存,分类):
[
  {"type": "rename", "column": "产品ID", "new_name": "product_id"},
  {"type": "rename", "column": "产品名称", "new_name": "name"},
  {"type": "rename", "column": "价格", "new_name": "price"},
  {"type": "rename", "column": "库存", "new_name": "stock"},
  {"type": "rename", "column": "分类", "new_name": "category"},
  {"type": "convert_type", "convert_column": "price", "target_type": "float"},
  {"type": "convert_type", "convert_column": "stock", "target_type": "integer"},
  {"type": "add_column", "new_column": "discounted", "formula": "price * 0.85"},
  {"type": "add_column", "new_column": "stock_value", "formula": "price * stock"}
]
有三点值得留意。第一,所有 rename 都在任何 convert_type 之前执行,列名参数引用的是原始表头,不是改名后的;一旦打乱顺序,针对 price 的公式会在列还叫 价格 的时候静默失败。第二,convert_type 接受一套类似 Python 的类型名:integer、float、string、boolean。第三,add_column 跑在改名之后的数据集上,公式里引用 name 没有问题。
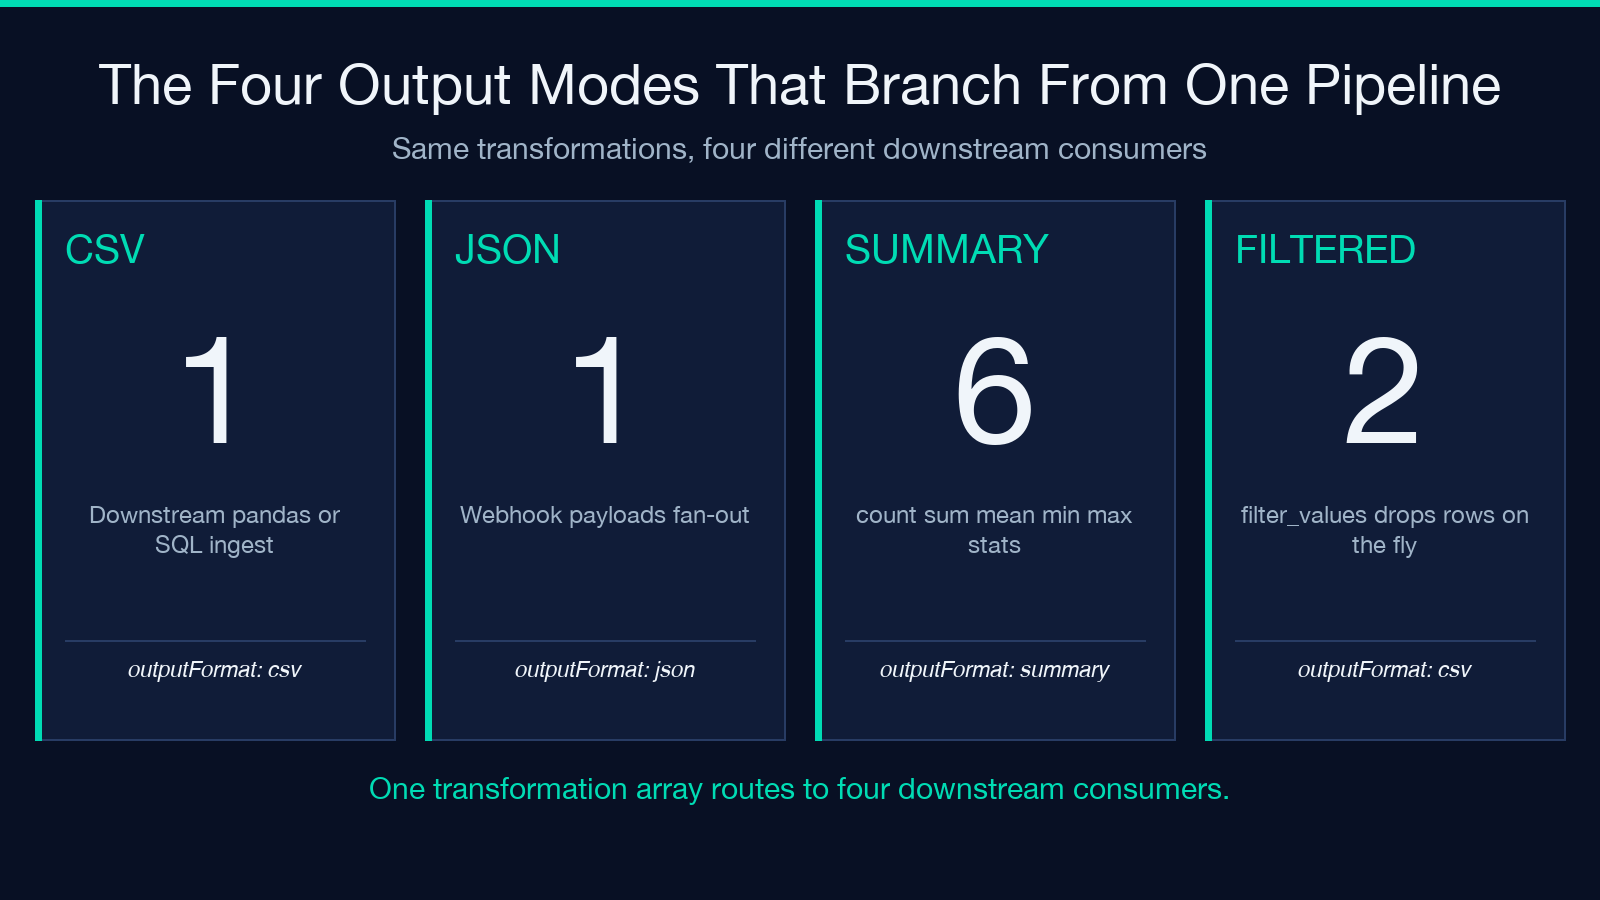
输出格式也要选对。下游管道用 outputFormat: "csv",API 载荷用 "json",数值报告用 "summary"。summary 模式最容易被忽略,它会直接给出数值列的 count、sum、mean、min、max,一行聚合代码都不用写。
筛掉不要的行,schema 保持不变
多数团队习惯把 filter_values 交给单独的 SQL 或 pandas 步骤,CSV转换器其实可以就地完成。以 03-employees-info.csv(7 行)为例,只保留技术部:
[
  {"type": "rename", "column": "员工ID", "new_name": "employee_id"},
  {"type": "rename", "column": "部门", "new_name": "department"},
  {"type": "filter_values", "filter_column": "department", "operator": "equals", "value": "技术部"}
]过滤运算符覆盖了常见情况:equals、not_equals、contains、starts_with、greater_than、less_than、is_empty、is_not_empty。两个过滤条件串两个 filter_values 操作即可。它没有原生的 AND/OR 表达式,需要那种复杂度就退回 pandas;但对「把某一列裁到只剩一个分段」这类日常活儿,能省掉一整轮脚本。
三种较少出现但值得了解的操作
remove_column 删掉整个表头及其下所有单元格,适合在文件离开暂存环境之前去掉 PII 列(邮箱、电话、身份证件号)。写法只有一行:[{"type": "remove_column", "remove_column": "邮箱"}],从 03-employees-info.csv 里去掉邮箱列,其余六列不受影响。
calculate 用公式结果覆盖一个已存在的列,add_column 则是新增一列。这个区别只在两种窄场景里要紧:列已经由下游工具建好,你只想刷新它的值;或者想用一个算出来的数值换掉字符串列,且不留原列。写法形如 [{"type": "calculate", "target_column": "total", "expression": "price * tax + shipping"}]。如果源列本来就要被覆盖,把链条里的 add_column 换成 calculate 能省一列。
outputFormat 并非操作,它只是个切换输出模式的属性。把它和 filter_values 组合,两步就能得到按部门汇总的结果。
错误处理与可复现性
handleErrors 是把脆弱原型变成可复现管道的那个开关,共三种模式:
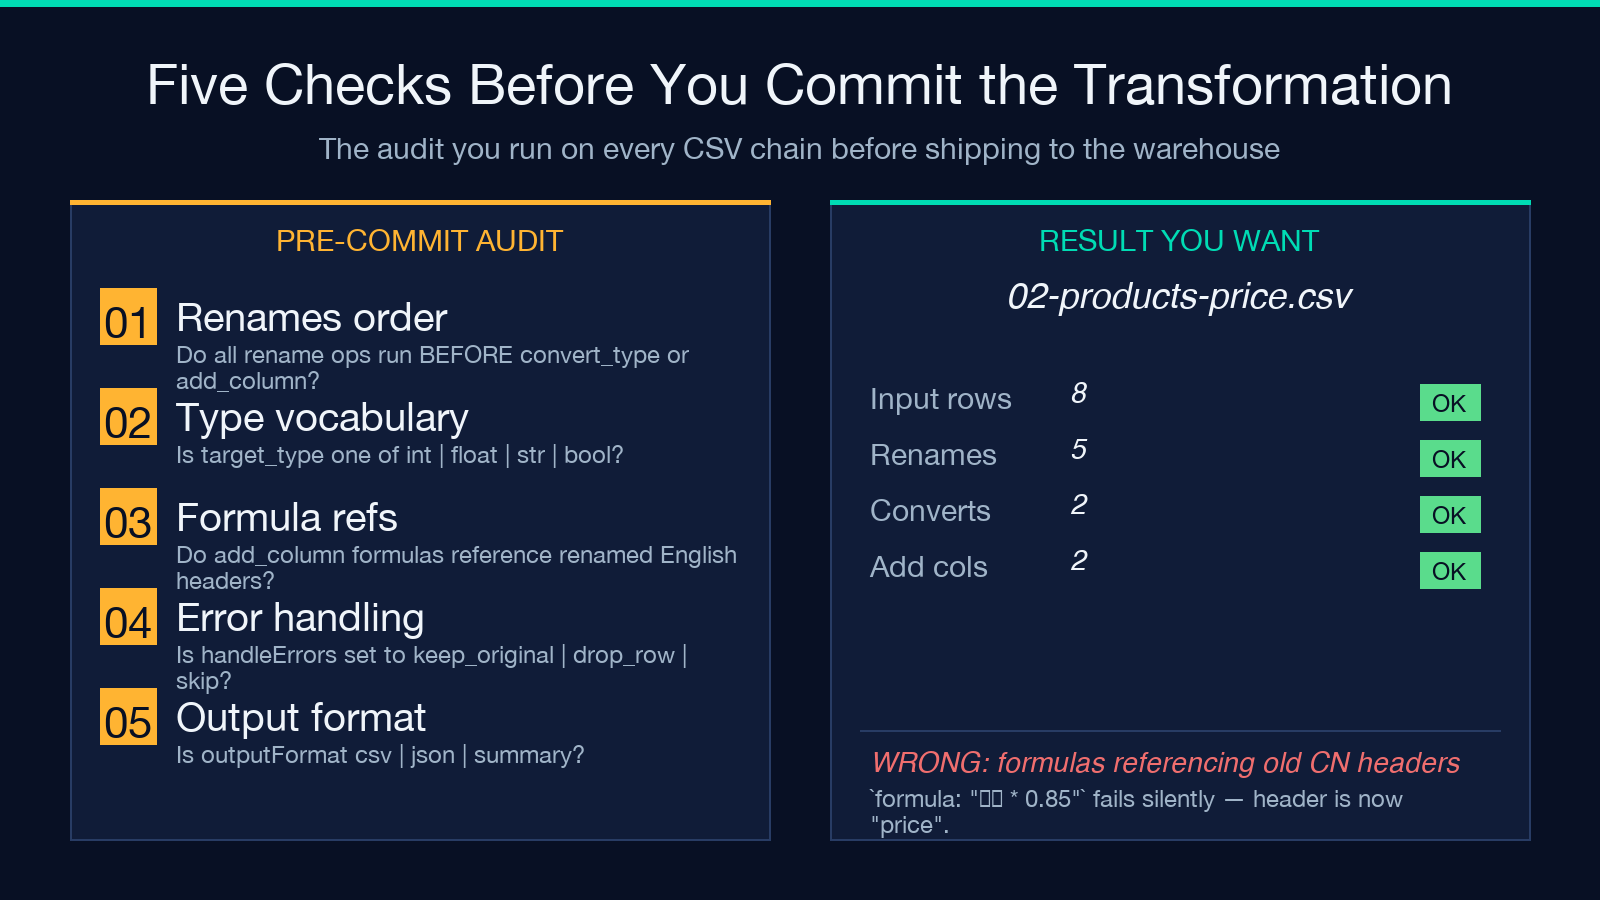
keep_original:保留无法解析的单元格,并记录行号。适合事后逐条查看失败行、再人工决定。drop_row:一个单元格失败就删掉整行。数据仓库入库用这个,半行数据比没有行更糟。skip:只丢弃该行上失败的那一个操作,其余照常继续。用于附加列,缺值好过整行丢失。
再配上 errorHandling: "log" 输出控制台摘要;生产环境里错误日志只是噪音,那就用 "silent"。开发阶段的默认组合是 keep_original 加 log,确认源数据干净之后再换成 drop_row 加 silent。
关于真实数据的两点
有两种情况反复出现。其一,从中文 ERP 系统导出的文件,表头常是非 ASCII 字符(姓名、价格、部门),引号写法也不统一:03-employees-info.csv 里是带引号的 "张三",01-simple-students.csv 里是裸值。CSV转换器两种都处理得了,但 convert_type 那一步认的是原始表头,不是改名后的,所以先规划好 rename。
其二,add_column 的公式语言是一个受限子集:+、-、*、/、括号和列引用。没有字符串拼接,没有条件表达式,没有函数调用。「价格大于 100 就把折后价乘以 0.9,否则维持原价」这种逻辑还得靠 pandas。转换器覆盖了纯算术列那 80% 的需求,其余的老实拒绝,对一个跑在浏览器里的工具来说,这个取舍是对的。
CSV转换器在管道里的位置
它替代不了 dplyr、pandas,也替代不了 SQL 的 INSERT … SELECT。它承担的是桥梁那一层:让分析师、运维、售前工程师这些人用上工程师写的那条数据管道。他们拿到的是定型 schema、确定的执行顺序,以及每步转换作用在小文件上的即时可视化反馈;工程师则可以把状态留在版本控制里,因为每次转换都是一个能粘进 runbook 的 JSON 数组。
它的输出,无论是转换后的 CSV、JSON 记录列表还是数值摘要,都能原样交给下一环节。把 JSON 输出直接塞进 requests.post(),一个免代码的集成层就有了,专门对付每个数据团队都会攒下的那些小而琐碎的 ETL 活儿。
同一 Data Processing 分类下的相邻任务也各有对应工具:转换前顺手去重可以用 数据去重工具,比对原始文件与转换结果的列级差异用 CSV / Excel 差异比对工具,只想取一个子集则用 CSV过滤器;其余工具都归在 浏览全部工具 页面里。手上的活儿是「我有一份 CSV 和一张改动清单」,CSV转换器就合适;一旦变成「我需要 join、窗口函数或递归 CTE」,它就派不上用场了。

Pingback: CSV Transformer Field Guide: When Six Typed Operations Decide Whether a CSV Reaches the Warehouse - COSESAI