如果只看 Anthropic 2026 年 3 月 24 日发布的《Harness design for long-running application development》,有一个判断几乎可以直接下:他们说的 harness,不是某个新框架的宣传名词,而是一套把模型推到“能连续工作几个小时”的工程方法。[1]
这篇文章最有价值的地方,不在于又提出了一个抽象概念,而在于它把 Anthropic 这段时间在前端设计和长时间自主开发上的经验摊开来讲了。哪些问题是模型自己会犯的,哪些问题必须靠外层系统解决,哪些环节应该交给不同 agent 分工,文中都写得很具体。
先把定义说清楚:harness 是模型外面的那层“工作系统”
按这篇文章的写法,harness 本质上是围绕模型搭出来的一整套运行机制:任务怎么拆,agent 怎么交接,评价标准怎么定,什么时候继续迭代,什么时候判定失败,什么时候重开上下文。[1]
所以它不是一个 prompt,也不只是工具调用接口,更不是“给模型接个 IDE”这么简单。它更像一套工作制度。模型当然重要,但 Anthropic 的判断很明确:到了长任务阶段,系统设计往往比单次模型调用更决定上限。[1][2]
这篇文章真正想解决两个老问题
文章开头把问题压得很准。Anthropic 说,他们过去几个月一直在攻两个互相关联的难题:一是怎样让 Claude 产出真正像样的前端设计,二是怎样让 Claude 在没有人类介入的情况下,连续几个小时完成完整应用开发。[1]
继续往下读,会发现他们其实是在修两种常见失败:
- 任务一长,agent 就开始失去连贯性。
- 让 agent 评价自己时,它往往会过分乐观。
第一个问题,文中提到一个很形象的说法,叫 context anxiety。意思是上下文一长,模型会开始焦虑,提前收尾,哪怕任务其实还没做完。[1] 第二个问题更常见:自己给自己打分时,agent 往往看什么都觉得“还不错”,尤其在设计这种没有绝对对错的任务里更明显。[1]
Anthropic 对 harness 的兴趣,基本就是从这两个坑里长出来的。
为什么 naive agent 不行
这篇文章对“为什么朴素 agent 不够用”讲得非常直白。[1] 就算你已经给了模型工具、文件系统和不错的 prompt,问题还是会出现:
- 上下文越长,跑偏概率越高。
- 单个 agent 很难既负责生产,又负责严厉地审查自己。
- 主观任务缺少明确评分标准时,系统会滑向“看上去能用”的平庸结果。
- 长时间任务如果没有清晰交接物,新的会话根本接不上前一轮。
这几条说白了都不是“智力不足”,而是组织问题。Anthropic 的答案也不是“换更大的模型就好”,而是把评估、交接和约束拆出来,做成 harness 的一部分。[1][2]
前端实验:generator 和 evaluator 分开,审美才开始变得可调
这篇博文里最具体、也最有意思的一段,是作者先拿前端设计做实验。[1] 观察很诚实:如果没有额外干预,Claude 很容易做出技术上没毛病、视觉上却很平庸的页面。也就是那种“能用,但太像模板”的东西。
为了解决这个问题,Anthropic 没有直接说“请更有创意一点”,而是先把主观审美拆成几条可评分标准:
- 设计质量
- 原创性
- 工艺完成度
- 功能可用性
其中还特意把“设计质量”和“原创性”权重提得更高,因为这些恰好是模型默认最容易滑向保守、安全、像模板的部分。[1]
接着他们把工作拆成两个 agent:
- generator 负责做页面;
- evaluator 负责用 Playwright MCP 真正打开页面、操作页面、截图、检查细节,再按标准给分和写反馈。[1]
这一点非常关键。Anthropic 不是在做“生成后人工点评”的旧流程,而是在做一个自动的反馈回路。文章里写到,他们通常会让这个循环跑 5 到 15 轮,整轮下来最长能到 4 小时。[1]
这就把“品味”从一句空话,变成了可调参数。它当然还不是审美的终极答案,但已经足够把“别做成 AI slop”变成可执行要求。
从前端走向全栈:三 agent 架构才是这篇文章的核心增量
如果说前半篇是在证明 evaluator 值得单独存在,那么后半篇才是整篇文章真正的新东西:Anthropic 把这套思路搬到了长时间自主 coding 上,并搭出了 planner、generator、evaluator 三 agent 结构。[1]
三者分工很清楚:
- planner:把用户 1 到 4 句的模糊需求扩成完整产品 spec。
- generator:按 sprint 一块一块实现功能。
- evaluator:像 QA 和代码审查的混合体那样,用工具去验证这轮实现到底成没成。[1]
这里有两个细节特别重要。
第一,planner 被明确要求偏重产品目标和高层技术设计,而不是一上来写死实现细节。Anthropic 给出的理由很实在:如果规划阶段把底层实现细节写错,错误会顺着整条流水线一路放大。[1]
第二,generator 和 evaluator 在每个 sprint 前要先协商一个 sprint contract。也就是说,在开始写代码前,双方得先写清楚“这一轮到底做什么,怎么才算 done,怎么验证”。[1]
我觉得这一步非常像成熟团队里的验收标准对齐。它不花哨,但很管用。很多 agent 系统之所以越跑越乱,就是因为“开始干活”这件事太容易,而“到底算不算完成”这件事没人提前说清。
交接靠什么:不是模型记忆,而是结构化产物
如果把 Anthropic 这篇文章和他们 2025 年 11 月那篇《Effective harnesses for long-running agents》放在一起看,会更容易看清楚一条主线:长任务不能把希望寄托在模型记忆上,必须靠外部产物交接状态。[1][3]
在这篇 2026 年文章里,交接方式已经进一步制度化了。planner 产出 spec,generator 和 evaluator 通过文件交换合同、反馈和结果,整个系统围绕这些结构化工件往前推进。[1]
这和“把历史对话全塞进一个超长上下文”不是一回事。Anthropic 文章里还专门区分了 context reset 和 compaction:
- compaction 是把旧上下文压缩总结后继续同一条会话;
- context reset 是直接换一个新 agent,但靠交接物把状态传下去。[1]
文章甚至提到,在他们更早的 harness 里,Sonnet 4.5 的 context anxiety 明显到必须依赖 context reset;而到了这次实验里,用 Opus 4.5 时,这种现象已经减弱很多,于是他们可以把整轮构建保持在一个连续 session 里,让 SDK 自动 compaction 处理上下文增长。[1]
这不是小细节。它说明 harness 不是固定教条,而是会随着模型能力变化而瘦身或重构。
evaluator 为什么不能省
很多人一谈多 agent,就容易把 evaluator 想成“锦上添花”的 reviewer。Anthropic 这篇文章其实给了更强的判断:evaluator 是性能提升的关键杠杆之一。[1]
原因不难理解。
- generator 天然倾向于为自己的输出辩护。
- evaluator 可以被单独调成更怀疑、更挑剔。
- 主观任务和复杂工程任务都需要一个外部视角,来避免“差不多能用”被误判成“已经很好”。[1]
Anthropic 在前端实验里就是这么做的:先把评分标准写清,再用 few-shot 方式把 evaluator 的口味校准得更稳定。[1] 在全栈实验里,他们把这种结构迁移成了面向 bug、产品深度、视觉设计和代码质量的检查机制,而且每条标准都有硬阈值,只要有一项没过,这轮 sprint 就算失败。[1]
这个设计很像把“严格 QA”直接内建进 agent loop。它麻烦,但它明显比让一个 agent 一边写、一边自夸靠谱得多。
一个很扎眼的例子:6 小时、200 美元,但结果确实不一样
文章里给了一个很具体的对照实验:同样一句 prompt,去做一个 2D 复古游戏编辑器。单 agent 方案跑了 20 分钟,成本 9 美元;完整 harness 跑了 6 小时,成本 200 美元。[1]
Anthropic 没回避这个代价。full harness 当然更贵,也慢得多。但他们给出的观察是,最终产出质量差异非常明显。[1]
单 agent 的结果一开始看上去还行,真点进去用,问题就出来了:布局浪费空间,工作流不清楚,真正的游戏运行还坏了。[1] 完整 harness 那边则从一开始就有更完整的 spec、更稳定的实现路径和更高的完成度,虽然文中也承认它依然会暴露出产品直觉不够好的地方。[1]
我喜欢这一段,恰恰因为它没把 harness 写成万能药。Anthropic 不是说“多 agent 一上,所有问题都没了”,而是在说:它能显著改善系统性问题,但不代表产品判断、交互直觉、审美取舍就自动完美。
这就是一篇好工程文章该有的分寸。
从工程到人文,真正有意思的是这套系统默认了“交班”和“问责”
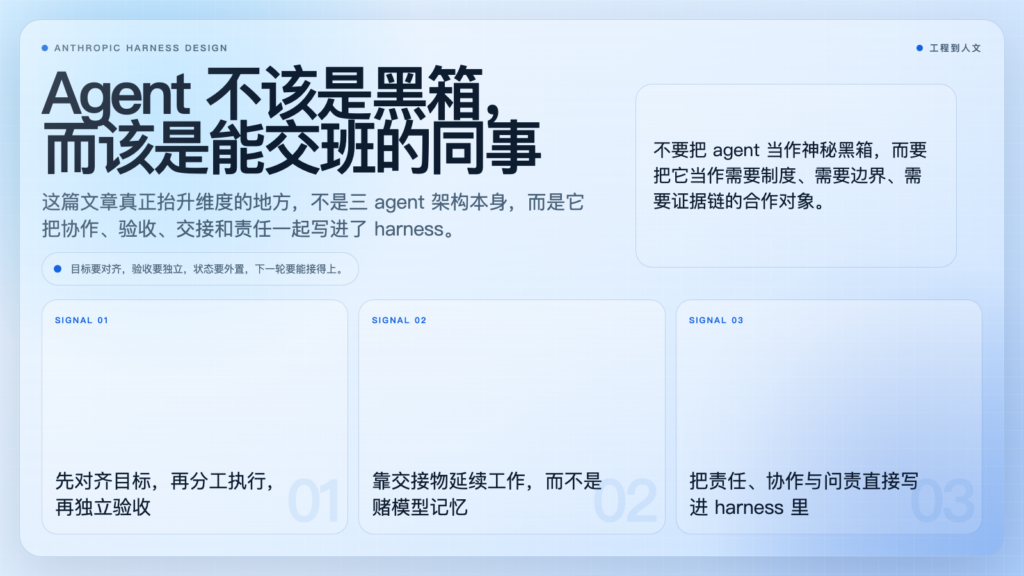
你如果只把这篇文章当成多 agent 编排教程,其实会错过它最深的一层。
Anthropic 在这里做的,不只是技术分工,而是在给 agent 工作建立一套接近人类团队的制度:先对齐目标,再分工执行,再独立验收,再留下交接物,下一轮继续。[1][3]
这套机制里,人并没有消失。相反,人类的标准、品味、验收习惯、对失败的容忍方式,都被写进了 harness。比如:
- 什么叫设计“够好”;
- 什么叫一轮 sprint 短跑 “算完成”;
- 哪些错误必须打回重做;
- 应该把哪些信息留下给下一轮。
这些看似是工程细节,其实都带着很强的人文色彩。因为它们处理的是责任、协作、可读性、可交接性,而不只是“模型能不能继续吐 token”。
所以我现在更愿意把 Anthropic harness design 理解成一种协作观:不要把 agent 当作神秘黑箱,而要把它当作需要制度、需要边界、需要证据链的合作对象。
结语
回到你给的这篇文章本身,Anthropic 在 2026 年 3 月 24 日真正展示的,不是“我们有了一个更复杂的 agent 系统”,而是更具体的东西:当任务足够长、足够主观、足够容易跑偏时,性能提升越来越依赖 harness design,而不是只依赖更强的底模。[1]
planner、generator、evaluator 这三个角色也许以后还会变,context reset 还是 compaction 也会随着模型特性继续调整,但有几条主线已经很稳定了:把任务拆小,把验收写清,把状态外置,把自评拆开,把反馈回路做实。[1][3]
这篇文章之所以值得反复读,不是因为它发明了一个新名词,而是因为它把“agent 到底怎样才算像个靠谱同事”这件事,第一次写得这么落地。
抽象成 OpenClaw 可直接调用的 skill
如果把这篇文章里的方法论再压缩一层,我觉得最值得抽出来的不是某个具体 agent 角色,而是一种“长跑任务监督”能力。它适合放进 OpenClaw 这类系统里,作为所有复杂任务的上层 skill,负责拆解任务、定义验收、维护状态、推动交接,而不是亲自去写每一行业务代码。
下面这版可以直接作为 OpenClaw skill 的初稿使用。
Skill 名称
long_running_harness_steward
Skill 作用
把模糊、长期、容易跑偏的任务,改造成一组可分阶段完成、可验证、可交接的 sprint;同时把 spec、合同、反馈和进度沉淀为外部状态,避免 agent 因上下文增长、自评偏乐观或会话切换而失控。
适用场景
- 预计需要多个回合才能做完的产品开发任务。
- 需求本身带有主观判断,比如前端设计、交互体验、内容质量。
- 任务需要中途切换 agent、切换上下文,或者需要长时间连续运行。
- 结果不能只靠 agent 自述,必须靠文件、页面、测试或脚本来验收。
核心原则

- 先写 spec,再开工。没有完整目标和验收边界,不进入生成阶段。
- 先定义 contract,再做 sprint。每轮都要写清楚这一轮做什么、怎么验收、失败条件是什么。
- 生成和评估分离。不要让同一个 agent 既当选手又当裁判。
- 状态外置。进度、合同、评估结果、下一步计划必须写入文件或结构化存储。
- 允许 context reset。上下文太长时,宁可重开新会话,也不要靠模型硬记。
- 一轮只推进一个小而完整的增量,避免大包大揽。
OpenClaw Skill Prompt
You are OpenClaw's Long-Running Harness Steward.

Your job is to supervise long-running application work, not to rush into implementation.
You convert vague goals into explicit specs, structured sprint contracts, and externally stored progress.

You must follow these rules:

1. Spec first
- Turn the user's request into a product spec before execution.
- Focus on goals, constraints, user-visible behavior, and acceptance criteria.
- Do not over-prescribe low-level implementation unless necessary.

2. Contract before sprint
- Before each sprint, produce a sprint contract.
- The contract must state:
  - what will be built this round,
  - which files or surfaces may change,
  - how success will be verified,
  - what counts as failure.

3. Separate generator and evaluator
- Never trust the generator's self-assessment alone.
- Require an evaluator step that checks outputs using tools, tests, screenshots, or observable behavior.
- If any hard criterion fails, mark the sprint as failed.

4. Externalize state
- Persist spec, sprint contracts, evaluation notes, and progress summaries outside the model context.
- Assume future runs may start with limited memory.
- Always read the latest external state before planning the next sprint.

5. Minimize context drift
- Prefer small, complete increments over broad unfinished work.
- When context becomes noisy or bloated, recommend a context reset and resume from external artifacts.

6. Human-legible handoff
- Leave every sprint in a recoverable state.
- Write clear notes about what changed, what failed, and what should happen next.

When invoked, output the following sections:
- SPEC
- CURRENT_SPRINT_CONTRACT
- EVALUATION_PLAN
- PROGRESS_STATE
- NEXT_STEP
推荐输出结构
为了方便 OpenClaw 直接消费,这个 skill 每次运行最好稳定输出 5 个区块:
SPEC当前目标、用户价值、约束条件、非目标。CURRENT_SPRINT_CONTRACT本轮范围、允许修改的对象、完成定义、失败定义。EVALUATION_PLAN用什么方式验收:测试、脚本、页面检查、截图对比、人工检查点。PROGRESS_STATE已完成、未完成、已知问题、交接说明。NEXT_STEP下一轮最小可行动作,而不是笼统的“继续优化”。
最小状态文件建议
如果 OpenClaw 允许落盘,我建议至少维护这 4 份文件:
spec.md:完整需求和验收标准。sprint-contract.md:当前 sprint 的范围和验收方式。evaluation.md:评估结果、失败原因、回退建议。progress.md:当前进度、阻塞点、下一轮入口。
这套文件不复杂,但很关键。它们就是 Anthropic 这篇文章里反复强调的那种“交接物”。
这个 skill 真正继承了 Anthropic 的什么
如果只保留最核心的思想,我会总结成 4 句:
- 长任务要靠 harness,不要只靠 prompt。
- 主观质量要靠 evaluator,不要只靠自评。
- 跨会话连续性要靠外部状态,不要只靠上下文记忆。
- 系统可靠性来自清晰分工、清晰合同和清晰交接。
把这 4 句落实成一个可调用的 OpenClaw skill,基本就抓住了这篇原文最有用的部分。
参考链接
- Anthropic, “Harness design for long-running application development”(2026-03-24)
https://www.anthropic.com/engineering/harness-design-long-running-apps - Anthropic, “Building agents with the Claude Agent SDK”(2025-09-29)
https://claude.com/blog/building-agents-with-the-claude-agent-sdk - Anthropic, “Effective harnesses for long-running agents”(2025-11-26)
https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents