
本研究的核心结论是:“动态 WebP → MP4”并不天然等于“逐帧解码 WebP → RGBA → YUV → H.264 → MP4”。对于追求极高速度的实现,首先应把输入分成两类,并在入口处做能力判定:
第一类是可以绕过像素域的 WebP。 WebP 有损图像使用 VP8 的帧内编码;动画容器中的每个 ANMF 帧又携带位置、尺寸、持续时间、混合和 disposal 等动画语义。与此同时,VP8 在 ISO Base Media File Format 中已有正式的 vp08 sample entry 和 vpcC 配置定义,而且其 ISO-BMFF binding 将视频 sample 简单映射为 VP8 codec frame。由此可以推导出一个极快路径:当动画的每一帧都是完整画布、无 alpha、VP8 有损帧,且其最终显示结果无需依赖上一帧的局部合成时,可以直接从 WebP 的 VP8 chunk 提取 VP8 bitstream,重新写时间戳后封装为 vp08 ISO-BMFF/MP4;无需 WebP 解码,也无需 H.264/HEVC/AV1 编码。该路径的主要工作量变成 RIFF/ANMF 解析、bitstream 搬运和 MP4 box/sample table 生成,复杂度近似为压缩数据量本身。WebP 规范和 VP8 ISO-BMFF binding 共同支持这一推论。
但这一“copy”路径不是把 WebP 直接变成 H.264/HEVC/AV1。H.264、HEVC 和 AV1 是不同码流语法;若输出必须是这些编码,仍然必须进入像素域重新编码。ISO/IEC 14496-15:2024 明确定义了 AVC、HEVC 等 NAL-unit 视频在 ISO-BMFF 中的承载,而当前 ISO/IEC 14496-12:2026 是 ISO-BMFF 的基础规范。
第二类是必须转码的动画 WebP。 这包括 VP8L 无损帧、局部 ANMF 更新帧、有 alpha、依赖 blend/disposal、需要强制输出 AVC/HEVC/AV1,以及需要严格色彩管理的输入。这里最大的现有实现瓶颈并不是 MP4 mux,而通常是“重复生成完整 RGBA 画布 → 完整帧 RGB/YUV 转换 → 编码器重新扫描整帧”。libwebp 的高层 WebPAnimDecoder 恰好会返回完整重建画布,而且只支持 RGBA/BGRA 一类的动画输出格式;这虽然简单可靠,却不适合极限转码,因为它容易形成一次完整画布写入、一次 RGB→YUV 读取/写入以及编码器再次读取的多次内存遍历。
因此,本报告推荐的总体架构是四级自适应路径:
| 优先级 | 路径 | 核心思路 | 理论延迟潜力 | 推荐条件 |
|---|---|---|---|---|
| A | VP8 bitstream passthrough | ANMF/VP8 → vp08 MP4,不解码、不重编码 | 最低,主要受解析/I/O 限制 | 全画布、无 alpha、VP8、播放器接受 vp08 |
| B | 增量/脏矩形 CPU 转码 | 只解码 WebP frame fragment,维护持久画布,只处理变化区 | 很低 | 局部动画、CPU-only |
| C | GPU/硬件编码流水线 | CPU WebP 解码 + 持久 GPU surface + NVENC/VPL/VideoToolbox | 很低且高吞吐 | 有硬件编码器、输出 AVC/HEVC/AV1 |
| D | 全像素通用回退 | libwebp/FFmpeg 完整重建 → 快速 encoder → fMP4 | 中等 | 任意合法 WebP、优先正确性 |
其中,最值得“重设计编码器”的方向不是另造一个 H.264/HEVC/AV1 语法,而是让 WebP demux/decode 与已有编码器共享更多先验信息:把 ANMF 的更新矩形变成 encoder 的 dirty-block/ROI 信息;把不变宏块直接导向 skip/merge 快路径;对 VP8 有损帧尝试在解码器内部 YUV 域直接输出,而非先转 RGBA;让编码器接收外部 surface;将 muxer 改为逐 sample/fMP4 输出。WebP 的“帧差”必须准确理解为容器级更新矩形和合成依赖,而不是传统视频编码中的运动矢量或残差——WebP 有损帧本身采用 VP8 intra-frame coding,并没有可以直接转交给 H.264/HEVC/AV1 的跨帧运动矢量。
对于“实时”目标,必须用帧预算而不是单纯平均 FPS 判断成功:30 fps 的单帧墙钟预算为 33.33 ms,60 fps 为 16.67 ms;生产级目标应进一步要求 p95/p99 延迟低于预算,并限制队列深度。对直播式或边生成边消费场景,普通 MP4 会产生尾部索引/最终化问题,建议使用 fragmented MP4;FFmpeg 的 MOV/MP4 muxer明确支持 fragmentation,并可按每帧或关键帧切 fragment。
研究目标、约束与平台影响
本报告假设没有固定目标语言、操作系统、ISA 或 GPU,因此设计目标不是一个单一实现,而是一个具有能力探测、自动选择路径、可插拔编码后端的转换引擎。目标函数可以形式化为:
[ min; L_{p99} ]
同时满足:
[ Throughput ge FPS_{target} ]
[ Quality ge Q_{min}, qquad Memory le M_{budget} ]
并尽可能降低:
[ CPU cycles/pixel,quad Memory traffic,quad Hostleftrightarrow Device copies ]
这里最重要的是区分吞吐与延迟。多帧 lookahead、frame threading 和大批次通常能够提高吞吐,却会增加从“输入帧可用”到“输出 sample 可用”的等待时间;x265 的 zerolatency 配置正是通过关闭 B 帧、lookahead、CU-tree,并将 frame threads 设为 1 来压低帧级等待,因此明确牺牲了一部分跨帧并行能力。
不同平台会改变最优路径:
| 平台/硬件 | 主要机会 | 主要限制 | 推荐实现 |
|---|---|---|---|
| 通用 x86-64 CPU | libwebp SIMD/多线程;x264/x265 高度成熟的 CPU 优化 | RGB/YUV 完整帧搬运容易成为带宽瓶颈 | A 路径优先;否则 dirty-rect + x264 zerolatency |
| ARM/Apple Silicon | 高内存带宽、VideoToolbox 硬件编码 | WebP 解码仍需自行处理;CVPixelBuffer 格式转换路径决定复制次数 | 持久 PixelBuffer/Metal surface + VideoToolbox |
| NVIDIA dGPU | NVENC 原生输出 H.264/HEVC/AV1;API支持 YUV/RGB 输入和低延迟工作流 | CPU 解码后的 PCIe 上传可能取代编码成为瓶颈 | CPU 局部解码 → pinned/ring buffer → CUDA/NVENC |
| Intel iGPU/dGPU | Intel VPL GPU Runtime 提供 VP8 decode、AVC/HEVC/AV1 encode 和 VPP 色彩转换 | WebP 的 RIFF、alpha、ANMF 合成仍不是普通 VP8 video decoder 的职责 | 可研究“抽取 VP8 → HW decode → VPP → HW encode”的实验路径 |
| Android | MediaCodec 是低层 codec API;对 raw video 使用 Surface 可避免 ByteBuffer 映射/复制 | 编码能力、profile、分辨率高度依赖设备 | native WebP demux/decode + Surface encoder |
| 无 GPU/服务器容器 | 行为稳定,CPU 可预测 | 4K/60 对软件编码压力大 | x264 ultrafast/zerolatency 或直接 vp08 |
NVIDIA 官方 NVENC API 当前提供 H.264、HEVC、AV1 硬件编码,并明确讨论低延迟以及 fully zero-copy transcoding pipeline;Intel VPL 则提供硬件 encode/decode/VPP 和 zero-copy buffer sharing 能力;Apple VideoToolbox 是直接访问硬件视频编解码器的低层框架,并有专门的 low-delay H.264 编码模式。 Android MediaCodec 文档也明确建议 raw video 使用 Surface,因为它可使用 native video buffer 而不必把像素映射、复制到 ByteBuffer。
这里有一个非常重要的工程判断:硬件编码并不自动等于端到端最低延迟。例如 1920×1080 RGBA 一帧约为 8.29 MB;假设实际 Host→Device 吞吐只有 12 GB/s,仅裸上传理论值已经约为 0.69 ms/帧。3840×2160 RGBA 则约 33.18 MB,对应约 2.76 ms/帧,还没有算解码、同步、色彩转换和 encoder queue。NVIDIA 也专门提醒低延迟工作负载关注 PCIe 链路配置。 因此真正应优化的是端到端 memory topology,而不是单独比较 encoder kernel 的毫秒数。
WebP 与 MP4/视频编码的规范差异
动画 WebP 建立在 RIFF 容器之上。扩展 WebP 可以包含 VP8X、ICC profile、ANIM、多个 ANMF、EXIF/XMP 等 chunk;每个动画帧的 ANMF 描述其画布坐标、宽高、毫秒级 duration、blend 和 dispose 行为,实际视觉帧需要按照这些状态逐帧合成。
ANMF 的核心语义不是“一个视频帧就是一个完整图像”。WebP 允许只给出画布中的矩形更新。blend 可以将带 alpha 的新帧合成到已有画布,dispose 则决定显示完当前帧后是否将该矩形恢复为背景;规范因此要求动画 reader 根据前帧状态重建完整 canvas。 libwebp 的 demux API也直接暴露 x_offset、y_offset、width、height、duration、dispose_method、has_alpha 和 blend_method,说明这些信息天然可以成为转换器的“脏矩形元数据”。
WebP 的有损与无损编码也必须分开考虑。IETF RFC 9649 将 WebP 有损压缩描述为 VP8 intra-frame coding,而 WebP lossless 使用另一套无损编码机制;动画中的 frame data 可以包含 VP8 或 VP8L。因此,“利用 WebP 帧差”并不能从 WebP 中直接得到传统视频 encoder 所需的跨帧运动矢量。
ISO/IEC 14496-12:2026 则定义的是通用的 timed-media 容器模型:容器负责媒体时间、结构和 sample 信息,而真正的视频压缩格式由 sample entry/codec binding 定义。AVC/H.264、HEVC/H.265 等 NAL-unit structured video 在 ISO-BMFF 中的承载由 ISO/IEC 14496-15:2024 定义。
关键差异可归纳如下:
| 特性 | 动画 WebP | MP4/ISO-BMFF 视频轨 | 转换影响 |
|---|---|---|---|
| 容器 | RIFF/chunk | ISO-BMFF box/sample | 必须重建容器元数据 |
| 帧编码 | VP8 intra 或 VP8L | 常见 AVC/HEVC/AV1,也可注册 VP8 vp08 | 只有 VP8→VP8 才存在 bitstream copy 机会 |
| 动画表示 | 局部矩形 + blend + dispose | 通常每个 decoded video picture 是完整呈现图像 | 局部帧通常必须先合成 |
| 时间 | ANMF.duration,毫秒 | media timescale + sample duration | 可选 timescale=1000 做精确毫秒映射 |
| alpha | WebP frame 可含透明度 | 常规 AVC 视频路径通常需先确定透明度处理策略 | 主流兼容路径通常应显式选择背景合成 |
| 色彩 | 可有 ICCP;合成受色彩空间影响 | codec/VUI、vpcC、colr 等表示 | 严格模式不能随意省略色彩管理 |
| 循环 | ANIM 含 loop count | 普通视频 track 的时间轴不等价于 WebP loop 语义 | 应由应用层决定展开次数或保存附加元数据 |
| 流式写出 | chunk 顺序解析 | 普通 MP4 通常最终化 metadata;fMP4 可增量 fragment | 实时输出优先 fMP4 |
最重要的规范级优化机会来自 VP8 ISO-BMFF binding。该规范定义:
VP8SampleEntry extends VisualSampleEntry('vp08')
    └── vpcC
并明确说明 VP8/VP9 的 video sample 使用到 codec frame 的简单映射;VP8/VP9 的 codecInitializationDataSize 为 0。
因此可以得到以下保守、可验证的 passthrough 判定:
所有动画帧:
    codec == VP8 lossy
    && has_alpha == false
    && x == 0 && y == 0
    && frame_width  == canvas_width
    && frame_height == canvas_height
在这种情况下,由于每帧是完整、不透明画布,视觉输出不再依赖上一帧留下的画布内容;可以把每个 WebP VP8 chunk 的payload而不是 RIFF/ANMF/VP8 chunk header 本身写入 vp08 sample。这个结论是基于 WebP compositing 规则和 VP8 ISO-BMFF binding 的工程推论。
应当刻意把这条路径称为 “VP8-in-ISO-BMFF passthrough”,而不是笼统称为 “WebP → MP4 copy”。注册存在并不代表所有目标播放器都实现 vp08 in MP4,因此实际产品必须把“播放器是否接受 vp08”加入 capability negotiation;若目标明确要求 H.264/HEVC/AV1,则 passthrough 自动失效。VP8、AVC、HEVC、AV1 都拥有各自的注册 sample entry,不能通过修改 fourcc 把一个 codec bitstream 伪装成另一个 codec。
另一个容易被忽略的边界情况是 WebP 对很短 duration 的处理:规范对非常短的 frame duration 存在 implementation-dependent 行为,因此高一致性转换器应该提供明确的时间策略,例如 preserve_exact_ms、browser_compatible_clamp 两种模式,而不是假定所有 WebP renderer 对极短帧都一致。
现有开源实现与瓶颈
现有生态足以搭建第一版系统,但若目标是“极限延迟”,需要绕开一些方便但代价高的高层 API。
| 工具/库 | 主要能力 | 编码器支持 | MP4 直接封装 | 并发/硬件 | 许可与备注 |
|---|---|---|---|---|---|
| libwebp | WebP/动画 demux、decode、encode | VP8/WebP lossless | 否 | decoder 有线程选项,项目含 SIMD 配置 | BSD-style/BSD-3-Clause;高层动画 API 输出完整 RGBA 类画布 |
| FFmpeg libavcodec/libavformat | WebP decode、色彩转换、各种视频 encoder wrapper、MP4 mux | H.264/HEVC/AV1/VPx 等,依构建配置 | 是 | 软件线程及 NVENC/VAAPI 等硬件路径 | 核心主要 LGPL;启用 GPL 组件会影响整体许可条件 |
| x264 | H.264/AVC 软件编码 | H.264 | 编码库本身否 | frame/slice threading;适合 sliced low-latency | GPL-2.0;NAL 可直接输出 MP4-style length-prefixed 数据 |
| x265 | HEVC 软件编码 | HEVC | 否 | frame/WPP 等并行 | GPL-2.0 或商业许可;zerolatency 会关闭大量跨帧工具 |
| rav1e | Rust AV1 encoder | AV1 | 编码库本身否 | Rayon threading;高 speed level 面向 near-real-time | BSD-2-Clause + AOM Patent License;FFmpeg 支持 low_latency=true |
| libaom | AOM AV1 reference/production encoder | AV1 | 否 | threads、tiles、row-mt、lookahead 可配置 | BSD-2-Clause + AOM Patent License |
| NVENC API/FFmpeg NVENC | GPU 固定功能编码 | H.264/HEVC/AV1 | 需 muxer | 硬件编码、同步/异步接口 | NVIDIA SDK/driver API;适合与 libavformat 组合 |
| Intel VPL | GPU decode/VPP/encode | VP8 decode;AVC/HEVC/AV1 encode 等 | 需 muxer | 硬件 surface、VPP、zero-copy API | Dispatcher/GPU runtime 为开放组件,GPU runtime MIT |
FFmpeg 当前源码中已经存在 animated WebP decoder,而 libavformat 提供通用 packet/mux 抽象,因此它非常适合做系统整合层。 但使用“标准 FFmpeg filter graph 全帧走一遍”的做法不一定适合极限延迟,因为任意一次隐式 format/scale filter 都可能带来完整帧 conversion;FFmpeg 官方文档也明确指出 scale 在上下游 pixel format 不一致时会执行像素格式转换。
libwebp 的高层动画 API 是另一个关键瓶颈候选。WebPAnimDecoderGetNext() 返回的是已经完整重建的 canvas_width × canvas_height × 4 画布,而不是 ANMF 子矩形,并且动画 decoder 的公开输出颜色模式限定为 RGBA、BGRA、premultiplied RGBA/BGRA 一类。 对于 4K 动画,即使某一帧只有 5% 区域变化,高层路径仍会暴露完整 4K×RGBA canvas,随后 H.264 encoder 又通常需要 NV12/YUV420;这是本项目最值得消除的数据运动之一。
更合适的入口是 WebPDemuxGetFrame():它直接提供 frame fragment、位置、尺寸、duration、alpha、blend 和 disposal。官方示例明确说明可以对每个 iter.fragment 单独调用 WebPDecode。 这意味着可以把:
WebPAnimDecoder → 完整RGBA画布
改成:
WebPDemux
   → 独立解码 ANMF fragment
   → 只更新持久 canvas 的 dirty rectangle
对于需要边接收边转换的数据源,libwebp 还提供 incremental decoder:通过 WebPIAppend() 边获得新字节边解码,并允许调用 WebPIDecGetRGB() / WebPIDecGetYUVA() 获取目前已经可用的数据;高级 decode API还允许调用方提供 external output buffer。 这对于“WebP 尚未完整到达就开始转换”的网络场景很重要。
编码侧,x264 有两个尤其适合本项目的接口特征。其输出 NAL 可以使用 4-byte length prefix,即 MP4 类 mux 所需的 sample 数据表示;并且 nalu_process callback 可以在整帧编码结束前取得已经编码完成的 NAL,不过该模式与 frame-based threading 不兼容,需要无 frame threads 或 sliced threads。 这意味着若目标是“first output byte latency”而非仅“frame completion latency”,可以进一步做 slice→mux 的细粒度流水线。
FFmpeg 的 libx264 wrapper还支持通过 AVFrameSideData 设置 mb_info,为把 WebP 的 dirty-block 信息下推到 encoder 提供了现成扩展点。 对 AV1,libaom wrapper 暴露 lag-in-frames、threading 等参数,rav1e 在 FFmpeg 中可以直接设置 speed=...:low_latency=true。
超低延迟算法设计
建议实现四种而不是单一算法。运行时先做一次轻量 probe,再选择最便宜且语义正确的路径。
策略 A:VP8 bitstream 直接重新封装
否是读取 RIFF/VP8X/ANIM扫描 ANMF全部满足
VP8/全画布/无Alpha?转码路径提取 VP8 chunk payload写 vp08 sample
映射 duration/PTSISO-BMFF / fMP4显示代码
其正确性基础是:WebP 有损帧采用 VP8 intra-frame coding,而 VP8 ISO-BMFF binding 定义 vp08 sample entry,并将 video sample 直接映射至 codec frame。
令第 (i) 帧的压缩 VP8 payload 为 (S_i),帧数为 (N),则时间复杂度大体为:
[ T_A = Oleft(N+sum_i S_iright) ]
空间复杂度可以做到:
[ M_A = O(S_{max}) ]
若 muxer 支持 scatter/gather 或直接引用输入 buffer,甚至可以趋近于 metadata-only 操作。这里没有 (Wtimes H) 级像素复杂度。
该路径的端到端延迟理论上由 parse + copy/write + mux 决定。举例而非实测:若一个 compressed frame 为 0.5 MB,内存有效带宽假设 20 GB/s,裸 memcpy 下界只有约 25 μs;因此真正值得优化的是 box/sample metadata、I/O syscalls 和 buffer ownership,而不是 SIMD 图像算法。
优点是无额外有损、CPU 极低、first-frame latency 极低。缺点是适用范围严格,而且 vp08 MP4 的终端兼容性必须单独验证。若输出要求 AVC、HEVC、AV1,这条路径完全不可用。
策略 B:持久画布 + ANMF 脏矩形增量转码
WebPDemux ANMF并行解码 frame fragment得到局部像素块持久 Canvas按 blend/dispose 更新 dirty rect仅转换 dirty rect 到编码像素格式dirty-map / ROI 提示低延迟软件编码fMP4 mux显示代码
该设计直接利用 WebPIterator 暴露的 frame rectangle、blend、dispose 和 alpha 信息,而不是先让 WebPAnimDecoder 为每帧生成完整 RGBA canvas。
若 canvas 面积为 (A=Wtimes H),第 (i) 帧 dirty rectangle 面积为 (D_i),那么合成和色彩转换理论工作量可从:
[ O(NA) ]
降低到:
[ Oleft(sum_i D_iright) ]
但标准软件 encoder 若没有接受 dirty-map,仍可能扫描整个 (A)。所以真正的收益需要 encoder 侧配合:静态块采用 skip/merge 快路径,或至少跳过昂贵 motion search/RDO。FFmpeg 对 x264 暴露的 mb_info 是一个可利用的入口。
这一策略还有一个重要的并行机会:WebP 有损 frame 是 intra-coded,而 demux API 能独立取到各 frame fragment,因此可以“预解码未来若干 ANMF fragment”;真正依赖顺序的是随后执行的 canvas blend/dispose。 推荐线程模型不是“N 个线程各自重建完整动画”,而是:
demux thread
    ↓
frame-fragment decode worker pool
    ↓
ordered composition thread
    ↓
conversion/encoder pipeline
这样既保留顺序语义,又利用 frame fragment 的独立解码能力。
策略 C:融合像素流水线 + 低延迟软件编码
是否ANMF fragmentWebP decode可用 YUV/YUVA
快速路径?直接写 encoder surface局部 RGBA融合 composite + RGB→YUV低延迟 x264/x265/rav1e立即 mux packet显示代码
这里的重设计目标是消除:
decode → RGBA buffer
RGBA → full canvas
full canvas → RGB2YUV temporary
temporary → encoder input copy
把它压成:
decode/composite/convert → encoder-owned surface
libwebp 高级 API允许调用者提供 external output memory,因此可以首先消除 decoder 内部额外 allocation/copy。 更激进的实现则修改 libwebp 或建立专用 decode backend,让 VP8 有损路径尽可能早地暴露 YUV plane;但对于有 alpha、ICC 和严格 WebP blending 的帧,要保留规范正确的合成 fallback,不能为了速度强行在错误的颜色空间中做 alpha blend。WebP 规范明确规定动画画布合成过程,因而这种 shortcut 应属于可配置的 fast mode,而不是默认正确模式。
x264 可采用 ultrafast + zerolatency 类配置,核心原则是关闭 B 帧和 lookahead;x265 的源码则明确显示 zerolatency 将 B 帧、lookahead、scene cut、CU-tree 等关闭,并将 frame threads 限为 1。 对 rav1e,FFmpeg 官方示例直接给出了 low_latency=true。
策略 D:GPU/VPU 持久 surface 硬件流水线
WebP demux/decode CPU局部更新 staging bufferGPU persistent canvasGPU composite + colorspaceNV12/P010 surfaceNVENC / VPL / VideoToolboxbitstream ringfMP4 mux显示代码
NVIDIA NVENC 接收 YUV 或 RGB raw frame并输出 H.264/HEVC/AV1,Intel VPL 可提供硬件视频处理和 encode,VideoToolbox 提供 Apple 平台的低层硬件编解码访问。
这条路径的稳态吞吐可以近似为:
[ FPS_{steady} approx frac{1} {max(T_{decode},T_{upload},T_{compose},T_{encode},T_{mux})} ]
而单帧端到端延迟近似为:
[ L_{frame}approx T_{decode}+T_{upload}+T_{compose}+T_{encode}+T_{mux}+T_{queue} ]
所以 GPU pipeline 的关键不是无限增大 queue,而是保持每个 stage 有工作,同时把 queue depth 限制在 1–3 帧左右进行实验调优。无限队列可以让 FPS 很漂亮,却会把 p99 latency 拉高。
Intel 平台还值得做一个实验性分支:
ANMF
 → 提取裸 VP8 payload
 → Intel VPL VP8 hardware decode
 → GPU surface
 → VPP/composite
 → AVC/HEVC/AV1 hardware encode
Intel VPL GPU Runtime 当前明确列出 VP8 decoder 以及 AVC/HEVC/AV1 encoder,并提供 composition/color conversion filter。 但这并不能绕过 WebP 的 alpha、ANMF positioning、blend/disposal;因此必须由上层 parser/compositor补充这些 WebP 专属语义,不能简单把整个 .webp 文件扔给普通 VP8 video decoder。
综合选择逻辑应当是:
                 ┌─ vp08 MP4 accepted + passthrough eligible ─→ A
Input WebP ─probe┤
                 ├─ hardware encoder available ───────────────→ D
                 ├─ large dirty-rect savings ─────────────────→ B
                 └─ otherwise ────────────────────────────────→ C
编码器与封装器的具体重设计
最值得实现的是一个WebP-aware video encoder front-end,而不是修改 H.264/HEVC/AV1 标准码流本身。它向编码后端提供除了 pixel planes 之外的结构化 side information:
struct WebPFrameHints {
    Rect dirty_rect;
    bool full_canvas;
    bool has_alpha;
    BlendMode blend;
    DisposeMode dispose;

    // Encoder hints generated after composition.
    BlockMap changed_blocks;
    uint64_t pts;
    uint64_t duration;
};
这些信息直接来自 WebP demux 层暴露的 offsets、dimensions、duration、blend/dispose/alpha。
最关键的编码器修改有六类。
直接建立 passthrough backend。 不调用 decoder/encoder,只生成 MP4 sample:
Status handle_frame(const WebPFrame& f) {
    if (!f.is_vp8_lossy ||
        f.has_alpha ||
        f.x != 0 || f.y != 0 ||
        f.width != canvas_width ||
        f.height != canvas_height) {
        return NEED_TRANSCODE;
    }

    ByteSpan vp8 = extract_chunk_payload(f.fragment, "VP8 ");
    mux.write_vp08_sample(
        vp8,
        /*pts=*/timeline_ms,
        /*duration=*/f.duration_ms,
        /*sync=*/true
    );
    timeline_ms += f.duration_ms;
    return OK;
}
这里必须抽取的是 VP8 chunk 的 payload,而不是将 WebP RIFF/ANMF chunk header 一起写进去,因为 ISO-BMFF VP8 sample 对应 codec frame。
把完整 canvas 变成持久 surface。 不再每帧 malloc/free:
Canvas canvas = pool.acquire_persistent_canvas(W, H);

for (Frame f : frames) {
    Surface patch = decode_pool.decode(f.fragment);

    composite_rect(
        canvas,
        patch,
        f.x, f.y,
        f.blend
    );

    encoder.submit(
        canvas.encoder_view(),
        f.pts,
        make_dirty_map(f.rect)
    );

    apply_disposal(canvas, f);
}
libwebp 官方 decode API允许调用者提供外部 memory buffer,这使 decoder 可以直接写入池化内存,而不必每帧自己分配。
把 dirty rectangle 下推到块级 encoder。 对 16×16 H.264 macroblock 或 HEVC/AV1 block hierarchy,生成:
[ changed(b)= begin{cases} 1,&bcap dirty_rect neq emptyset 0,&otherwise end{cases} ]
对 changed=0 区域优先检查“直接预测上一重建帧 + zero residual”是否足够;若成立,跳过完整 motion-search 候选集和昂贵 RDO。对于 x264,FFmpeg wrapper 已提供 mb_info side data 入口,因此可以先做插件式原型,再考虑直接修改 x264 内部搜索流程。
伪代码如下:
for (Block b : current_frame.blocks()) {
    if (!dirty_map[b]) {
        Candidate skip = encoder.try_temporal_skip(b);

        if (skip.is_valid && skip.fast_cost < FAST_SKIP_THRESHOLD) {
            encoder.commit(skip);
            continue;
        }
    }

    encoder.normal_mode_search(b);
}
注意:WebP dirty rect 只是一个很强的“哪里可能变了”的先验,不等价于最终视频 codec 的 residual。因此 encoder 仍需保证标准码流和重建结果正确,不能简单不编码 canvas 之外的数据。WebP 本身的跨帧语义来自画布组合,而不是 motion vector。
融合 composite 和 RGB→YUV。 对非严格色彩模式,可以设计 SIMD/GPU kernel,在读取 WebP patch 时同时完成 alpha blend、chroma downsample 和 NV12 写入:
load previous canvas pixels
load WebP patch pixels
    ↓
blend
    ↓
RGB → Y
2×2 aggregate → U/V
    ↓
write NV12 encoder surface
这样 dirty area 中的 source pixels 只需要进入 cache/register 一次。严格 ICC/线性光合成模式应保留独立、规范正确的 color-management path;WebP 容器规范明确涉及 ICC 和正确的动画 blending 行为。
把 encoder input surface 的 ownership 交给 buffer pool。 FFmpeg 的 send/receive codec API适合 refcounted packet/frame 生命周期,因此实现时应维持固定大小 ring:
Surface[0] → encoding
Surface[1] → composing
Surface[2] → decoding next patch
而不是:
malloc → decode → malloc → convert → malloc → encode → free
FFmpeg 的 libavcodec API本身就是以 packet/frame 为核心的异步 send/receive 模型。
重写 mux 的低延迟策略。 对实时输出不要先收完整动画再生成 MP4;初始化 ftyp/moov 后持续写 fragment。FFmpeg MOV/MP4 muxer支持 frag_every_frame、frag_keyframe 和由 API 主动决定 fragment 边界的 frag_custom。 对非常短的动画,可以每帧 fragment;对长动画可 2–8 帧一 fragment,在 mux overhead 与 first-byte latency 之间做实验。
x264 还提供更激进的 NAL callback:NAL 可以在整帧结束前传给调用者,而且 length-prefixed 格式本身适合 MP4 类 mux。 因此对极端场景可以设计:
slice encode
   ↓
nalu_process()
   ↓
fragment builder
   ↓
I/O thread
不过该接口与 frame-based threads 的组合受限制,因此只有真正需要“sub-frame first-byte latency”时才值得启用。
性能工程、基准与实验评估
实际优化首先应测“字节去哪了”,而不是只测 encoder FPS。建议为每一帧打如下时间戳:
t0 input bytes available
t1 ANMF parsed
t2 fragment decoded
t3 composition complete
t4 encoder surface ready
t5 encoder accepted
t6 first encoded byte
t7 complete encoded sample
t8 first muxed output byte
t9 output write complete
然后报告:
[ L_{decode}=t_2-t_1 ]
[ L_{encode}=t_7-t_4 ]
[ L_{first-byte}=t_8-t_0 ]
[ L_{E2E}=t_9-t_0 ]
同时必须给出 p50、p95、p99,而不是只给平均值。队列等待应单独记作 queue_wait_ns,否则一个吞吐很高、但排队 200 ms 的 pipeline 会被错误评估为“快”。
推荐的验收指标如下:
| 类别 | 指标 | 建议测量 |
|---|---|---|
| 延迟 | first-frame latency、frame E2E p50/p95/p99 | monotonic high-resolution clock |
| 吞吐 | decoded/encoded FPS、animations/s | 稳态窗口,剔除初始化阶段后另报 warm start |
| CPU | 总 CPU%、core utilization、cycles/pixel | perf/ETW/Instruments 等平台工具 |
| GPU | encoder engine%、compute%、copy engine% | 厂商 profiler/API |
| 内存 | RSS、peak RSS、bytes allocated/frame | allocator hooks + OS counters |
| 内存流量 | DRAM read/write、H2D/D2H bytes | PMU / GPU profiler |
| 输出 | bitrate、bytes/frame、mux overhead | container/sample statistics |
| 质量 | PSNR、SSIM;必要时另加感知指标 | 先统一 PTS、尺寸、像素格式再逐帧比较 |
| 正确性 | frame hash/visual canvas diff、duration error | 与 libwebp 参考重建比较 |
FFmpeg 官方提供 PSNR 和 SSIM filter,并能生成逐帧统计;PSNR filter明确从 MSE 计算结果,SSIM filter可以记录每帧及分量指标。
质量基准不能直接拿“原始 ANMF patch”与 MP4 decoded frame 比较。正确参考应是:
WebP
 → 规范化完整画布重建
 → 如果输出不保留 alpha,按同一背景 flatten
 → 统一 timestamps
 → Reference RGB/YUV frames
再与:
MP4
 → 独立 decoder
 → 相同 pixel format / range
 → 对齐 PTS
比较。高层 WebPAnimDecoder 会返回完整重建 canvas,因此适合作为“正确性 reference implementation”,即使它并不适合作为性能最快的生产路径。
实验矩阵建议覆盖如下维度:
| 变量 | 取值 |
|---|---|
| 分辨率 | 320×240、640×360、1280×720、1920×1080、3840×2160 |
| 时间模式 | 15/30/60 fps 等效 duration;VFR;随机 duration |
| dirty area | 1%、5%、25%、50%、100% |
| 帧类型 | VP8 全画布、VP8 局部、VP8L、VP8/VP8L 混合 |
| alpha | 无、稀疏 alpha、大面积半透明 |
| blend/dispose | overwrite/blend × keep/background |
| 帧数 | 2、10、30、100、1000 |
| 输出 codec | vp08 passthrough、H.264、HEVC、AV1 |
| GOP | all-intra、15、30、60;低延迟无 B 帧 |
| 软件 encoder | x264、x265、rav1e、libaom |
| encoder speed | ultrafast/fast 类 presets 或各自 speed/cpu-used 梯度 |
| 硬件 | NVIDIA NVENC、Intel VPL、Apple VideoToolbox、Android MediaCodec |
| mux | 普通 MP4、每帧 fMP4、GOP fragment |
| 内存策略 | malloc-per-frame、pool、external memory、GPU persistent surface |
| thread depth | 1、2、4、8、自动 |
| pipeline queue | 1、2、3、6、unbounded 对照组 |
rav1e 明确提供 speed levels 并以高 speed level 的 near-real-time 编码为设计目标;libaom/FFmpeg wrapper提供 threads、lookahead/lag 等调节项;x265 的 zerolatency 则可以作为“最低排队 vs 正常 preset”的重要对照。
建议每次实验输出这样的原始对比表,而不是只保留“最佳结果”:
| Path | Codec | Resolution | Dirty % | HW | p50 ms | p95 ms | p99 ms | FPS | CPU % | GPU % | Peak MB | Mbps | PSNR | SSIM |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| A passthrough | VP8 | 1080p | 100 | CPU | 实测 | 实测 | 实测 | 实测 | 实测 | — | 实测 | 原码率 | 无代际损失* | 无代际损失* |
| B dirty CPU | H.264 | 1080p | 5 | x264 | 实测 | 实测 | 实测 | 实测 | 实测 | — | 实测 | 实测 | 实测 | 实测 |
| C fused CPU | H.264 | 1080p | 100 | x264 | 实测 | 实测 | 实测 | 实测 | 实测 | — | 实测 | 实测 | 实测 | 实测 |
| D GPU | H.264 | 1080p | 25 | NVENC | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 | 实测 |
* 只有 passthrough 的 WebP 动画语义和颜色表现满足前述前提时,才可视为没有新增视频重编码代际损失;不是说播放器输出必然与任意 WebP renderer 在色彩管理上逐像素相同。该限定来自 WebP compositing/color semantics 与 VP8 ISO-BMFF 映射的差异。
实验产出至少应包含两张 Pareto 图,而不是柱状图堆叠平均值:
吞吐 FPS ↑

高 │                    · A: vp08 copy
   │
   │              · D: hardware
   │        · B: dirty-aware
   │   · C: generic software
低 └────────────────────────────→ p99 延迟 ms
    低                         高
上图只是预期关系示意,不是实测数据。正式报告中每个点应来自同一输入集合、相同并发度和相同 I/O 条件,并用误差条表示多次运行分布。
第二张图应画质量—速度 Pareto front:
质量 PSNR/SSIM ↑

高 │  ·············· 可接受 Pareto 前沿
   │      ·
   │          ·
   │              ·
低 └────────────────────────────→ 编码速度 FPS
    慢                         快
这里不能把不同 bitrate 的 encoder 直接比较。应至少做两套实验:一套固定 bitrate 比质量,一套固定质量目标比速度/码率。否则“ultrafast 更快但文件更大”和“slow 更慢但更省码率”会被混在一个不可解释的数字里。
并行化建议采用层次化而非一味加线程:
跨文件并行
    ↓
单动画 frame-fragment 预解码并行
    ↓
有序 canvas composition
    ↓
tile/SIMD color conversion
    ↓
encoder 内部 slice/WPP/tile parallelism
WebP frame fragment 可通过 demux 单独取得,但动画 canvas 的 blend/dispose 是有序依赖;因此把 composition 本身随意乱序并行会破坏动画语义。
对短动画,encoder 初始化可能占总时间很大,应额外报告 cold-start 与 warm-session 两组结果;生产服务器可以维持 encoder/session pool,但只能在尺寸、像素格式、codec profile 等兼容时复用。对长动画则应重点关注 steady-state 和内存增长。普通 MP4 muxer为了最终 metadata 会保留更多全局状态,而 fragmented MP4 把 packet metadata 与 fragment 一起写出,更符合长时实时场景。
风险、限制与未来工作
最大的风险是错误地把 WebP 动画看成普通视频帧序列。ANMF 可以只是局部 rectangle,具有 blend/dispose,并可能携带 alpha;忽略任意一项都可能得到“能播放但内容错”的 MP4。最可靠的 correctness oracle 应继续使用规范实现的完整 canvas 重建进行逐帧比对。
第二个风险是过度宣传 direct copy。VP8 in ISO-BMFF 确实有正式 binding 和 vp08 sample entry,但该路径只解决“容器重封装”,不解决 H.264/HEVC/AV1 输出需求,也不能天然表达 WebP 的 alpha + partial-frame compositing。 因此工程上应该让它成为“最高优先级 capability path”,而绝不能成为唯一实现。
第三个风险是色彩和透明度。WebP 可以包含 ICC profile,动画 blending 的视觉结果与颜色空间相关;快速路径若随意假定颜色空间、直接在 gamma-coded RGB 或 YUV 中混合,可能在半透明边缘出现系统性误差。FFmpeg MOV muxer甚至提供优先写 ICC colr 信息的选项,说明色彩 metadata 不应被视为无关字段。 推荐产品定义两个明确模式:strict_color 保证参考渲染一致性,fast_srgb 接受受控近似并通过 PSNR/SSIM/视觉测试量化误差。
第四个风险是 alpha 的目标语义。常见的 H.264 实时输出链并不能简单继承 WebP 的 RGBA 动画语义,所以 API 必须要求或默认定义 background_color,并在转码前 flatten;不能静默丢 alpha。若未来目标生态明确支持具有 alpha 的特定 HEVC/AV1/ISO-BMFF 工作流,再做单独 profile,而不要让它污染最常见的低延迟路径。
第五个风险是许可。libwebp 的宽松 BSD-style 许可对嵌入较友好;FFmpeg 核心主要是 LGPL,但构建时加入 x264/x265 等 GPL 组件会改变最终发行物需要遵守的许可条件;x264 是 GPL-2.0 系,x265 同样提供 GPL 与商业许可;rav1e 和 libaom 则采用 BSD-2-Clause 并带 AOMedia patent license。产品化前需要把“动态链接/静态链接、是否启用 GPL encoder、最终二进制分发模式”加入构建矩阵,而不是开发结束后再处理。
第六个风险是硬件路径的隐藏复制。NVENC、VPL、VideoToolbox 或 MediaCodec 都可能拥有非常快的 encoder,但如果前面仍然是“CPU WebP → 完整 RGBA → memcpy → GPU → GPU RGB→NV12”,4K 场景可能首先受内存/PCIe 限制。NVIDIA、Intel 和 Android 官方接口都提供了围绕 surface、zero-copy 或 native video buffer 的机制,因此真正的硬件后端 API 应抽象为“surface ownership + fence”,而不是 encode(uint8_t *rgba)。
未来工作的优先顺序建议是:
最高价值的第一阶段应实现 WebPDemux probe、完整 correctness fallback 和 vp08 passthrough。这样可以快速验证“有多少真实业务输入能够完全避免转码”,同时建立规范测试基线。libwebp 已经暴露足够的 frame metadata,使这一阶段不需要修改 decoder。
第二阶段应实现持久 canvas、external buffer、dirty-rect conversion 和 bounded pipeline,把现有 RGBA 全帧搬运次数用硬件 PMU/allocator tracing 定量化。libwebp 的 external-memory decode 能力可以在不 fork 库的情况下先实现一部分零拷贝。
第三阶段再修改编码器前端,让 WebP dirty map 进入 x264/其他 encoder 的 block decision。先利用 FFmpeg 已有 mb_info 做原型,然后用 profile 证明 motion search/RDO 是否真的从“不变区域”被消除,再决定是否维护 encoder fork。
第四阶段应做 NVIDIA、Intel 和 Apple 三种硬件 backend。尤其值得实验 Intel 的“抽取 VP8 → VPL VP8 hardware decoder → VPP → hardware encoder”路径,因为 Intel GPU runtime同时列出了 VP8 decode、composition/color conversion 和 AVC/HEVC/AV1 encode;若实测接受 WebP 中抽出的合法 VP8 intra payload,这可能将有损、无 alpha WebP 的“必须输出 H.264/HEVC/AV1”场景进一步变成近乎全 GPU 流水线。该兼容性需要真实驱动和设备验证,当前应视为研究假设,而不是已证明特性。
最终推荐的生产架构因此不是单一“WebP→MP4 encoder”,而是:
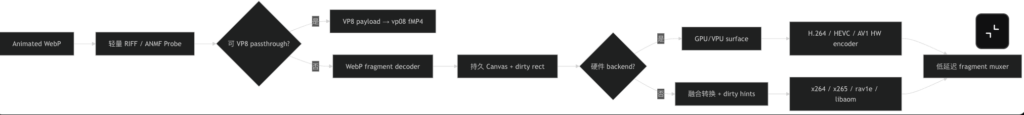
这一设计把速度优化按收益从高到低排列为:先消灭不必要的编码,再消灭完整帧重建,再消灭色彩转换和内存复制,再降低 encoder 搜索复杂度,最后才是继续微调 SIMD 或线程数。WebP/ISO-BMFF 规范、libwebp 当前 API、FFmpeg 的 fragmented MP4 和主流 encoder 的低延迟接口共同表明,这比单纯“换一个更快 preset”更有可能获得数量级上的端到端延迟改善。
