
四条链接关系,零条警告,抓到一页。在一个正确实现 RFC 8288 附录 B 的解析器眼里,GitHub 风格的分页头就是这个样子;可这同样是一个永远走不到第二页的爬虫的样子。Link 头不是供你阅读的字段,它是一条要你执行的指令,解析器又比爬虫宽容得多。
解析干净,不等于链是通的
我把一个 GitHub 风格的分页头粘进HTTP Link Header RFC 8288 解析器与分页爬虫预览,基址填的是本地 API 地址。报告说:解析出 4 条链接,分页关系集合完整,0 条警告,抓取链长度 1 页。
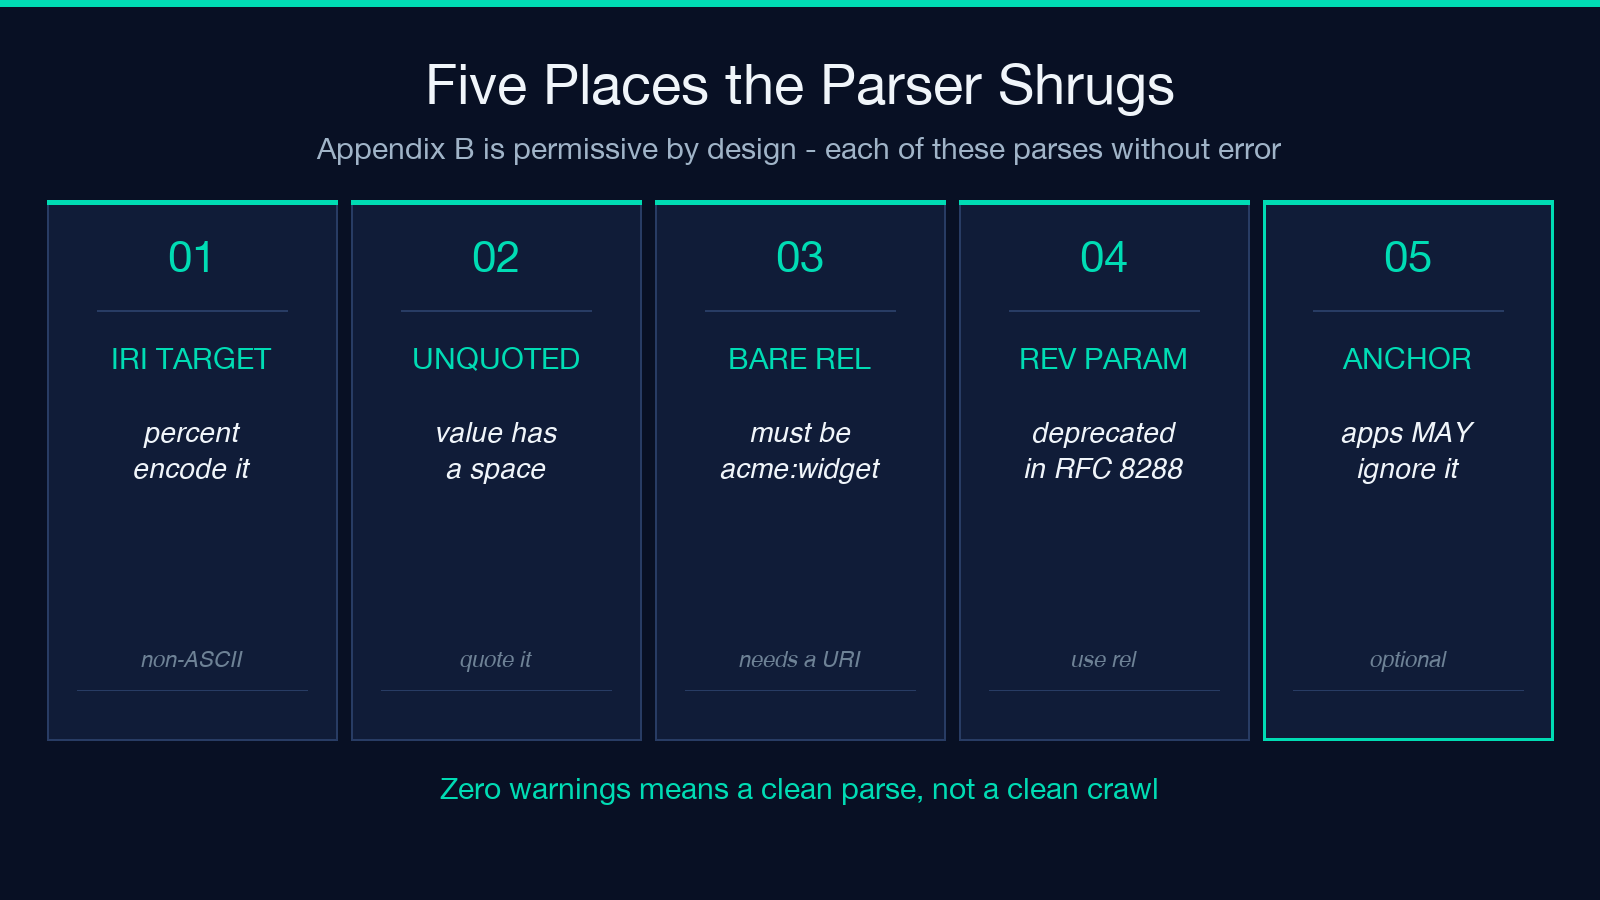
这四个数字里有三个都在说可以上线了。第四个说爬虫还没起步就停了,四个数字里只有它描述的是客户端实际做了什么。
两个数字量的是两件事。linkCount 数的是你的头声明了多少链接,chainLength 数的是爬虫顺着 rel="next" 从一个响应走到下一个响应时真正抵达了多少页。一个头可以在第一个指标上满分,在第二个指标上一无所获,因为解析是单个响应里的事,抓取却是一段序列。工具两个都报,因为谁也替代不了谁;只问「头能不能解析」的审计,会放过那些没有任何客户端走得通的头。
每个响应都在前一页的上下文里被解读
正是这个细节在悄悄搞坏真实的爬虫,而它是规范里的一个设计决定,不是缺陷。
像 </api/items?page=2> 这样的相对目标是一个 URI 引用。RFC 3986 第 5.2 节要求拿它去对照一个上下文 URL 解析;在抓取模拟里,第 2 页的上下文是第 1 页 rel="next" 解析后的结果,不是你填进表单的那个基址。基址只决定一行的上下文:第 1 页读你的基址,之后的每一行读的是上一页的 next。
举个例子,粘进三行的情况是这样解析的:第 1 页的上下文是你的基址,第 1 页的 next 成为第 2 页的上下文,第 2 页的头再拿第 2 页的地址去读。把同样的三行倒过来粘,每个相对目标都会落到别处,既没有警告也没有报错。爬取表专门给上下文 URL 留了一列,原因就在这里;读解析后的链接之前,先读这一列。
由此还能推出一条:响应体自带的 <base> 元素从不参与计算。RFC 8288 的链接按 URL() 语义针对响应 URL 解析,所以在浏览器里好用的 API,换到一个根本不解析 HTML 的爬虫里就可能断掉。
两个 rel=“next” 等于一次静默的抛硬币
附录 B 是一个有意写得宽容的解析器,而宽容的解析器会把手误变成路由决策。
写成 ; rel="next"; rel="last",第二个 rel 直接被忽略。解析照样成功,第一个关系胜出,last 悄无声息地消失。分析器检查的是最要命的那种情况:一个响应里带了不止一个 rel="next",报告会提醒你爬虫只跟第一个。两个互相竞争的下一条链接不是平局,它们逼着做一次选择,而你的客户端做的选择可能和你不一样。
同样的宽容也出现在空引用上。按 RFC 3986 第 5.2.2 节,单独的 <> 会解析成响应 URL 去掉片段后的地址,于是一条看着像被截断的链接可能完全合法,而且正指着你当前所在的页面。分页死循环就是由这个形状搭起来的,这也是天真审计永远看不见的那条线索。
分页集合完不完整,是第一页的属性
分析器的 paginationComplete 标记只问一个很窄的问题:第一个响应是否同时给出了 first、prev、next 和 last 这四条?它只读第 1 行的关系集合。
审计分页 API 时这一点很关键,因为「完整」是对入口页的断言。第 3 页带了一整套齐整的 first/prev/next/last,证明不了第 1 页如何;一个靠读第一页来发现分页的客户端,永远看不到那一套。徽标是绿的,说明你的入口页对外宣称了一套完整的导航;徽标是红的而第 1 页的 next 又能用,说明你有一条走得通的链,配一张不完整的地图。这是两个不同的缺陷,需要两种不同的修法。我第一次测试用的那个头正好就是这种分裂:第 1 行集合完整,链却在爬完一页后结束,因为没有第二个响应可以走。
宽容的解析器在五个具体地方耸肩
报告里的警告面板,把规范里那些建议性的措辞变成了能动手的东西,它会告诉你撞上了五种里的哪一种。下面五项检查承担了大部分价值:
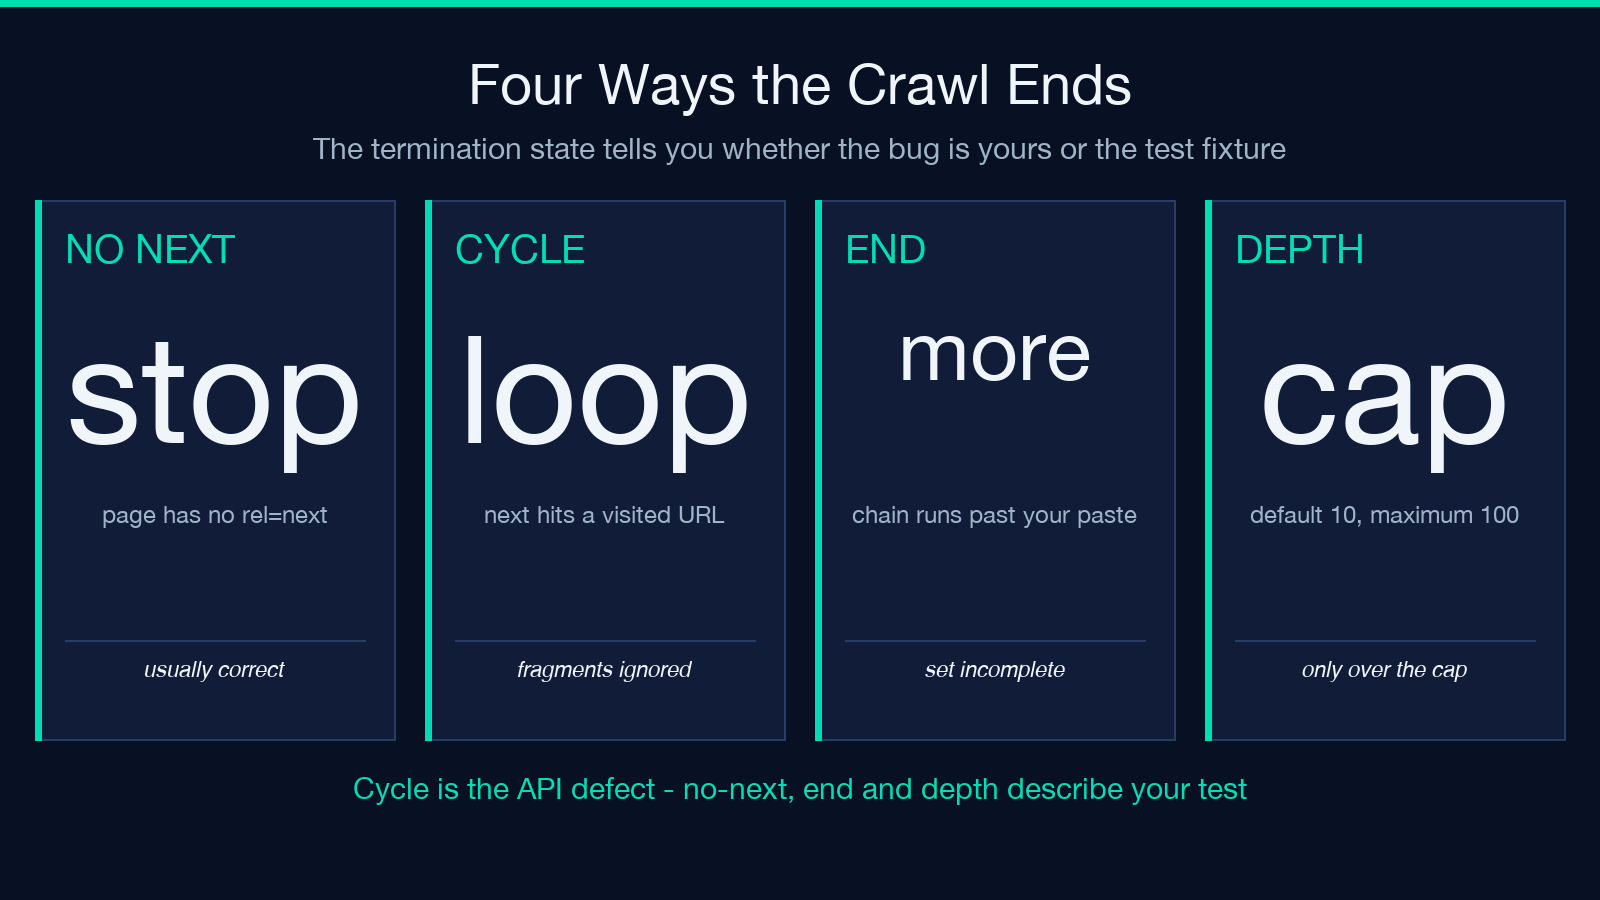
- 非 ASCII 目标。带原始国际字符的目标是一个 IRI,而 Link 头里的目标必须按 RFC 3986 做 URI 编码。要么你自己做百分号编码,要么让客户端去决定要不要猜。
- 含空白却没加引号的值。带空格又没有用引号包起来的参数值,在技术上无效。发送方必须给不是合法 token 的值加引号,解析器只是容忍了它。
- 不是绝对 URI 的扩展关系类型。分析器对照的注册表里有 133 个 IANA 注册的关系名,所以
rel="previous"能被识别,rel="prev-page"不能。私有关系必须写成acme:widget这种样子:一个裸的自定义词既没有注册,也不是 URI,只好落进警告列表。其余围绕请求头的工具都归在同一个网络分类下。 - 已弃用的 rev 参数。RFC 8288 第 3.3 节已经把它撤掉了。反向关系应该放进专门的 rel 类型里,
rev现在只是一个普通属性,客户端可以忽略。 - anchor 参数。带
anchor的链接会在锚点的上下文里解读,而不是在响应 URL 的上下文里;第 3.2 节还允许应用完全忽略这类链接。如果你的分页目标挂在一条带 anchor 的链接上,你就把头里最重要的那个关系变成了可选项。
没有 as 的 preload,是一个你提不出的优先级请求
资源提示和分页指标共用同一个头,它们的失败方式不一样:提示不会弄断抓取,只是永远拿不到你想要的那点优化。
rel="preload" 如果不带 as 参数就会触发警告,因为浏览器无法给这次抓取分类,也就无法把它排到已知资源的优先级里去。合法的目的地有十二个:Audio、document、embed、fetch、font、image、object、script、style、track、video、worker。除非 as="fetch",否则 type 参数应当写成 MIME 类型的样子,不然这次预加载可能被悄悄丢掉。举例来说,字体预加载少了 crossorigin 属性,文件可能被抓两次。
分析器跟踪六种提示关系:preload、prefetch、preconnect、dns-prefetch、modulepreload 和 prerender,并为每条提示打印一张表,列出 as、type、crossorigin 和 fetchpriority。前面那个三页抓取的例子里,最后一个响应只带了一条针对哈希脚本的 preload,提示计数因此变成 1,这个资源的说明也就留在人能找到的地方。
只有终止状态算得上真诊断
链报告只有说清了行走为何停下才有用,因为终止状态决定你该修什么。工具一共命名了七种终止状态,其中四种是你常会遇到的:
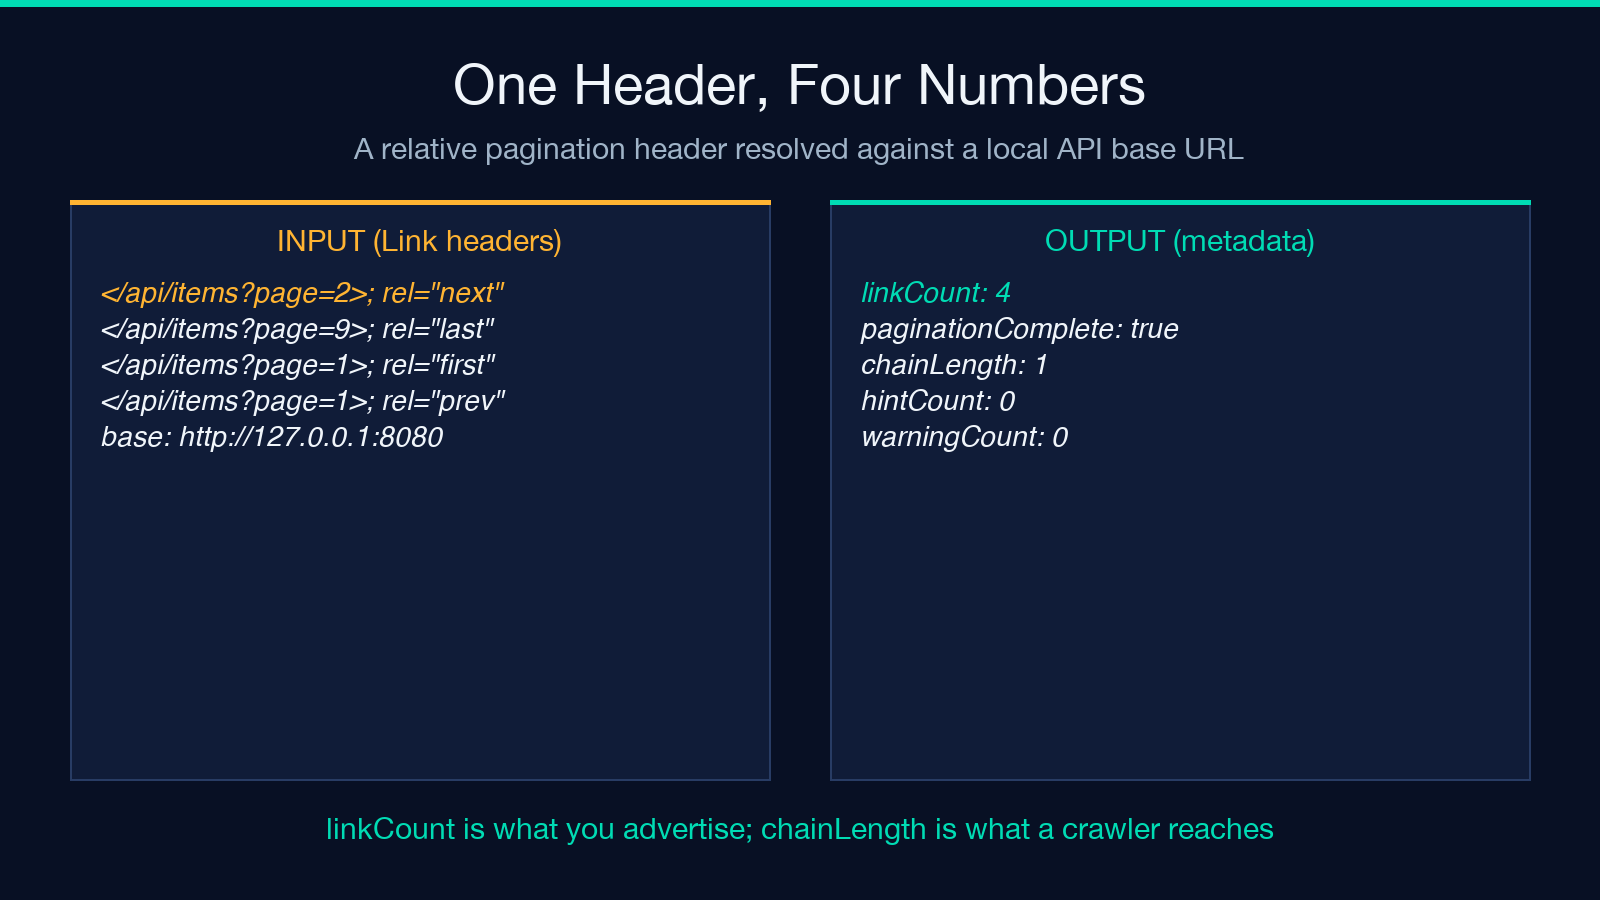
- no-next:某个响应里没有 rel=”next”,分页到此为止。通常这是正常的;在三页的例子里,第 3 页只给出一条 preload,别的什么都没有,抓取就停在那里,链长 3。
- cycle:rel=”next” 指回了已经访问过的 URL。已访问集合以基址初始化,比对时会去掉片段,所以加上 #top 也藏不住这个环;一条指回基址的 next,在第 1 页就算成环。
- end:提供的响应都走完了,链在最后一个解析出的 URL 上还会继续。这一种告诉你的是你粘贴的材料不全,不是 API 有问题。
- depth:撞到上限。默认值是 10,输入被夹在 1 到 100 之间,只有当你给的响应数量超过上限允许的页数时,这个状态才会出现。正好给十行,你得到的是 end,看起来像是走了进展。
剩下三种是输入问题,不是 API 问题:Needs-base、no-input 和 no-base。Needs-base 是最诚实的一种:rel="next" 是相对地址而你没有给基址,这根本没法模拟,工具就如实报告,不去编一个 URL 出来。
先粘头,再读链
管用的流程很短。HTTP Link Header RFC 8288 解析器与分页爬虫预览一次就能吃下整份输出,四个小时的调试于是压缩成一次粘贴。每行粘一个响应,开头的 Link: 前缀会被自动去掉,所以 curl -sI 的输出可以原样贴进去;再设好基址,然后先读链表,后读链接表。出现警告时,把重复的 next 减成一条,确认四条关系都在第 1 行,再逐条检查提示的 as 值。举个例子,这三件事一到位,报告里的警告数就降到零。更多工具见 elysiatools.com。
有一个必须说清的局限:这是行走逻辑的参考实现,没有任何主流爬虫严格照 RFC 8288 来做。Googlebot、Bingbot 和你自己的 HTTP 客户端,对重复关系和相对目标各有各的容忍度。这个测试证明的是你的头内部自不自洽,也就是你声称的下一页是不是你自己的链接解析出来的那一页;它不能证明某个具体爬虫会按你希望的方式行动。真正值得在两个 API 版本之间对比的是元数据里的那些数字,因为链长从 1 变成 5,是可以量出来的进步。
我以前只检查头能不能解析。现在我会看第一页之后这条链做了什么,因为那是读者永远看不到的部分,也是正确的头和断掉的抓取长得一模一样的地方。如果你的分页爬虫停在第一页,你的 Link 头会告诉你为什么吗?
