
和弦检测器的失败点不在你听到的那些和弦上,而在和弦与和弦的交界处。流行乐有一半句子借用的那个四和弦循环,模板匹配几乎能一格一秒地跟你的耳朵对上。分歧集中在两个和弦相接的 200 到 700 毫秒之间,有意思的和声变化就藏在这段缝隙里。
最容易的那八成,在你上手之前就做完了
叫得出名字的和弦都能打分。这就是音频和弦进行检测器(Audio Chord Progression Detector)的全部诀窍,也解释了为什么这类工具在干净的循环上像魔法,放到真实录音上就开始跟你抬杠。
词表很小。十二个根音乘九种性质,得到 108 个有名字的和弦:大三、小三、减三、增三、挂二、挂四、属七、大七、小七。每个名字都是一组带权重的音级(pitch class):根音 1.0,三音 0.92,五音 0.78,七音 0.72。把测得的音级分布跟这 108 个逐一比对,取最贴的那一个。没有搜索,没有模型,也没有训练集,只是十二个数之间的算术。
测量这一侧同样朴素。音频解码成 11,025 Hz 单声道,切成 4,096 采样点、371 毫秒一帧,步进 2,048 采样点,相邻帧重叠一半。每帧加汉宁窗(Hann window),算出 2.69 Hz 一个频点的功率谱,再在 55 到 2,500 Hz 之间找峰。观测到的峰折成十二个音级,向量归一化,离开这一帧的数据只有十二个数。一帧进,一个色度向量(chroma vector)出。
这办法能成立,是因为和声本来就粗。一个三和弦只占十二个音级里的三个,音频干净的时候,打分这一步不会含糊。好和弦表和烂和弦表的差距,从来不在命名环节。
一秒音频里,常站着三个披同一件大衣的和弦
决定和弦表能否跟耳朵吻合的机制在这里,它压根不是和弦问题。
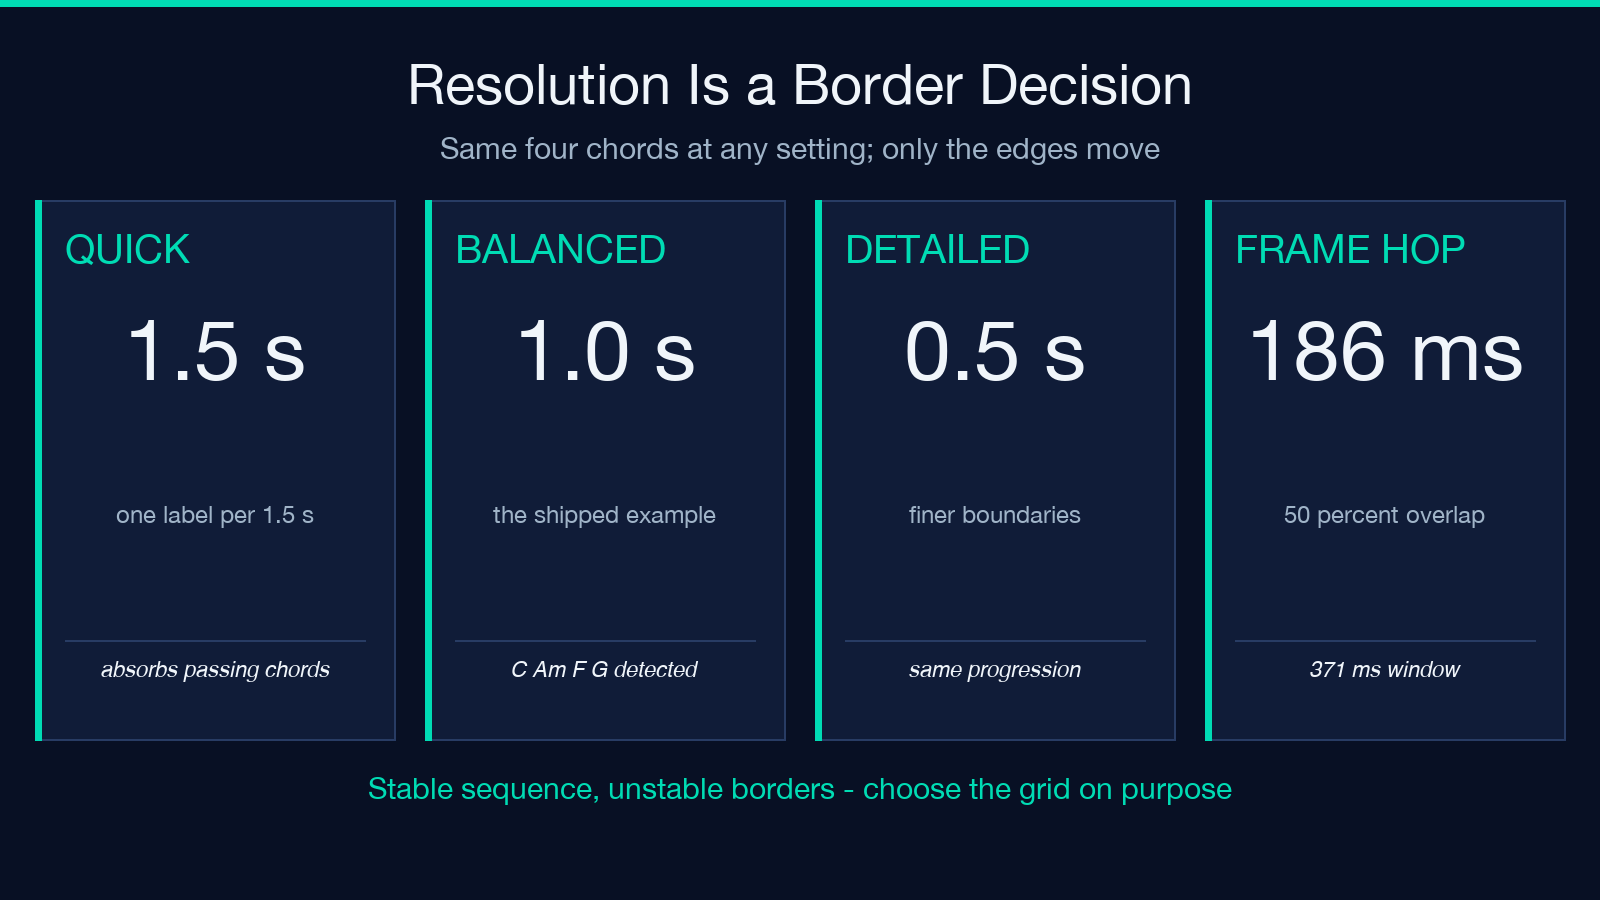
帧被汇总成 1.5 秒、1.0 秒或 0.5 秒的分段,对应工具里的快速、均衡、精细三档分辨率。一段之内的色度向量相加,归一化一次,分类一次,一段只出一个标签。跨过和弦变化的分段,报出的是汇总能量里占上风的那个和声,交界本身不做近似处理,直接切掉。
网格设成 1.5 秒,一个 0.4 秒的经过和弦不会被标错,它会被邻居吸收掉。网格换成 0.5 秒,同样一段音乐通常被切成三段,经过和弦到这一步才第一次露面。十二小节布鲁斯大约每秒换两次和声,恰好是 1.0 秒网格处理得最糟的节奏。
所以决定和弦表能显示什么的,是两个设置:分段长度和最短和弦时长。两者都跟和弦名字无关。
这么看,分辨率控件不是画质滑块。它是一个主张,关于这首歌多快换一次和声;主张错了,出来的和弦表内部自洽,听感全错。
这 108 个模板叫不出名字的东西
词表的限制值得直说:和弦检测里大部分的失望,都能追到一个从来不在名单上的名字。比如第一转位,它不是罕见的边角情况,一千首歌的第一小节里就有它。
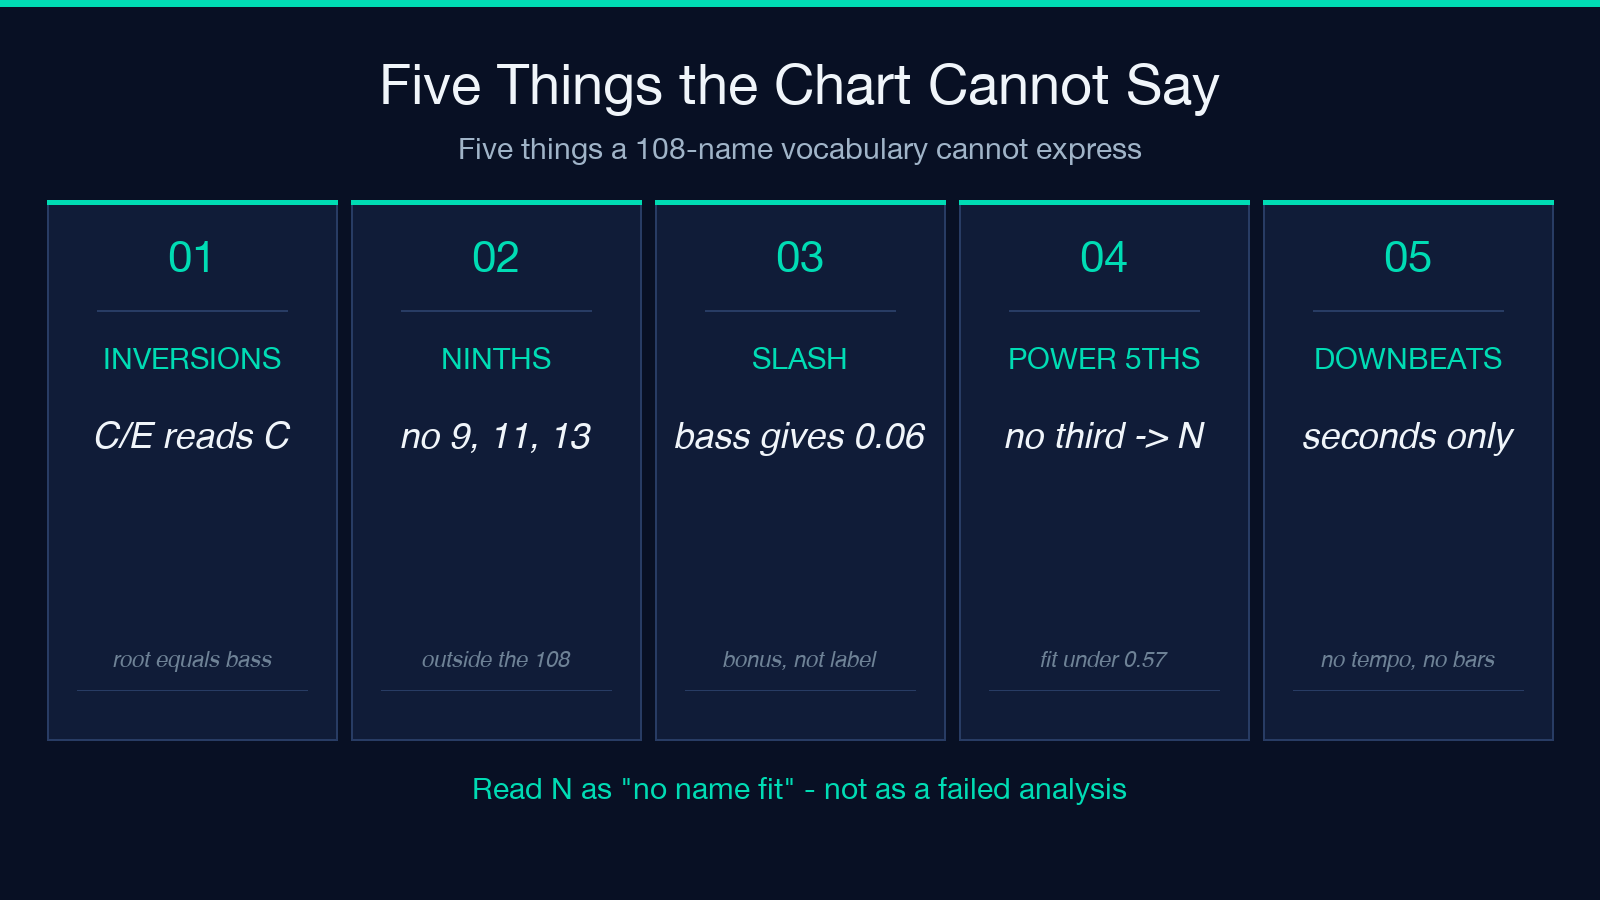
第一转位在这里不存在。C/E 报成 C,低音只给根音得分加 0.06,这是一条把判断往某个方向推的证据,不是一个标签。斜杠和弦、加音和弦、九和弦、十一和弦、十三和弦、变化属和弦、强力和弦,全在 108 个之外。失真吉他只弹根音和五音,模板找不到三音,拟合分数掉到 0.57 的下限之下,这一段就报 N:无和弦。
这道下限是这个设计里诚实的地方。什么都不够贴的时候,工具选择不猜,报空。前奏渐强、鼓的过门、过载的副歌,你都会看到 N。
置信度是分差,不是概率
置信度 0.55 不是「有 55% 的概率是对的」。看一眼公式,这个数就不再装作是概率。
置信度的算法是:最优得分与次优得分之差乘 2.2,加上最优拟合超出 0.45 的部分乘 0.72,结果截断在 0 到 1 之间。两项奖励的都是分离度。一个没有对手的干净 C 大三和弦得分很高。C 大三旁边坐着 A 小七(音级完全相同,只差一个轮转),哪怕拟合得很好,得分也低,因为分差塌了。
实际后果不那么直觉。把阈值从默认的 0.2 往上调向 0.8,多数情况下只是把含糊的帧变成 N,并不会让含糊的帧变对。你挑的是和弦表里要留多少空白,不是要多高准确率。
规格里不写的那三道平滑
逐段输出的原始标签会闪。一分钟的现场录音能抖出几十个只占一段的异常,所以在出表之前,工具有三道平滑。
第一道填孤岛:前后两段一致、当前段不同时,当前标签换成邻居的标签,置信度取两者的平均值。第二道把七和弦压成三和弦,条件是两侧都不延续七音,并且相邻段拿着朴素的三和弦,用来挡住某个走失的七音在单个窗口里拖尾。第三道合并短于「最短和弦时长」的分段,可设 0.5 到 4 秒,默认 0.7 秒。
每一道都写进了一条先验。孤岛被当成噪声,没有支撑的七和弦被当成泛音,短段被当成闪烁。这些先验消掉了大部分你本来会读成和声的抖动;同样也是它们,在你保留默认值的时候,抹掉了一个真实的、短于 0.7 秒的经过和弦。
一个实例:C、Am、F、G,两种速度
工具自带一个四和弦样例,文档里记着对它跑的两次分析。这一对结果最能说明分辨率改变了什么、没改变什么。这是基准测试,不是难题。
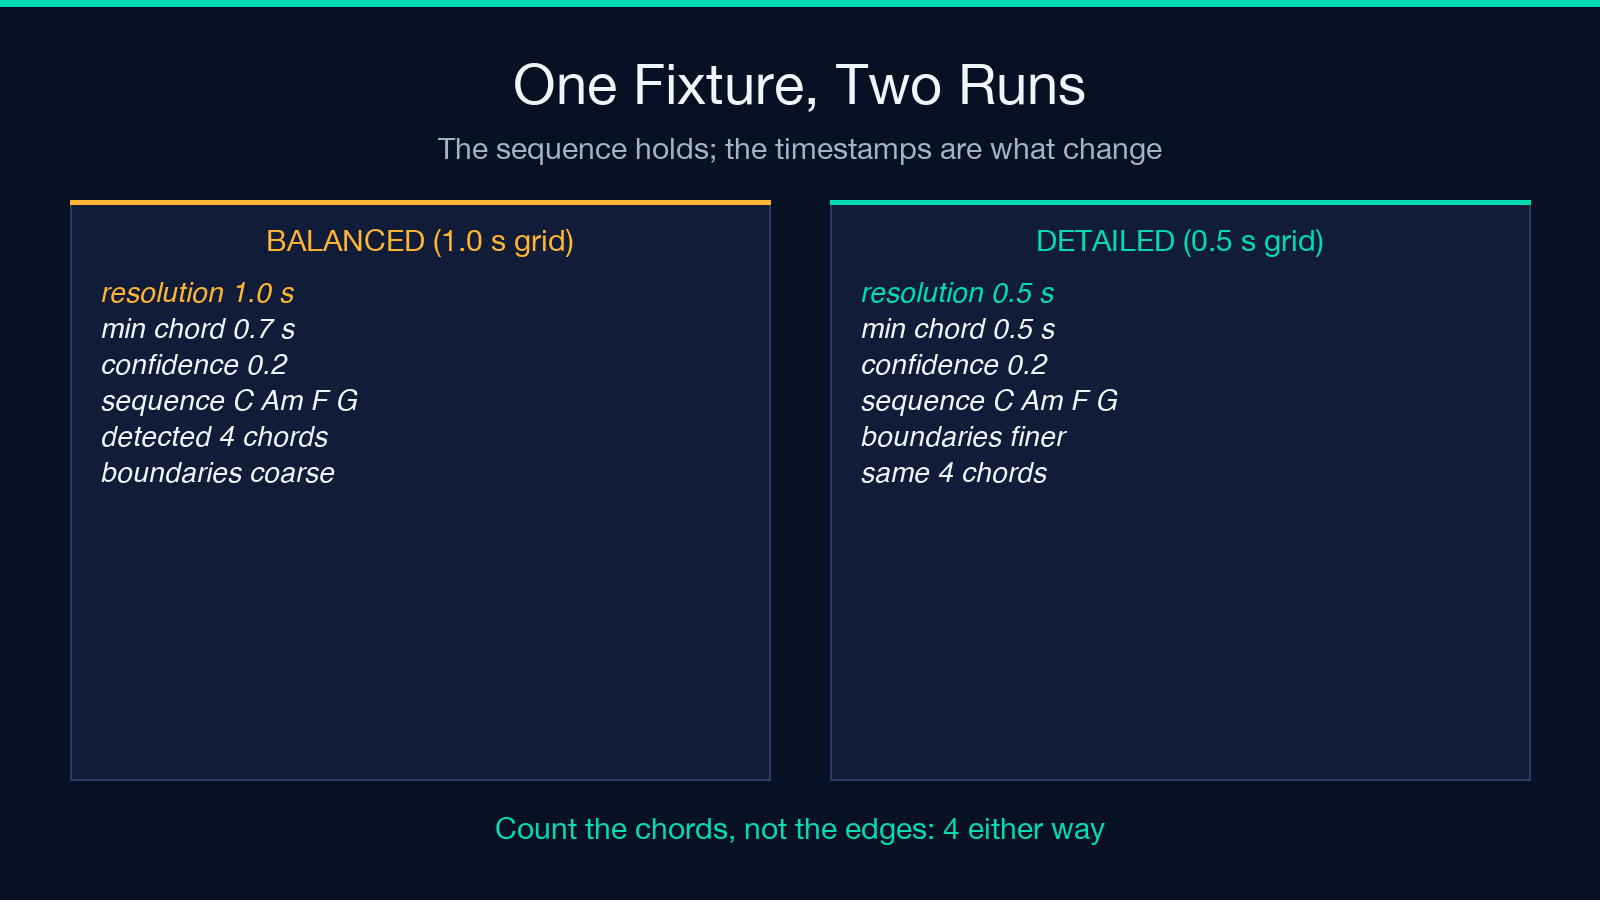
均衡档是一秒一段、最短和弦 0.7 秒、置信度 0.2,能看到的输出是 C、Am、F、G 四个和弦,打包成一个 ZIP,里面是 chords.csv、chords.json、timeline.svg 和 README.md。精细档是半秒一段、最短 0.5 秒,同一串进行原样返回,过渡边界更细,返回的 resolution 字段是 0.5 秒。
把两个结果并排看。序列是稳的,边界不是。和弦名是输出里能立住的部分,时间戳是可以吵的部分,任何靠小节位置工作的下游系统都会继承这份含糊。两次运行之间边界时间的位移,一次对比就把分辨率的全部争议讲完了。
想在跑自己的文件之前先听听差别,FLAC 样例页和MP3 样例页上有可比的素材。
这套方法在哪里断
我把这些失效模式逐条对着实现跑了一遍,其中三条是结构性的,调参调不好。
第一条是失真下的和声混淆。重度过载加出来的谐波落在别的音级上,音级分布不再像三和弦,拟合分数于是跌破下限,把真和弦挡在门外。第二条是延音。踏板踩住的钢琴会把上一个和弦的音带进下一段,第二段汇总的色度里含着第一段,填孤岛那一道随后就把错的标签保护起来。第三条是输出里没有音乐结构:没有速度,没有强拍,没有小节数,也没有调。SVG 时间线按秒画,因为分析只知道秒。
三种情况里,测出来的分布都是对音频的公道描述,对音乐却是糟糕的描述。这个落差写在文档里,不是意外。音乐信息检索(MIR)研究一直把基于色度的和弦估计当基线,原因就在这里:它展示的是纯音级能量在加任何模型之前能做到什么。
输入的上限也有关系。文件最大 100 MB、180 秒,混成单声道,分析频带在 11,025 Hz 采样下止于 2,500 Hz。这是为音级能量做的有意取舍:对弦乐四重奏零成本,对镲片多的混音代价很大。工具文档自己说得很直白:「一份用于听感和标注的近似 MIR 指南,不是谱面级的真值」。这句话该跟着你导出的每一张和弦表走。
拿到一张不敢信的和弦表,怎么办
第一张表当成假设,不要当成交付物。能扛住真实音频的工作流程很短。
用精细档跑一遍,最短和弦时长设 0.5 秒,置信度 0.2,让分析愿意画出的边界数量达到最多。然后看那些不足一秒的分段,问那里的和声在干什么。网格和歌分歧的地方就在这些段里,也是第二遍唯一帮得上忙的地方。再用更高的置信度重跑,看哪些和弦是承重的:能扛住 0.4 阈值的,才是你可以放心写进表里的。C/E 按设计当 C 接受,N 读作「音频不支持一个名字」,不要读成错误。
然后拿节拍器核对结果,别拿你对这首歌的记忆。在你亲自挑的网格上,一张跟录音吻合到一个网格步长以内的表,是你能站住的结果。两个不同分辨率各跑一次,一次对比就能同时看到稳的序列和不稳的边界。整套流程可以在浏览器里跑:音频和弦进行检测器;其余音频环节由媒体工具覆盖,完整目录在elysiatools.com。
有一阵子我把和弦检测当成命名问题:词表放宽、模板调好,表自然就出来了。它不是命名问题。对 C、Am、F、G,几乎所有检测器都同意;对这几个和弦相接的那半秒,几乎没有一个同意。
所以下一次和弦表跟耳朵分道扬镳,别急着放宽词表,先挪边界。问问在那被网格藏起来的 500 毫秒里,和声在做什么,然后老实回答:那个经过和弦是歌里的,还是你工具的帧率造出来的?这是音乐问题,任何采样率都替你答不了。

Pingback: Your Chord Chart Disagrees With Your Ears. The Grid Is the Reason. - COSESAI