
别再拿 PCIe 链路训练当黑盒。六个状态、八种有序集、一台固执的 LTSSM 状态机,决定一条 Gen5 链路是以 32 GT/s 起来,还是永远停在 Polling.Active。
训练失败的 PCIe 链路是硬件工程里最贵的 bug 之一。链路训练状态机(LTSSM)依次走过 Detect、Polling、Configuration 和 Recovery,每一步都有时间预算,调试器能记录,却不一定解释得了。再叠上链路反序(lane reversal)、极性反转、均衡预设(Gen4 P1-P3 / Gen5 P0-P4)和新的 lane margining 寄存器,一个「链路起不来」的问题能耗掉一周。
PCIe 链路训练 LTSSM 与 Lane Margining 眼图解码器读入自由格式的 LTSSM 日志,或 pcilmr 格式的 margining 报告,在头十秒里给出每个链路训练调试者想要的四件事:实际协商到什么速率、什么宽度、卡在哪一步、哪些 lane 有问题。
LTSSM 实际在做什么
链路训练与状态机(Link Training and Status State Machine)是一张有向图,共 11 个主状态(Detect.Quiet、Detect.Active、Polling.Active、Polling.Compliance、Polling.Configuration、Configuration.Linkwidth.Start、Configuration.Lanenum.Accept、Configuration.Lanenum.Wait、Configuration.Complete、Configuration.Idle、L0、L0s、L1、L2、Recovery、Hot Reset、Loopback、Disable)。一条健康的 Gen5 x4 链路走最短路径 Detect → Polling.Active → Configuration.Lanenum.Accept → Configuration.Complete → L0,大约 100 ms。坏掉的链路会卡在中间某个状态,而且往往有文档化的重试逻辑把根因盖住。
解码器要做的是给每次状态迁移打时间戳,从 TS1/TS2 有序集里的 rate identifier 位推导出协商链路速率(Gen1 2.5 GT/s 到 Gen6 64 GT/s)和协商链路宽度(x1、x2、x4、x8、x16),并标出停滞状态:链路在某个状态里花了不成比例的时间,bug 几乎总藏在那里。
读懂 TS1、TS2 和 FTS 有序集
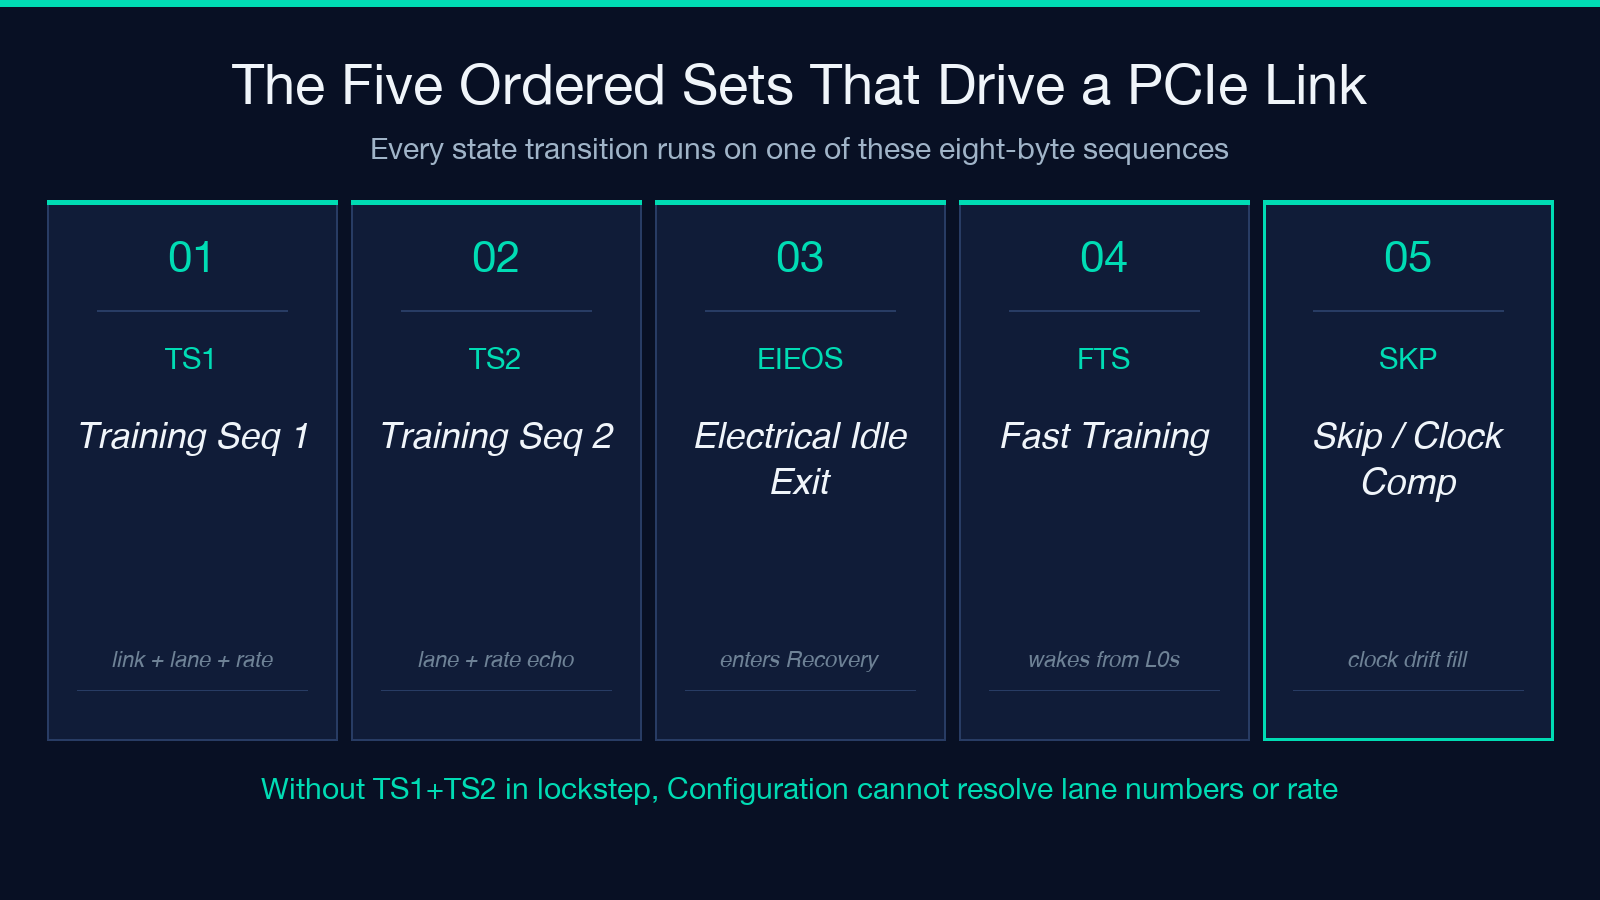
有序集是训练期间用来同步链路的 8 字节序列。TS1(Training Sequence 1)携带链路号、lane 号和 rate identifier;TS2 携带用于配置的 lane 号;EIEOS(Electrical Idle Exit Ordered Set)标记进入 Recovery;FTS(Fast Training Sequence)把链路从 L0s 唤醒。
要让分析仪给出可信的时间线,日志里的时间戳要么是显式的(t=0.90ms Polling.Active TS1 link=PAD lane=PAD rate=0x01),要么能从计数器推出来。解码器两种都收,显式时间戳总是更好辩护。
解析之后,解码器像取指纹一样给链路做画像:
– Detect → Polling 迁移:把这段延迟读成 1 ms 到 12 ms 的窗口。正好 1 ms 且没有漂移的 Polling 说明对端链路伙伴很快;12 ms 且中间没有 TS1,通常是在等下游设备上电。
– Polling.Active → Configuration.Linkwidth.Start:这里填充位(link=PAD lane=PAD)被换成分配的编号(link=0 lane=3)。链路若停在 Polling.Active 且仍是 link=PAD,说明你的上游器件没有在发 TS1。
– Configuration.Complete → L0:这一步干净地迁过去,说明电气信令稳定。如果你看到 Configuration.Complete 却始终到不了 L0,接收端处在电气空闲,发送端没能把它拉出来。
Gen4、Gen5 和 Gen6 的均衡
PCIe 4.0 之前的链路训练很直接。Gen4 在 TS2 里加了预设提示(preset hinting),从 P0(无去加重)到 P9(全预设),让上下游在链路进入 Recovery 之前先就发送端设置达成一致。Gen5 加了全均衡(Full Equalization),16 个预设(P0-P15),再加上 32 GT/s 的 PAM4 信令;Gen6 把这一切进一步收紧到 64 GT/s。
链路训练真正开始出问题的地方在这里:
– 预设不匹配:上游用 P3,下游建议 P5,谁也不接受对方的系数,链路就在 Recovery 和 Configuration.Linkwidth.Start 之间无限循环。解码器把它标成连续进入 Recovery、中间没有 L0。
– TS1 与 TS2 速率符号不一致:如果 TS1 宣告 32 GT/s,TS2 却没有回显同一速率,链路正在强制重新协商 N_FTS。解码器在对应时间戳旁给出速率符号差(rate symbol delta)标注。
– 均衡完成超时:Gen5 明确要求 16 个预设在 EQ TS2 发出后的 24 ms 窗口内全部完成评估。到达 EQ TS2 却在 30 ms 内没有迁到 L0 的链路,均衡失败。
这三种情况解码器都能抓到:统计各 EQ 阶段的耗时,比对 TS2 里上下游的预设序列,把速率符号差标出来。你不用去几兆字节的日志里 grep,时间线直接告诉你瓶颈在哪一步。
Lane Margining 与眼图
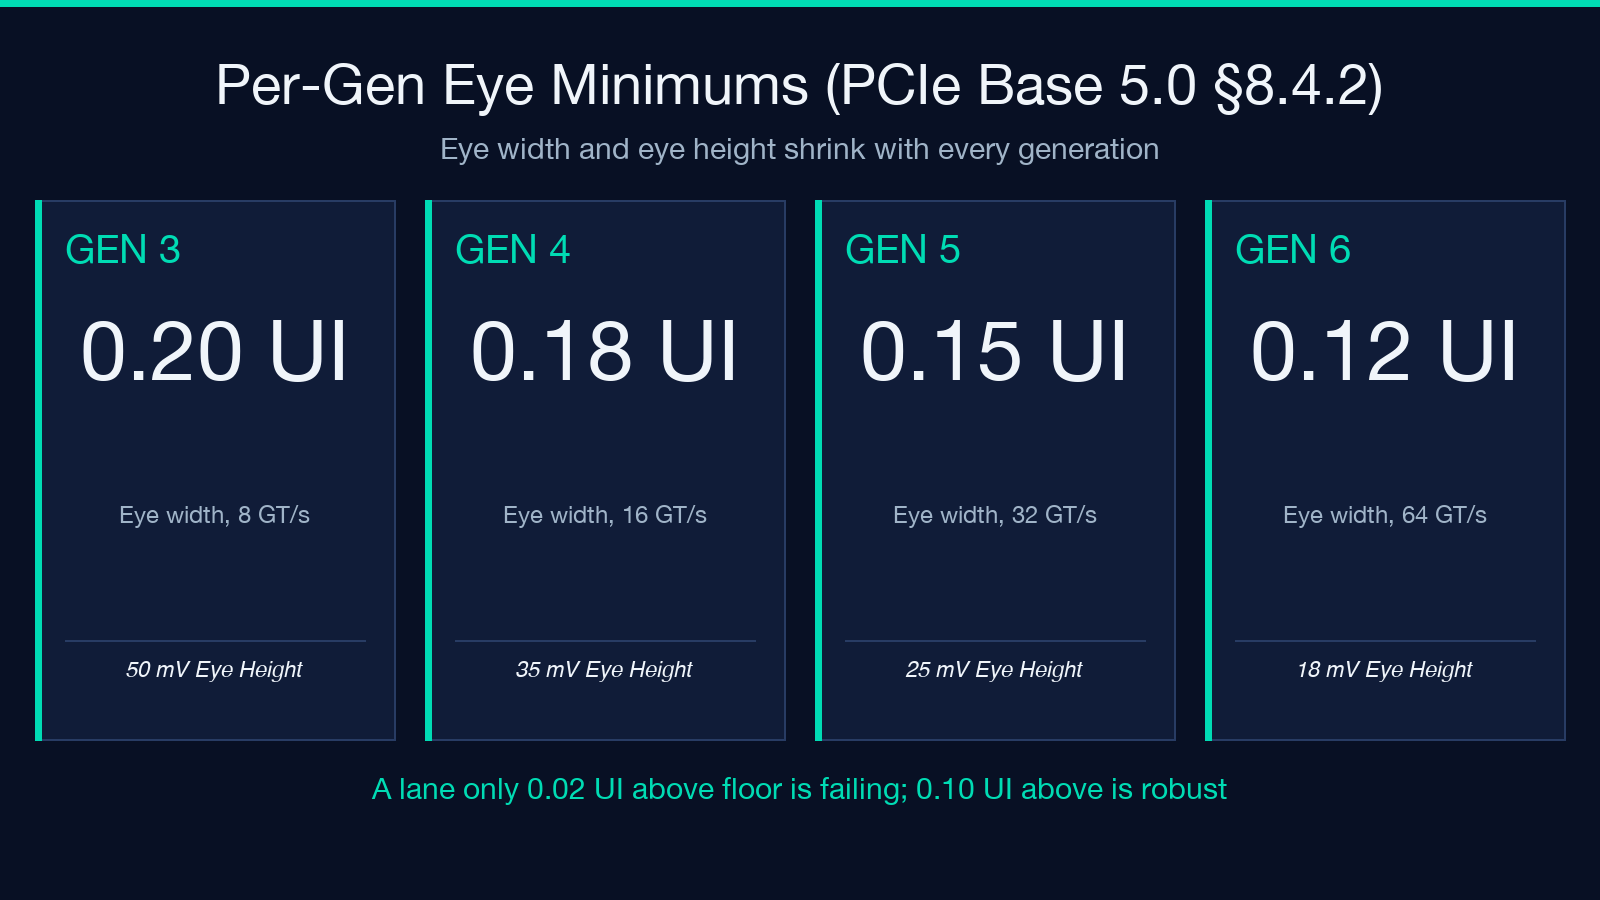
链路训练把链路拉起来,lane margining 告诉你这条链路有多稳健。PCIe Base Spec Rev 5.0 §8.4.2 规定了每一代的眼宽和眼高下限:
- Gen3 (8 GT/s):眼宽下限 0.20 UI,眼高下限 50 mV
- Gen4 (16 GT/s):眼宽下限 0.18 UI,眼高下限 35 mV
- Gen5 (32 GT/s):眼宽下限 0.15 UI,眼高下限 25 mV
- Gen6 (64 GT/s):眼宽下限 0.12 UI,眼高下限 18 mV
真实链路很少每条 lane 都达到规格下限。可预期的形态是最差的 lane 贴着下限,最好的 lane 余量充裕,中间平滑过渡。
把 pcilmr 的 CSV(Lane, EW Min, EW Rec, EW Max, EH Min, EH Rec, EH Max,...)或 key=value 形式的 margining dump 载入解码器,它会同时做四件事:
1. 归一化:按对应代次的下限换算数值(从数据自动识别,或在下拉框里锁定 Gen4/5/6)。
2. 渲染逐 lane 的眼图余量热力图,内联 SVG,每条 lane 最差眼宽那一格按规格下限比成绿/黄/红。
3. 标出眼宽或眼高未达规格下限的 lane,直接给出余量数字,不用你自己对着表格算。
4. 给出失效模式:区分眼宽不足(信道信号完整性问题)和眼高不足(发送端去加重问题)。
做更深的信号完整性分析时,热力图的逐 lane 配色加上失效模式标注,能一起回答那个本来要动采集站和 SPICE 仿真才能回答的问题:这是板子的问题、发送端的问题,还是接收端的问题?
LTSSM 各阶段的常见失效模式
真实 PCIe 链路起不来,最常见的原因有这些:
– Detect.Active 超时(timeout-detection):接收端始终没看到合法的 8b/10b 符号。几乎总是发送摆幅不够、参考时钟没接上,或下游端口的上电时序问题。
– Polling.Active 但没有 TS1:上游器件没在发送有序集。查平台的链路训练使能位是否置起、插槽是否供电、参考时钟是否被门控。
– Configuration.Complete → Recovery 循环:链路到了最慢的稳定状态又弹回来。多数是 Gen4 链路的预设不匹配,或者 Gen5 的均衡完成超时。
– 从 L0 发生 Hot Reset:下游器件发起了热复位(通常是它检测到致命错误)。解码器把它标成 100 µs 内的 Hot Reset 迁移加 Recovery 进入;底层信息在 AER(Advanced Error Reporting)寄存器里,不在 LTSSM 日志本身。
每种情况解码器都把数秒长的时间线压成一段序列摘要,把你指向可疑的那个状态。花在 grep 日志上的时间少了,花在真实信号路径上的时间多了。
什么时候该用这个工具
链路训练这类活,瓶颈很少在协议,而在记录下来的数据量。一条真实的 Gen5 链路几秒内就能产生数万次状态迁移,状态机里的环又让人很容易错过关键的几次。
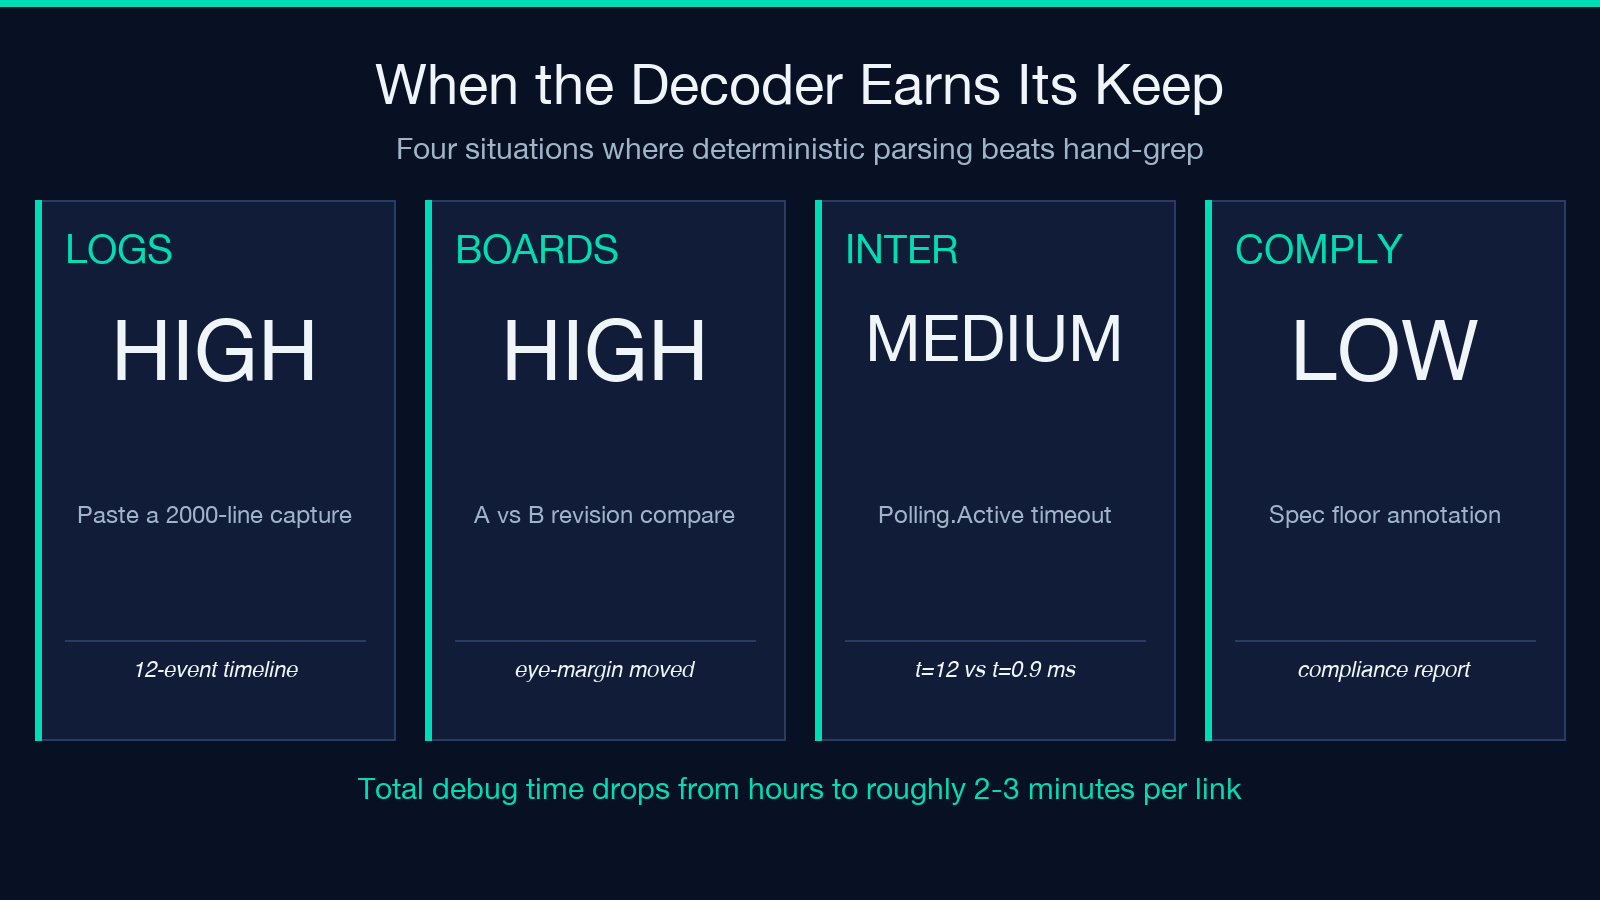
解码器在下面这些场景里值回票价:
– 手上有日志,却没有自动化工具可读。把 30 秒的采集粘进去,2000 行的日志变成 12 个事件的时间线,失效模式已标注。– 你在对比板卡设计不同版本的日志。分代阈值表让你在调试时锁定规格下限,重新生成,看眼图余量有没有变化。– 你在调间歇性训练失败。t=0.90ms Polling.Active 突然变成 t=12.00ms Polling.Active 就是确凿证据,时间线不用写脚本就能让它显形。– 你在做合规测试。热力图和逐 lane 的规格余量数字可以直接写进合规报告。
对硬件工程师来说,价值不只是快,还有一致性。手工解析的时间线会漏掉规律,确定性解析每次都能抓到速率符号差。
一条实用的调试流程
1. 抓 LTSSM 日志:从主机平台的硬件调试口或 PCIe 分析仪取,尽量带毫秒或更细粒度的显式时间戳。
2. 把日志粘进PCIe 链路训练 LTSSM 与 Lane Margining 眼图解码器。自由格式的 LTSSM trace 和 pcilmr 格式的 margining 报告它都处理。
3. 按顺序读时间线:Detect → Polling → Configuration → L0。链路停滞的那次迁移会被标注,失效模式在对应时间戳上解码出来。
4. 处理均衡失败:传入 margining 报告,打开「Render eye-margin heatmap (SVG)」,渲染逐 lane 的眼图余量热力图。SVG 叠在时间线上,眼宽、眼高和状态机事实并排出现。
5. 做合规报告:把代次显式锁到 Gen4/5/6(别留在 auto-detect),截图时让规格下限标注可见。
整套流程每条链路 2-3 分钟。和 grep 几兆字节的日志相比,这是周五下午解决和周一早上解决的区别。
与更大的网络工具栈配合
LTSSM 解析只覆盖 PCIe。要看更大范围的调试图景:
– 抓包:和 PCAP / PCAPNG 文件分析工具配合,看更高层的协议交换(PCAP 样例可用于 PCIe-over-MCTP 流量的快速自查)。
– 相邻的网络调试:链路起来了但承载路径有问题时,MTU / MSS 路径计算器按每一跳算最大报文段,CIDR计算器处理切分 PCIe 虚拟功能时绕不开的子网算术。
– 更多网络工具在 elysiatools 网络工具索引。
解码器替代不了硬件采集站,但它把到假设的时间压得很短。对一线工程师来说,这才是关键指标。

Pingback: PCIe Link Training, Decoded: What LTSSM, Equalization, and Lane Margining Actually Negotiate - COSESAI