
单看十行 Jira 数据,看不出任何流动状况。看板周期时间与吞吐量教练(Kanban Cycle Time & Throughput Coach)会把 Created、Started、Resolved 三个时间戳换算成敏捷教练周一早上真正会拿来争论的五个数字:前置时间与周期时间的分位数(50 / 85 / 95)、在制品年龄、按天/周/月的吞吐量计数、带 WIP 与近似周期时间读法的累积流图,以及一项 Little 定律一致性校验,用来看输入本身是否自洽,还是有人把日期打错了。在 Elysia Tools 上打开看板周期时间与吞吐量教练即可运行。
教练在每次粘贴后给出的五项指标
教练假定最简的 Jira 式表结构:一行一张工单,一列 Created(日期或 ISO 时间戳),一列 Started(日期,未开始就留空),一列 Resolved(日期,仍在处理就留空)。一份干净的粘贴会算出:
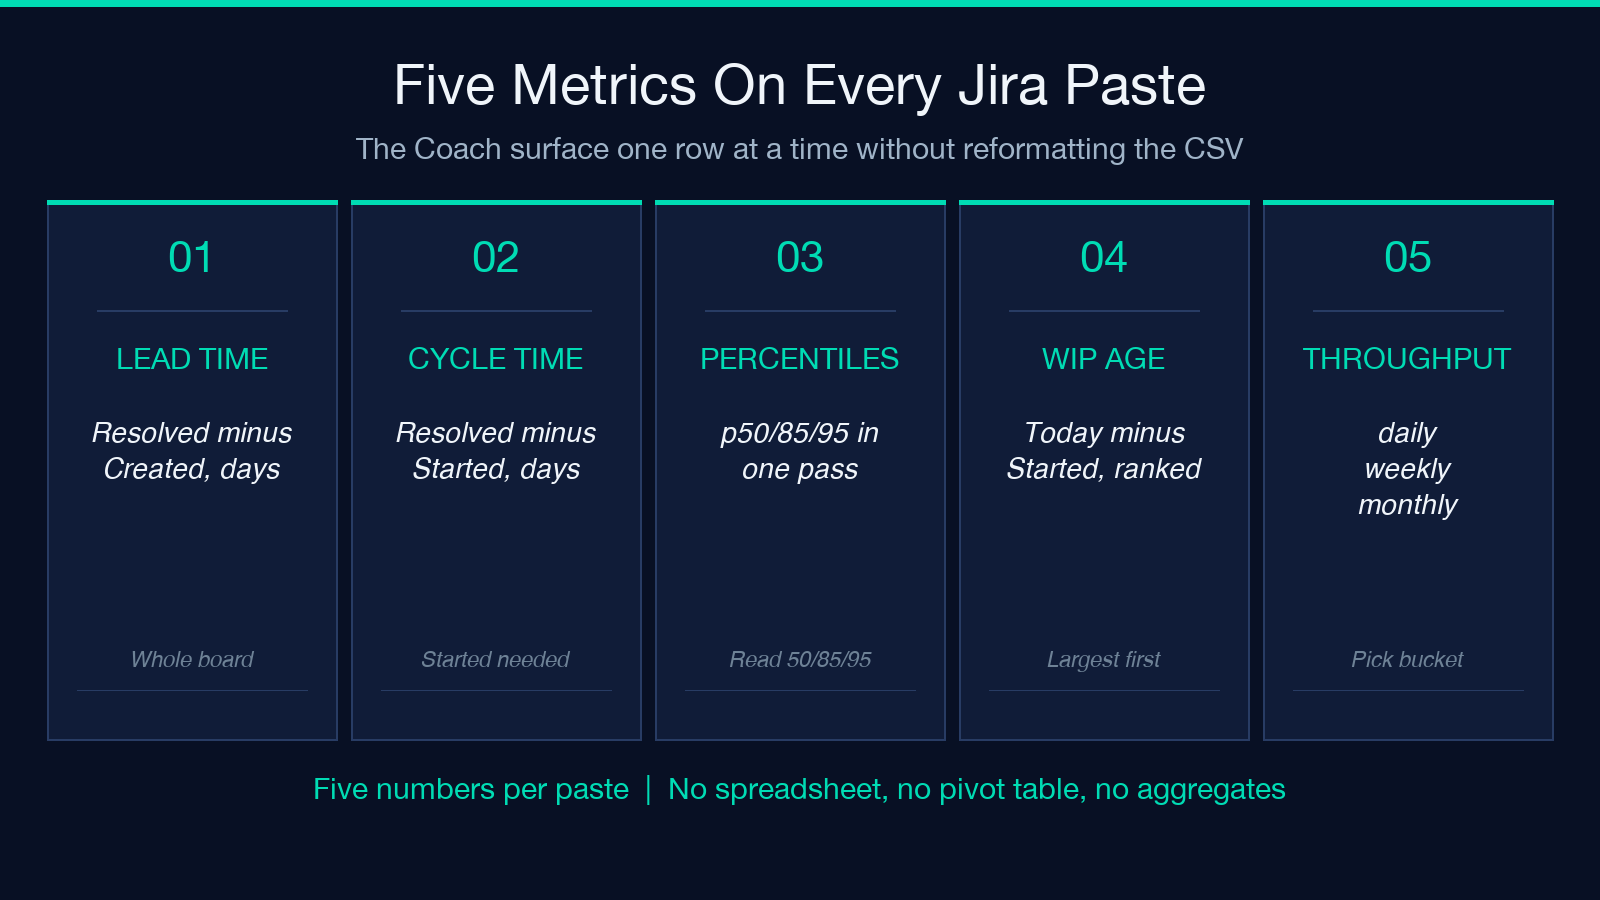
- 前置时间 =
Resolved - Created,以天计,覆盖每张已完成工单。 - 周期时间 =
Resolved - Started,以天计,只覆盖Started非空的工单。 - 前置与周期时间的 50 / 85 / 95 分位数,两者分别计算。
- WIP 年龄 =
today - Started,覆盖每张Resolved为空的工单,从大到小排序。 - 吞吐量,按天、按周或按月分桶计数(可选)。
- 一张累积流图(CFD) SVG,标注 WIP 与近似周期时间的读法。
- 一项 Little 定律一致性校验:
WIP approx Throughput x Cycle Time。
你可以在Elysia Tools 数据分析目录里试用运行中的工具,流动性、工作量、吞吐量这类仪器在那里并排放着。
为什么 85 分位数是唯一能和干系人对话的数字
平均周期时间是个陷阱。一个两周的离群值能把 3 天的均值推到 4.5 天,然后在 Slack 上引发一串「团队在变慢」的讨论。教练报三个分位数,因为每个回答的是不同的问题:
- p50(中位数)回答的是:一切顺利时一张工单要多久。
- p85回答的是:85% 的工单在多少天以内完成。资深工程师和 PM 谈迭代承诺时,对着的就是这个数。
- p95是尾部。如果 p95 超过 p50 的 3 倍,说明有一类离群工单在拖住看板,通常是依赖等待、代码评审阻塞,或者没人负责的发布队列。
教练把分析时钟钉在你提供的日期(asOf)上,所以今天的在制品按你选的快照计算年龄,不按墙上时钟算。这让复盘里的数字下个季度还能复现。
一个实算例子:十行 Jira 数据,横跨三个周桶
从工具目录里粘贴那份 2026 年 7 月的小样本 CSV,Started 和 Resolved 两列都有值,另有两张工单仍在处理中(PROJ-109 和 PROJ-110,Resolved 为空)。教练返回:
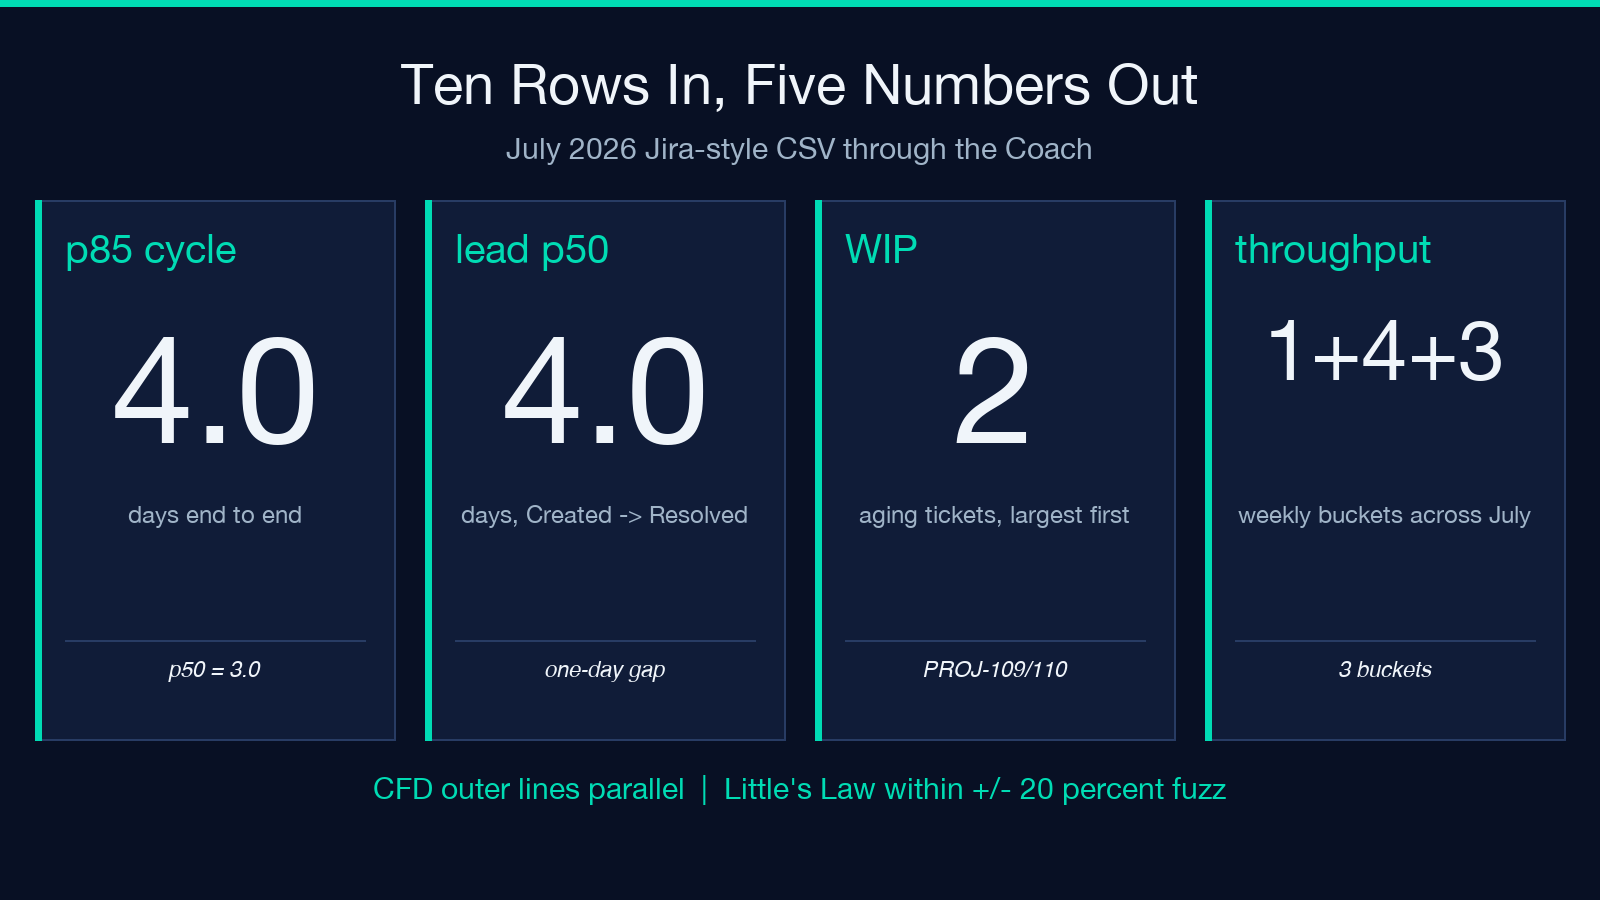
- 周期时间分位数:p50 3.0 天 / p85 4.0 天 / p95 4.0 天。
- 前置时间:p50 4.0 天,多数行上
Created与Started相差一天。 - WIP 面板:2 个在龄条目,从大到小排序。
- 每周吞吐量:三个桶分别是 1 / 4 / 3(迭代初启动、迭代中爆发、第 3 周衰减)。
- CFD:外侧两条曲线几乎保持平行,没有散开,这是健康流动的特征。
- Little 定律:
WIP = 2对Throughput(4 / wk) x Cycle(3 d) approx 1.7,落在 ±20% 的容差内。
你可以在教练里跑这份样本,再粘贴自己的看板做分位数比例对比。五行或五百行的粘贴它都照收。
CFD 的两条读法:WIP 带与近似周期时间
累积流图是看板上唯一不需要轴标签就能读的图。两段垂直距离编码两个不同的数字:
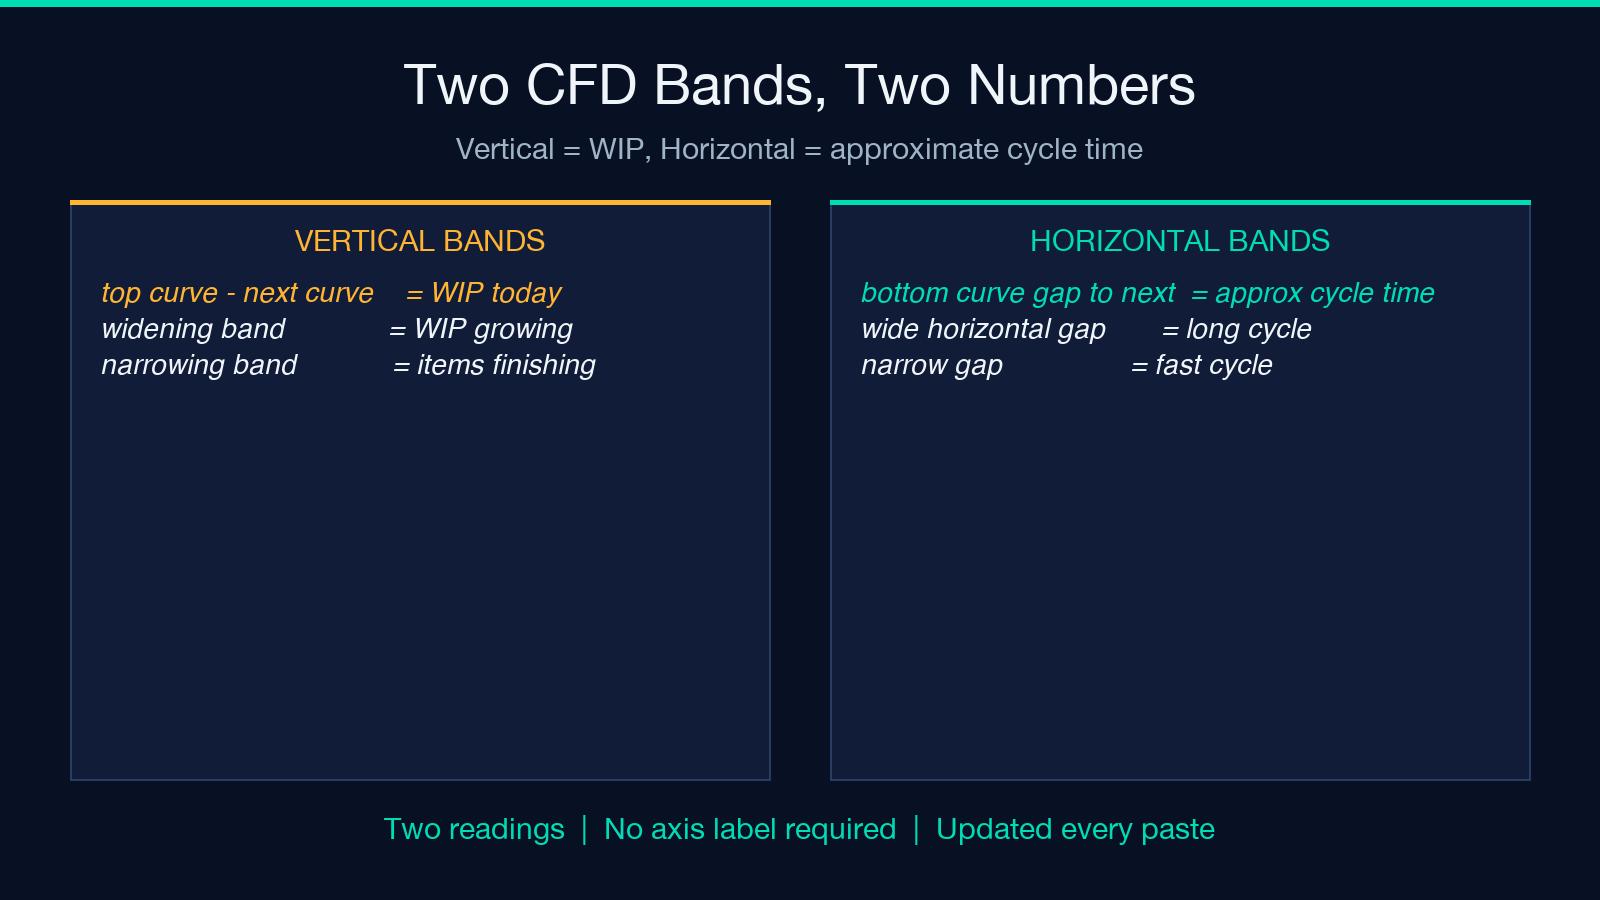
- 最上面两条曲线之间的垂直距离 = 今天的 WIP。把这条带子按时间看:带子变宽,说明停在
In Progress和Code Review的活儿比团队完成的活儿多;带子变窄,说明完成速度快于新开工的速度。 - 最下面两条曲线之间的水平距离 = 近似周期时间,以天计。这是这张图上「事情要花多久」的读法。它从累计计数推导而来,不依赖逐张工单的计算,所以缺一个
Started日期也扛得住。
正因为有这两条读法,CFD 才经得起「那平均值呢」这种追问:这些带子直接回答了流动效率的讨论,不需要任何聚合。教练会把带子画出来并标注。CFD 平的看板配上不断变宽的 WIP 带,是警告,不是稳定状态。
Little 定律:抓坏输入的一致性校验
教练对每次粘贴都套用 WIP approx Throughput x Cycle Time,然后算出合度百分比。结果落在 ±20% 以内标为「一致」;超出这个区间则连同越界的那个数字一起标出来,方便你找出哪个输入错了。
一致性校验能抓到的三种真实故障:
Created列是字符串,不是日期。每行的周期时间都算成零,Little 定律严重对不上。- 一半
Resolved日期缺失,因为导出在中途截断了。吞吐量掉下去,WIP 没掉,乘积远低于 WIP。 - 每一行的
Started都为空(团队跳过了工作流里的这一步)。周期时间未定义,教练退回前置时间分位数,并说明做了这个替换。
想看另一个领域在低 C* 下类似的 5 带散开形态,换热器 ε-NTU 计算器(效能-NTU 法)是同一套结构:四条构型曲线随着无量纲参数趋近于零而散开。
计算器从结构上就避开的坑
无论哪个团队,复盘里总会冒出三种反模式:
- 拿移动平均值做承诺。教练的 p85 是分位数,离群值污染不了下个迭代的承诺。
- 忘记在制品。每个空的
Resolved都变成一行 WIP 在龄记录,从大到小排序,下次站会就会被提出来,而不是让它悄悄变老。 - 把平掉的 CFD 当成健康。教练会画出 WIP 带和周期时间带;CFD 平、WIP 带变宽,是警告,不是稳定状态。
读懂教练的结论面板,能让团队明白每个指标到底在说什么,而不是被训练成去追上周动过的那个数字。
教练刻意不计算的内容
下面是一份它按设计拒绝的常见请求,以及你该改去找什么:
- 蒙特卡洛迭代预测。教练只根据粘贴的数据报分位数,不拿吞吐量历史做前向模拟。需要的话去找离散事件仿真器。
- 按经办人拆分。周期时间分位数是整份粘贴一起算的。要按工程师拆开看,先自己切分 CSV 再粘。
- 故事点归一化。教练不知道你的点数标尺;前置时间和周期时间都以日历天给出。
这是故意的。教练的职责是当看板上最快的「粘进去、读结果」,这意味着它不碰那些每个团队各有约定的层次。
把指标合起来用于迭代规划
一行实用总结就够了:把 p85 当作一个迭代承诺的上界,把任何 p95 > 3x p50 当作尾部级别的触发信号,有人问「我们平常的周期时间是多少」时,就用 CFD 的周期时间带来回答。
教练是为真实场景造的:粘贴上个迭代工单的 CSV 就行,输出可以直接贴进复盘幻灯片,不用再排版。它就在Elysia Tools 数据分析目录里,与同一套工作流主题的计算器放在一起;Elysia Tools 上这类流动、度量、工作量仪器还有很多。
