
合法的 URL 别名不能靠猜。它是每个 CMS、每个 CDN 边缘节点、每个统计标签都会默默容忍的最低公约格式,规则短到一顿午饭之前就能背下来。
URL 别名是当代 Web 里最能扛活的标识符:它把博客标题变成永久链接,把文件名变成干净的分享地址,把临时编号变成能扛住内容系统迁移的稳定字符串。规则看着不值一提,无非小写字母、数字和连字符。可一旦放进真实工作流,这套看似简单的规则就变成半天的决策:下划线能不能留?首尾的连字符呢?“样式上难看”和“在 CMS 层直接坏掉”之间的界线划在哪?URL别名校验器 把这半天压缩成一行判断:规则集被显式编码,三个开关覆盖三种合理例外。
URL 别名到底是什么
别名是 URL 末尾指向单个资源的那段标识。目录被重写、语言被切换、CDN 缓存被刷新,它都得活下来。举例:
https://example.com/blog/my-blog-posthttps://docs.example.com/api/v2/rate-limitshttps://shop.example.com/products/red-widget-32oz
上面三例中,my-blog-post、rate-limits、red-widget-32oz 就是别名。前面的路径段(/blog、/api/v2、/products)是路由;别名对应的是数据库里的一行、缓存里的一个键,或搜索索引里的一条记录。
别名处在 URL 里最脆弱的位置。路由段会被框架重写,查询串会被统计工具丢掉,片段根本到不了服务端。别名不同:每一跳都得活下来,被每一个下游系统解析,还要能不加转义地塞进 HTML 属性、JSON、日志文件和统计看板。
所有 CMS 都认的那套规则
随手翻三个博客平台的别名实现,找到的是同样五条规则。别名必须:
1. 只用小写字母(a-z) 2. 数字(0-9)可出现在任意位置 3. 只用连字符(-)作分隔符 4. 首尾不得有连字符 5. 长度合理(多数 CMS 卡在 100–255 字符)
有些系统放宽了第 4 条(WordPress 历史上允许尾部连字符),有些放宽了第 1 条(服务端不区分大小写),还有些接受 ASCII 数字却把 Unicode 数字当成另一类。校验器实现的是严格形式,另外用三个开关覆盖放宽的变体。
实践中到底哪里会坏
最常见的别名失败情形一点都不稀奇,每周的真实数据里都会冒出来:
- 大写字母:
My-Blog-Post在 Linux 服务器上解析正常,到了区分大小写的 Windows 共享和关掉CheckCaseOnly的 Apache 配置上就断 - 下划线:
my_blog_post放在 URL 里能用,可一旦别名被嵌成 CSS 类名、JavaScript 变量,或 Windows 挂载点上的文件路径,就出问题 - 特殊字符:
naïve和café在现代 Unicode 系统里没问题,在只认 ASCII 的旧 CDN 和统计标签清洗器那里会失败 - 首部连字符:
-my-blog-post在 CLI 解析里有歧义,当参数前缀用时直接坏掉 - 尾部连字符:
my-blog-post-看着像手误,还会弄坏某些搜索索引的归一化逻辑 - 连续连字符:
my--blog--post大多数解析器都能过,但几乎总是生成环节的 bug - 空格:会被自动编码成
%20或+,在字符上限里被悄悄多算一遍 - 标点:
don't按编码器不同会变成don-t或don%27t
这些每一条,写入时 30 秒能改,读取时要查 30 分钟。校验器把规则检查挪到写入时,赶在别名进入任何流水线之前。
校验器怎么处理每种失败情形
对上面八种常见失败情形,校验器给出三种回应之一:
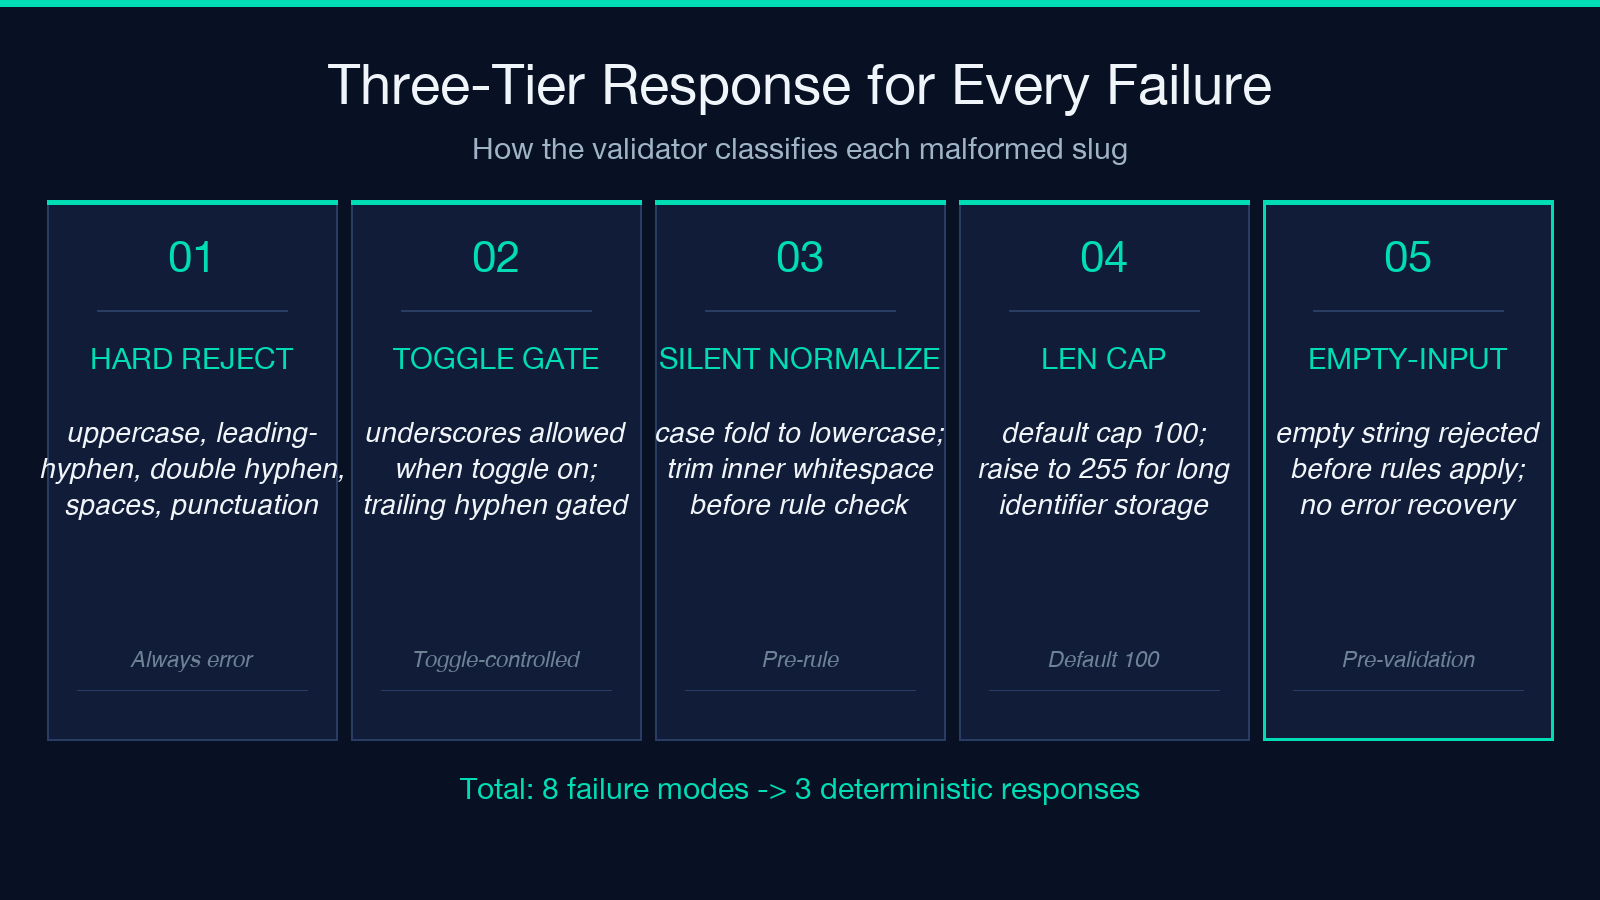
- 硬拒绝:大写字母、首部连字符、连续连字符、空格和特殊字符一律返回明确错误,并指出越界字符的位置
- 开关放行:下划线和尾部连字符只有在对应开关打开时才接受
- 静默归一化:规则检查之前先做大小写折叠和内部空白裁剪,所以
My-Blog-Post会先归一成my-blog-post再校验
这套三层回应模型让写入时的规则检查保持确定,又不必强迫所有 CMS 对“合法”达成同一种理解。
三个开关对应怎样的真实工作流
校验器在严格规则集之外提供三项可选放宽,每一项都对应一条真实的工作流约束,而非风格偏好:
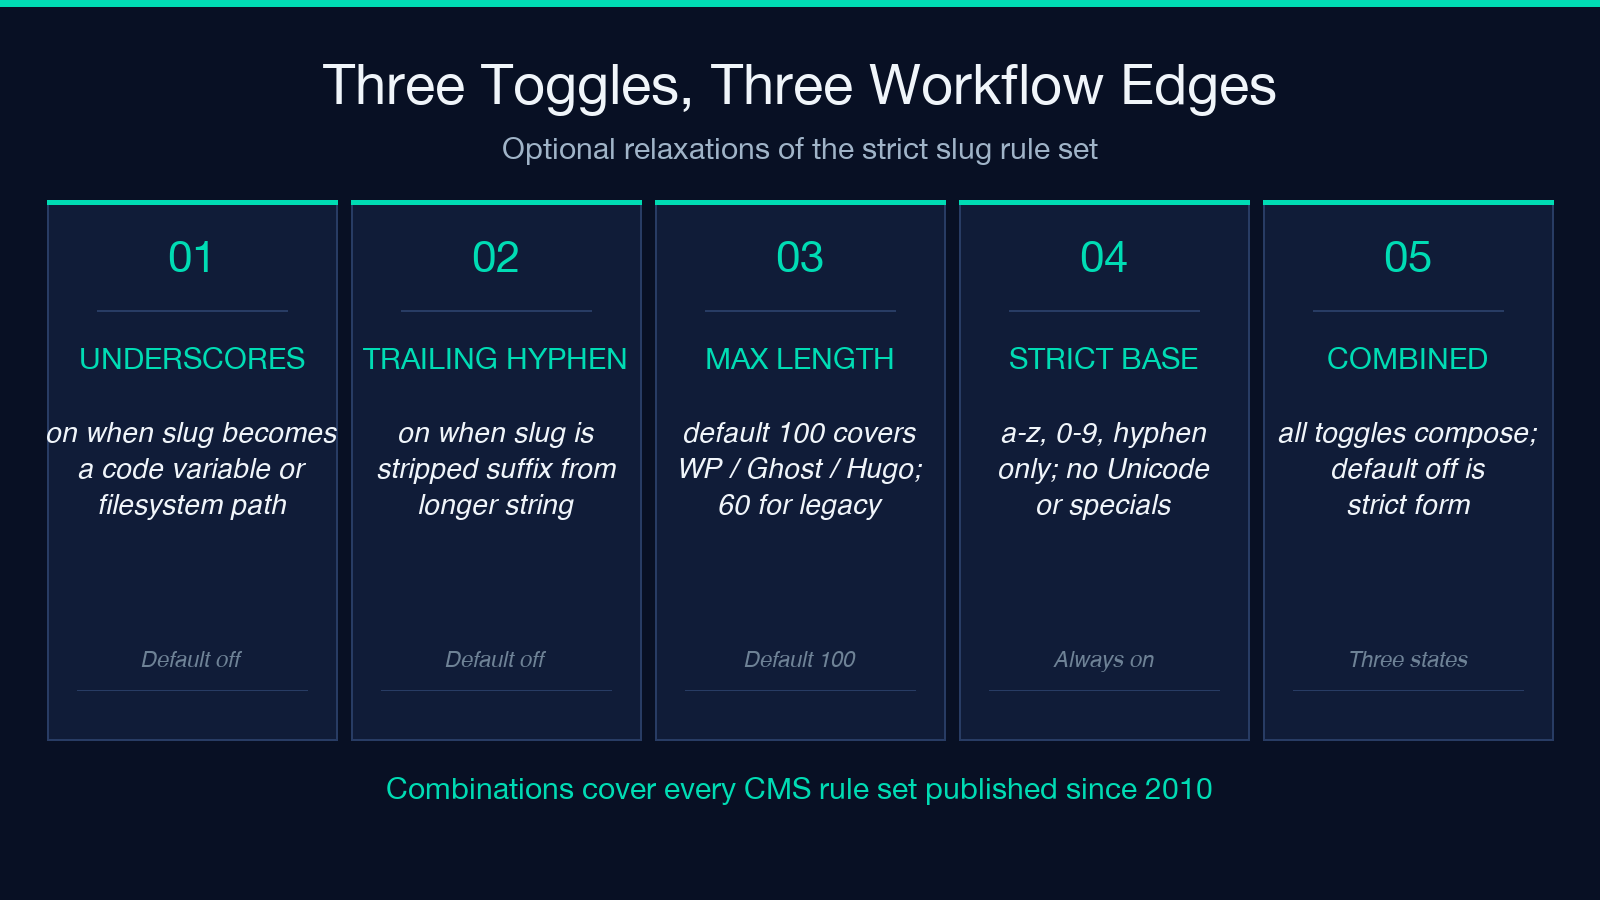
允许下划线:别名来自代码里的变量名时有用(my_blog_post → 对文件系统安全)。凡是要出现在 HTML 属性或 CSS 类名里的别名,请关掉。
允许尾部连字符:别名由长字符串剥掉后缀生成时有用(my-blog-post-final → my-blog-post-)。人工撰写的别名请关掉。
最大长度:控制别名长度上限。默认 100,覆盖 WordPress、Ghost、Hugo 和多数 CMS 平台。旧系统或需要适配 Twitter 卡片的地址可以降到 60;要存任意标识符可以放宽到 255。
这三个开关配上严格的基础规则,正好覆盖 2010 年以来各家用到的规则集,同时不会把合理例外判成错误。
批量校验别名:流水线视角
在内容流水线里,别名校验出现在三个位置,代价模型各不相同:
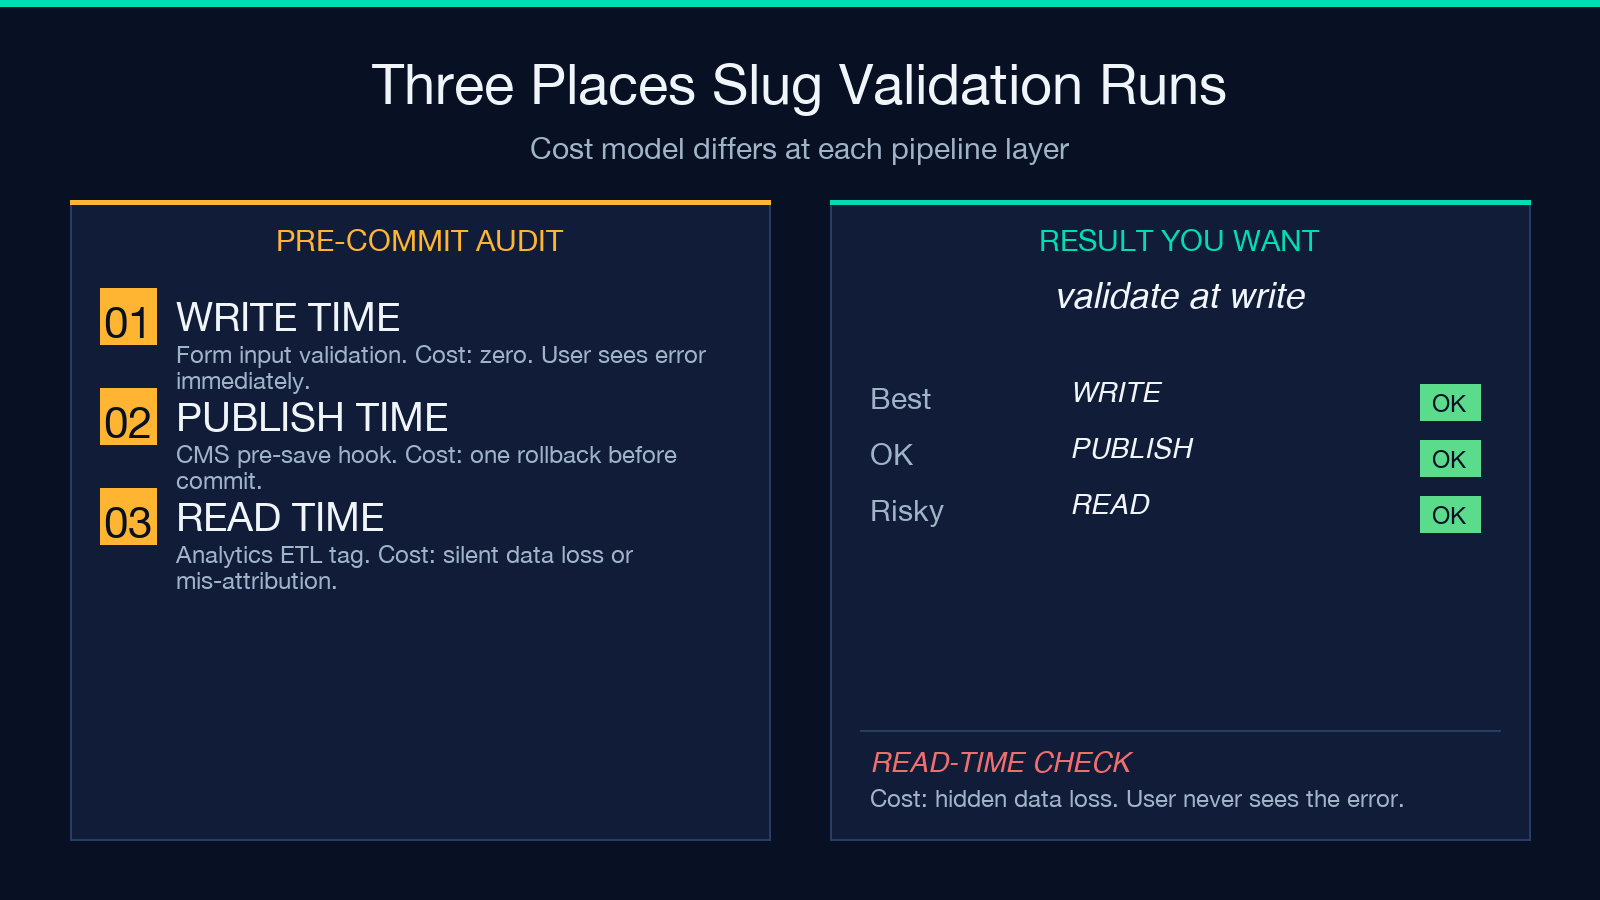
- 写入时(表单输入):代价为零,用户立刻看到错误并改掉
- 发布时(CMS 保存前钩子):代价是一次回滚
- 读取时(统计标签归一化):代价是数据静默丢失或事件归错
校验器是为场景 1 设计的:交互式、单字符串、开关显式可控。场景 2 和场景 3 的规则集小到可以直接内联进服务端的保存前检查,或塞进统计 ETL 作业。完整规则写在官方的别名样例里,逐条列出了这些开关本来要处理的边界情形。
开关覆盖不到的边界情形
有三类边界情形出现得够频繁,值得知道;又够稀少,不值得为它们专门加开关:
空字符串:一律拒绝。校验器先返回空输入错误,再谈规则。
单字符:单个字母或数字就是合法别名,CMS 会照样路由它。要不要允许,属于调用方的流程选择,校验器不做决定。
Unicode 字母:严格说,现代 Unicode 系统接受 naïve 和 café 作为合法别名字符。校验器的严格形式会拒绝它们,因为实践中的三层下游(CDN 边缘、统计标签、文件系统路径)仍然只认 ASCII。要强制 ASCII,就关掉「允许下划线」,只依赖严格形式。
综合起来看
别名格式是少数几个有 30 年稳定记录、规则能写在一张索引卡上的 Web 标准之一。最难的从来不是背规则,而是在写入时抓住那些失败情形,趁别名还没进入任何会静默出错的流水线。URL别名校验器 把这一行判断做成显式的:三个开关覆盖三种合理例外,默认规则集与 2010 年以来发布的每个 CMS 都对得上。更多别名、校验和标识符格式化的工具,可以在 elysiatools.com 浏览。

Pingback: Slug Validator Field Guide: When Five Rules Decide the Permalink Shape - COSESAI