
相关性分析表面上很简单:贴一份 CSV,拿到一个 -1 到 1 之间的系数,收工。真正会在哪里出问题,看《系数不是故事》(The Coefficient Is Not the Story)那篇就明白了。同一份数据换三种相关方法,可以排出三个不同的次序。系数 0.6 旁边可能躺着 p 值 0.18,整套「强相关」的说法就此悄悄作废。一份 CSV 里混着三列非数值字段,照样能算出一张看着合理的相关矩阵,直到你发现其中两列一直都是字符串。
这份实战指南拆解相关性分析器背后的实际取舍:三种方法差在哪,显著性检验到底算的是什么,热图为什么只是一层可视化而不是数值结果,缺失值和异常值怎样改变答案,分组列能解锁什么,以及怎样读置信区间才不至于过分相信它。
工具实际返回什么
把 CSV 贴进输入区,分析器会产出一组结构化结果:相关矩阵本身、p 值矩阵、置信区间带(开启时)、热图、针对最强几对的散点图建议,以及一段文字摘要,点出最大正系数和最大负系数。输出是纯文本加一张 SVG 热图,两者都能复制、截图,或者接进下游流水线。
CSV 格式刻意保持最小:一行列名做表头,下面是数值行。没有必填的 schema,也没有配置文件。非数值列会被静默跳过,这在探索性分析里是合适的默认行为,放到生产数据上就不合适了,那里你需要工具在列类型不对时直接报错。
为什么要有三种相关方法
皮尔逊(Pearson)是默认方法,也是大多数教程第一个教的方法。它衡量两个连续变量之间线性关系的强度,前提是两列大致服从正态分布,没有严重的异常值,也没有明显的非线性。这些前提成立时,系数的解释很直接。
斯皮尔曼(Spearman)是基于秩的替代方案。它不用原始值,先把每个值换成它的秩,再在秩上做一次皮尔逊等价计算。这让斯皮尔曼对单调非线性很稳健:Y 随 X 上升但不是直线上升时(想想营销投入与指数增长的营收,或者逐渐饱和的剂量反应曲线),斯皮尔曼看得见趋势,皮尔逊会漏掉。
肯德尔(Kendall)是第三种选择,适合小样本(n < 30)或大量观测共享同一秩的情况。肯德尔 tau 比斯皮尔曼 rho 更保守,取值幅度更小,概率含义也更直接:随机抽两个观测,它们在两列中排序一致的概率。
要避免的错误是把三种方法当成可以互换。一份 40 个观测、每列各有两个并列值的数据,皮尔逊可能报 0.62,斯皮尔曼报 0.71,肯德尔报 0.48。每一个在自己的假设下都「正确」;可要回答「这两个变量关联有多强」,在不知道你要找哪种关系的情况下,它们中没有哪个是标准答案。等级数据、排序问卷、任何原始值不具备等距意义的输入,选斯皮尔曼或肯德尔。稳定尺度上的连续测量,选皮尔逊。相关性分析器上的 Method 开关就是那根拉杆,正文该讲清楚什么时候拉它。
p 值、显著性水平,以及它们到底在说什么
显著性检验问的是一个是非题:假如两个变量真的相互独立,我们还会看到这么大的系数吗?答案以一个概率返回,就是 p 值。p 值 0.04 的意思是:在独立的原假设下,至少这么大的系数只会以 4% 的概率出现。显著性水平决定拒绝阈值:默认的 0.05 之下,任何小于 0.05 的 p 值都会被标成「这个系数不太可能是噪声」。
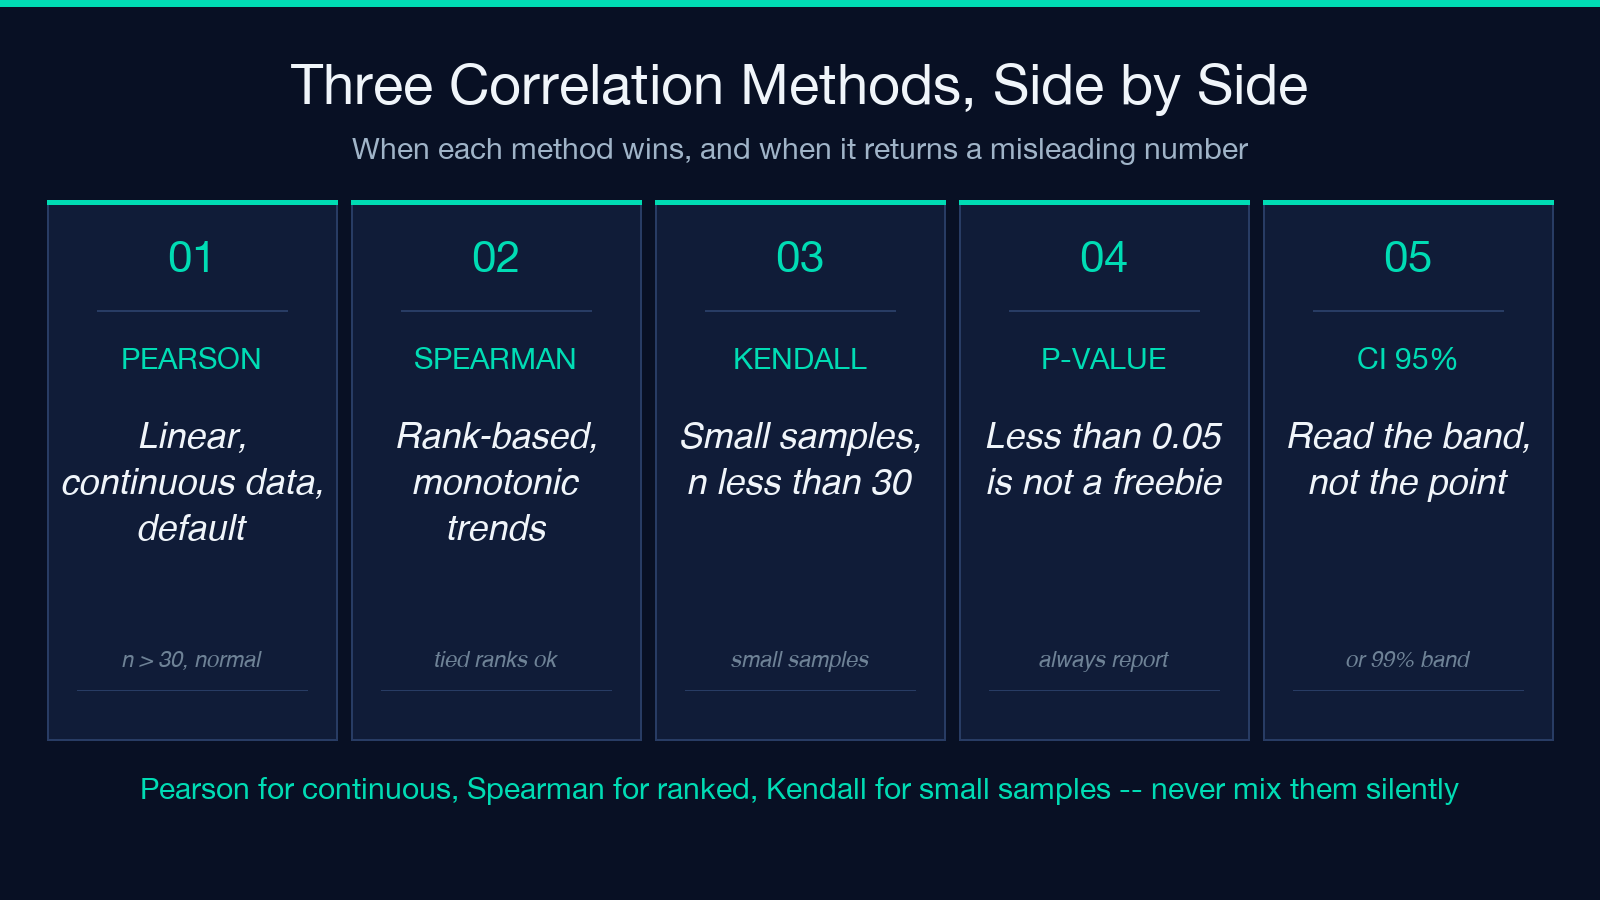
陷阱在于把 p 值当成质量分。系数 0.05、p 值 0.001,统计上显著,实际上毫无用处:两个变量几乎不共享任何线性趋势。反过来,n=12 上系数 0.6、p 值 0.18,那是真实信号,只是样本太小,分辨不清它和噪声的区别。系数和 p 值永远要放在一起读。显著性水平下拉框(0.01 / 0.05 / 0.10)只改阈值,不改检验本身。
在大数据集(n > 200)上做探索性分析,0.01 比 0.05 更稳妥:n=1000 时连极小的系数都能越过 0.05,0.01 这条线能把假阳性率压住。
相关矩阵,以及热图配色为什么误导
相关矩阵是标准产物:每个变量与其他所有变量两两配对,对角线上恒为 1.000。热图按系数大小给每个格子上色,通常是强负相关蓝、零值白、强正相关红。信任它之前有两句提醒。
第一,热图的色阶以零为轴左右对称,可「强负」和「强正」在下游的含义差别很大。利率与增长之间 -0.85 是有用的反向信号;两条价格序列之间 +0.85 是冗余信号。热图让它们看起来同样重要。
第二,k 个变量时矩阵有 k(k-1)/2 个非对角独立格。k=10 就是 45 个相关系数。在默认 0.05 显著性阈值下,即使是真正独立的数据,也预期出现 2-3 个假阳性。矩阵是用来探索的界面,不是用来决策的界面。工具上的热图开关是给人看的,真正要复制进下游模型的是矩阵的文本输出。
缺失值与异常值:两个改变一切的决定
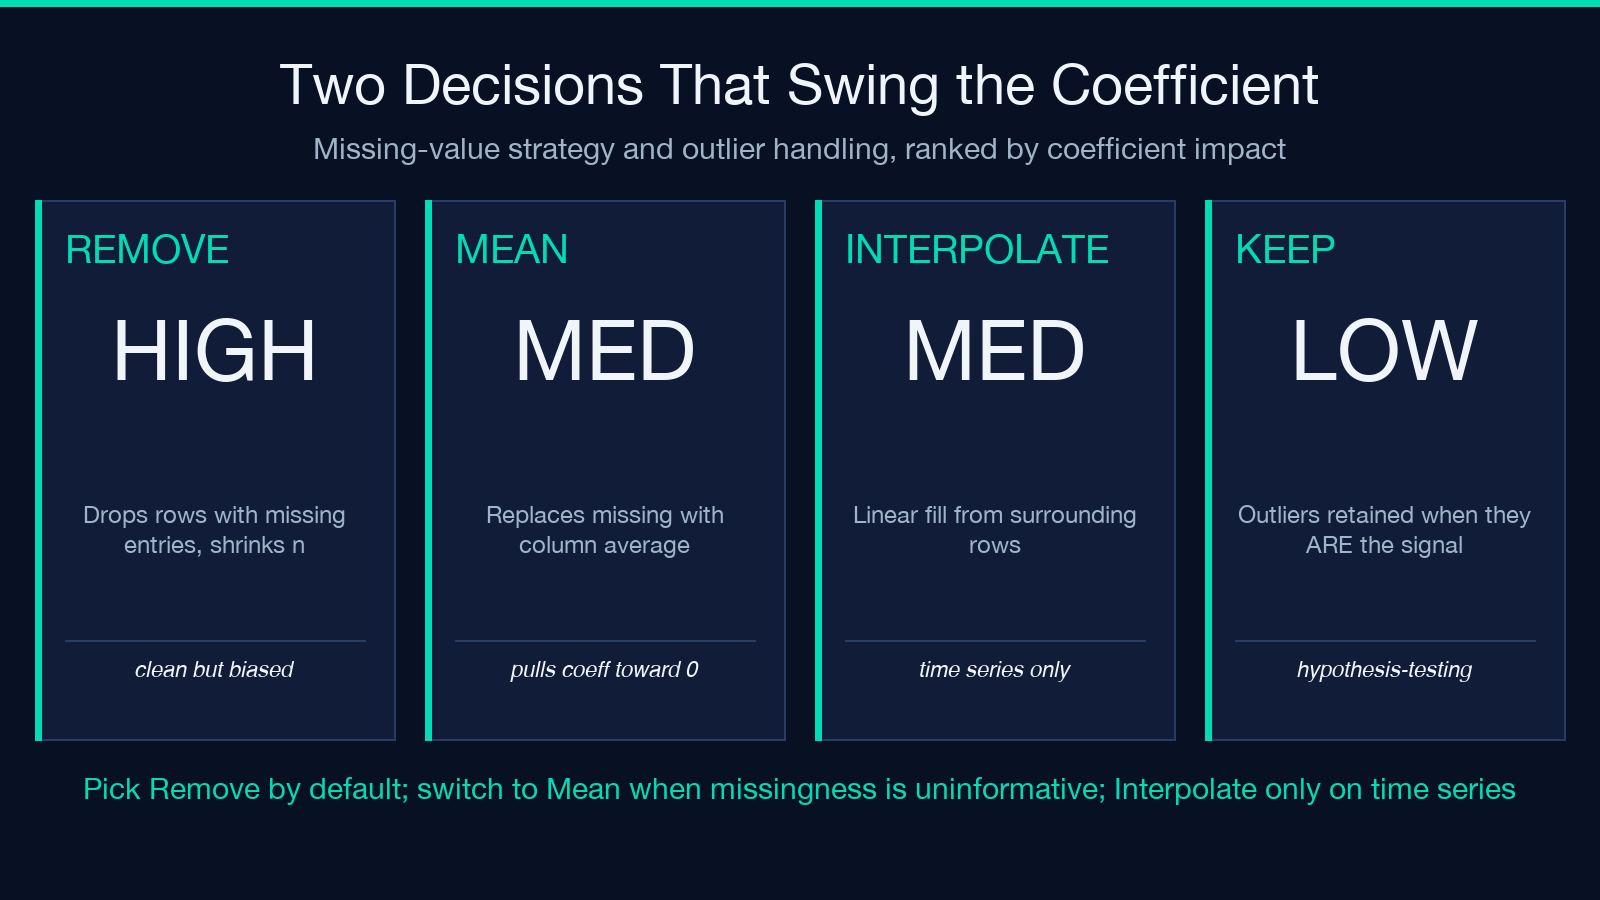
缺失值处理下拉框有五个选项,在脏数据上,选哪个能让系数摆动 0.3 甚至更多。Remove 丢掉任何含缺失项的整行,分析干净了,样本量变小,结果偏向数据完整的那些观测。Mean 用列均值填补缺失项,样本量保住,这一列的方差被压平,系数被拉向零。Median 用中位数做同样的事,对异常值更稳健。Interpolate 借助相邻行的线性趋势补齐缺失值,用于时间序列合适,用于横截面数据危险,那里没有有意义的「前一行」或「后一行」。Ignore 只对当前正在评估的那一对变量,取它们都有完整数据的行来跑,数学上站得住,代价是矩阵里每个格子的样本量都不一样。
异常值处理是第二根拉杆。IQR 标出落在 Q1-1.5IQR 或 Q3+1.5IQR 之外的值,这是中等偏态数据上的教科书选择。Z-score 标出偏离均值超过 3 个标准差的值,在接近正态的数据上表现好,在重尾数据上很差。Modified Z-score 用中位数绝对偏差,对极端异常值最稳健。默认的 Keep outliers 适合「异常值本身就是信号」的假设检验流程;异常值来自录入错误或传感器故障时,换成其中一种方法。
分组分析:一个系数盖住三个故事的时候
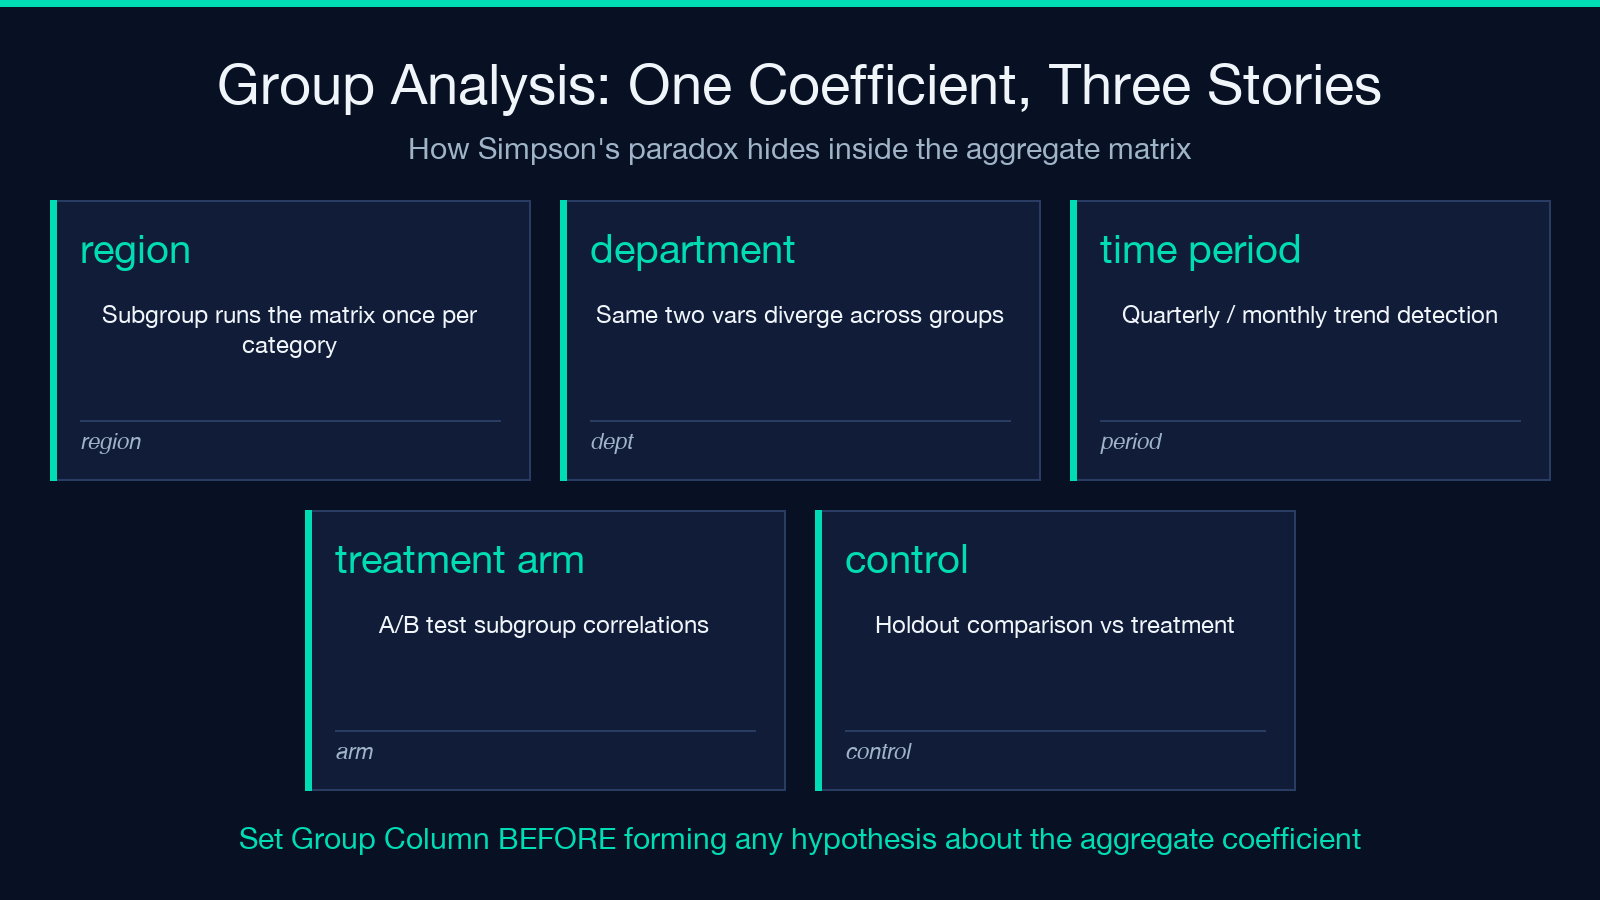
分组列是工具里最被低估的功能。填入一个分类列(地区、部门、时间段、实验组与对照组),分析器会按组各跑一遍相关矩阵。同一对变量,在一个地区可能是 +0.7,另一个地区 -0.2,第三个地区 +0.4。这就是辛普森悖论(Simpson’s paradox)在起作用:总体系数是各组相关系数的加权平均,取决于各组均值,它落在 [-1, +1] 哪个位置都有可能。
如果工具给你的第一个结论停在零附近,而各分组的系数相差悬殊,数据并不是在说「没有关系」,它说的是「关系取决于你问的是哪个分组」。有了分组分析的输出,这个工具才能用于 A/B 测试诊断、区域定价分析,以及任何以分组而不是整体为分析单元的工作流。
置信区间、小数位数与审计线索
计算置信区间复选框会为每个系数返回 95% 置信带,这是表达估计精度的正确方式。系数 0.62、95% CI 为 [0.41, 0.78],信息量足够;同样是 0.62,CI 却是 [0.18, 0.85],说明底下的信号是真的,估计却飘。不开它,每个系数看起来都同样可信,下游读者往往会高估质量最差的那些格子。
小数位数控制报告的精度。默认的 3 位对多数流程是合适的:4 位等于报告了底层数据并不具备的精度,2 位会藏起第三位上有意义的差异。详细统计开关会补上每一对的 n 和自由度,如果下游有人要手工重算 p 值,或者要和外部基准对比,你需要这些数字。
把上面的步骤串起来
走通这个工具最快的一条路:贴上 CSV,连续数据把 Method 留在皮尔逊(看到并列值、异常值或非线性就换斯皮尔曼或肯德尔),探索性分析把显著性水平设成 0.05,验证性分析设成 0.01,缺失值处理留在 Remove,除非缺失本身带信息,异常值留在 Keep,除非你有一份成文的清洗方案,把分组热图关掉。读矩阵的文本输出,别依赖彩色热图,颜色是装饰。系数和 p 值一起读,永远不要只读系数。如果问题是「这个关系在各分组上还成立吗」,先把分组列设好,再去琢磨总体系数。
相关性分析看起来简单,是因为输出只是每一对的一个数。真正的工作在上游:选哪种方法,用哪个样本,定哪个阈值,看哪个分组。这些选对了,系数自己会说话。
完整配置见 相关性分析器,更多统计工具在 Elysia Tools。
