DeepSeek 今天扔下了一颗重磅炸弹。
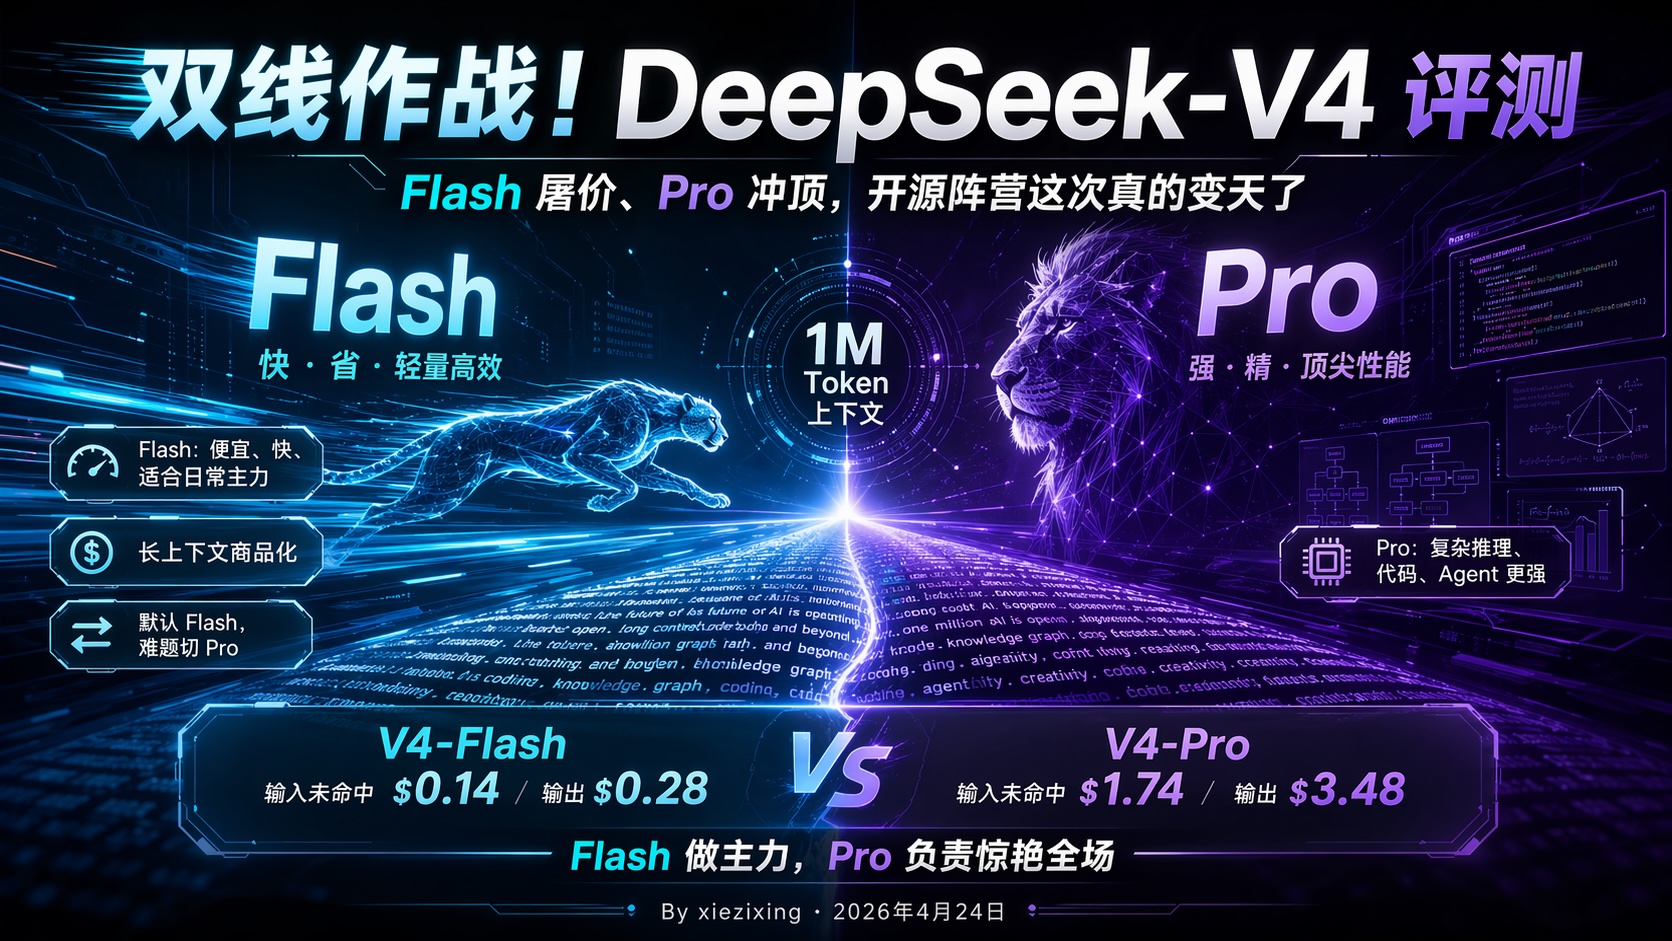
不是参数又刷榜了,也不是单纯”我们更强了”那种例行升级。这一次,DeepSeek-V4 直接玩了一手”双线作战”——一个旗舰 Pro,一个白菜价 Flash,两者都标配 100 万 token 上下文。换句话说,他们不仅把长文本的门槛拆了,还顺手把价格打到了地板上。
如果你只关心结论,那我现在就可以告诉你:Flash 做日常主力,Pro 做烧脑任务,这套组合拳可能是 2026 年开年以来开源模型阵营最狠的一次出牌。
两条产品线,一次把”贵”和”慢”都解决了
过去我们聊大模型,总觉得”强”和”便宜”是鱼和熊掌。DeepSeek 这次干脆不选了,直接出了两个模型:
DeepSeek-V4-Pro 是门面担当。1.6 万亿总参数,每次激活 490 亿,预训练数据超过 32T tokens。官方定位很明确:复杂代码、多步骤推理、Agent 自动执行、超长文档分析——那些真正”烧脑”的活儿,归它。
DeepSeek-V4-Flash 则是走量神器。2840 亿总参数,激活 130 亿。参数看着比 Pro 小一圈,但胜在便宜、快、能吃下长文本。普通聊天、批量生成内容、客服、轻量 RAG,Flash 完全能扛。
更关键的是,两者都支持 1M token 上下文,最大输出可达 384K。这意味着你可以把一整本书、一个完整代码库、或者几万条日志直接丢进去,而不用像过去那样掐着 token 数过日子。
价格离谱到什么程度?
先上数字,单位都是每百万 token:
| 场景 | V4-Flash | V4-Pro |
|---|---|---|
| 输入(缓存命中) | $0.028 | $0.145 |
| 输入(缓存未命中) | $0.14 | $1.74 |
| 输出 | $0.28 | $3.48 |
看比例可能没感觉,我们算笔账:如果你要处理 10 万输入 + 1 万输出,且缓存未命中:
- Flash 只要 约 $0.017
- Pro 要 约 $0.21
Pro 大概是 Flash 的 12.4 倍价格。 但即便如此,Pro 对比 Claude 3.7 Sonnet 或 GPT-4.5 这类闭源旗舰,仍然便宜得像是白送。
所以策略极其清晰:默认 Flash,难题切 Pro。 做 SEO 批量页面、摘要流水线、客服机器人、普通代码辅助,Flash 就是生产环境的首选;只有遇到代码库级重构、复杂 Agent 链、竞赛编程或者科研推理,才值得请 Pro 出场。
分数好看,但别只看总分
官方放出的 benchmark 里,有几个数字特别值得细品。
Flash 不是”廉价弱智版”——在 GPQA Diamond(科学推理)上,Flash-Max 拿到 88.1,Pro-Max 是 90.1,差距极小;LiveCodeBench 里 Flash-Max 91.6,Pro-Max 93.5。这说明只要给足思考预算(Think Max 模式),Flash 的推理能力非常能打。
但 Pro 的真正优势在”稳”和”深”。Terminal Bench 2.0(复杂 Agent 任务)里,Flash-Max 56.9,Pro-Max 直接拉到 67.9;MRCR 1M(百万 token 长上下文召回)里,Flash-Max 78.7,Pro-Max 83.5。越复杂的工具调用、越长的文档理解,Pro 的领先就越明显。
还有一个很多人忽略的点:中文事实性问答。Chinese-SimpleQA 上 Flash-Max 78.9,Pro-Max 84.4;SimpleQA verified 上差距更大,Flash-Max 34.1,Pro-Max 57.9。如果你做中文内容创作、知识问答、低容错的企业应用,Pro 的”靠谱程度”明显高出一截。
跟 GPT、Claude、Gemini 比,到底什么水平?
先说结论:代码、竞赛、Agent 方向已经非常接近甚至局部领先;纯知识准确率和最难的科学推理上,还是略逊于最顶级的闭源模型。
具体看几个硬指标:
- LiveCodeBench:Pro-Max 93.5,很强
- Codeforces 评分:Pro-Max 3206,已经进入竞赛级水平
- SWE Verified(真实软件工程任务):Pro-Max 80.6
- MMLU-Pro:Pro-Max 87.5,与 GPT-5.4 xHigh 持平,但低于 Gemini-3.1-Pro High 的 91.0
- GPQA Diamond:Pro-Max 90.1,略低于 GPT-5.4 的 93.0 和 Gemini-3.1-Pro 的 94.3
所以更准确的描述不是”全面打爆闭源”,而是**”在开发者最关心的几个硬核领域,已经咬住了最前沿,同时价格只有闭源模型的几分之一”**。对于靠 API 吃饭的团队来说,这个性价比本身就是颠覆性的。
真正改变游戏规则的是”长上下文商品化”
1M token 上下文不是 DeepSeek 第一个提出来的,但它是第一个把这个能力做到如此便宜、如此开放的。
以前用 Claude 3 的 200K 或 Gemini 的 1M,心里总得掂量一下账单。现在 Flash 处理百万 token 输入,缓存未命中也就 0.14,输出0.28。这意味着整本书的 RAG、大规模日志分析、超长论文综述,从”奢侈品”变成了”日用品”。
官方还强调了一个技术细节:在 1M token 场景下,V4-Pro 相比 V3.2 只需要 27% 的单 token 推理 FLOPs 和 10% 的 KV cache。这不是单纯堆参数,而是把长文本的”油耗”真正降下来了。
产业层面的信号:开源逼近闭源,国产算力闭环
这次发布还有一层容易被忽略的意义。
V4-Pro 的代码和 Agent 能力已经逼近闭源前沿,而 Flash 把高质量推理打到了极低价格。开源/开放权重阵营正在从”够用”走向”好用”,甚至在部分场景超越”好用”。开发者生态的重心,可能因此发生微妙但深刻的迁移。
另外,路透社报道称 V4 已适配华为 Ascend 芯片,华为也参与了部分训练支持。这和 DeepSeek 过去更依赖 Nvidia 的路径形成了鲜明对比。无论你怎么看地缘政治,一个事实是:中国 AI 生态正在加速构建”国产算力闭环”,而 DeepSeek-V4 可能是这个闭环里目前最硬核的模型。
我的使用建议(可以直接抄作业)
1. 默认用 Flash,别浪费钱
聊天、摘要、标签分类、文章改写、轻量代码、批量内容生成、客服——Flash 开 thinking 后能力足够惊艳,价格却低到可以忽略不计。
2. 复杂任务再切 Pro
代码库级修改、多工具 Agent 链、复杂数学推导、长文档深度问答、低容错企业任务——Pro 的稳定性和知识深度值得溢价。
3. 别无脑开 Think Max
Think Max 分数最高,但 token 消耗和延迟也会飙升。建议做路由:简单任务 Non-think,中等任务 Think,只有高价值或失败重试时才上 Max。
4. 现在仍是 Preview,保持观察
官方自己都叫 Preview,独立评测还在路上。我的判断是:V4 已经是开源阵营的第一梯队,但”全面超越最强闭源”这句话,现在还不敢替 DeepSeek 说。
一句话收尾
DeepSeek-V4 不是一次普通的版本迭代,而是一次”长上下文民主化”的宣言。当 Flash 能把百万 token 推理打到几毛钱,当 Pro 能在代码竞赛里跟 GPT-5.4 掰手腕,开源模型和闭源巨头之间的那道墙,已经越来越薄了。
对普通开发者和内容创作者来说,最务实的策略只有一个:让 Flash 成为你的默认引擎,把 Pro 留给你真正想惊艳全场的时刻。
参考文献与链接
- DeepSeek API 官方文档 – V4 Preview 发布说明:https://api-docs.deepseek.com/news/news260424
- DeepSeek API 定价页面:https://api-docs.deepseek.com/quick_start/pricing
- Hugging Face – DeepSeek-V4-Pro 模型卡:https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro
- AP News – DeepSeek 发布 AI 模型更新:https://apnews.com/article/d2ed33f2521917193616e061674d5f92
- Simon Willison’s Weblog – DeepSeek V4 评测:https://simonwillison.net/2026/apr/24/deepseek-v4/
- Reuters – DeepSeek 预览适配华为芯片的新 AI 模型:https://www.reuters.com/technology/chinas-deepseek-returns-with-new-model-year-after-viral-rise-2026-04-24/
- The Verge – DeepSeek V4 AI 模型预览报道:https://www.theverge.com/ai-artificial-intelligence/918035/deepseek-preview-v4-ai-model