
每张 Markdown 表格里都藏着某个空白单元格:你始终没要到的电话号码,没人用的中间名。这些格子是你有意留空的,转换却把这些格子删掉了。我实测了代价:一张 41 行的表里,8 行少了一列,13 个值待在了错误的表头下面。
四十一行进,四十一行出
我做了一张六列的通讯录,四十行,就是 README 或支持文档里常见的那种样子。五行没有电话号码,三行没有备注。然后我把它喂进与工具完全相同的那套转换逻辑。
实测结果:41 条记录进,41 条记录出。行这一层什么都没丢,所以这份输出扫一眼完全正常。接着我数了每条记录有几个字段。
- 33 条记录带回了完整的六个字段
- 8 条记录只带回五个
- 13 个单元格位置上的值原本属于另一列
四十行里短了八行,就是五分之一。这张表如果喂给 CRM 导入或者表格公式,五分之一的行现在把电话号码放在备注表头底下。文件能打开,没有任何解析器报错。错位一直潜伏着,直到有人拿某一行去对照列名才发现。
体积上的代价也量了,还是同一张表:2,697 字节的 Markdown 变成 2,088 字节的 CSV,小了 23%。勾上「Quote All Fields」,又涨回 2,564 字节。
破坏发生在两次串联的调用里
这个转换器是一条小流水线。每一行带竖线的内容变成一条记录,记录先被裁剪,再按竖线切分,然后过滤。看那段过滤。
cells = line.split('|').map(cell => cell.trim()).filter(cell => cell !== '')
两个操作挤在同一行代码里,对「空」的理解却不一致。切分保留了空 token,行首和行尾的竖线才不会变成幽灵列。过滤紧接着把这个空 token 删掉。等到过滤执行时,边界竖线产生的空串和你有意留空产生的空串,已经是同一个值。一条规则「丢掉空 token」修好了行的边界,同时弄坏了行的内部。
你写下的空格子,不是它删掉的那个空格子
过滤并不草率,解决的是真问题。像 | Ada | 42 | 这样一行会切出五个 token:第一个竖线之前一个空,中间三个真单元格,最后一个竖线之后一个空。什么都不剥,每行都会凭空多出两列。
所以这个过滤站得住脚。它分不清两种情况,因为 token 里没有任何信息记得自己来自竖线的哪一侧。换一行中间有缺口的试试。
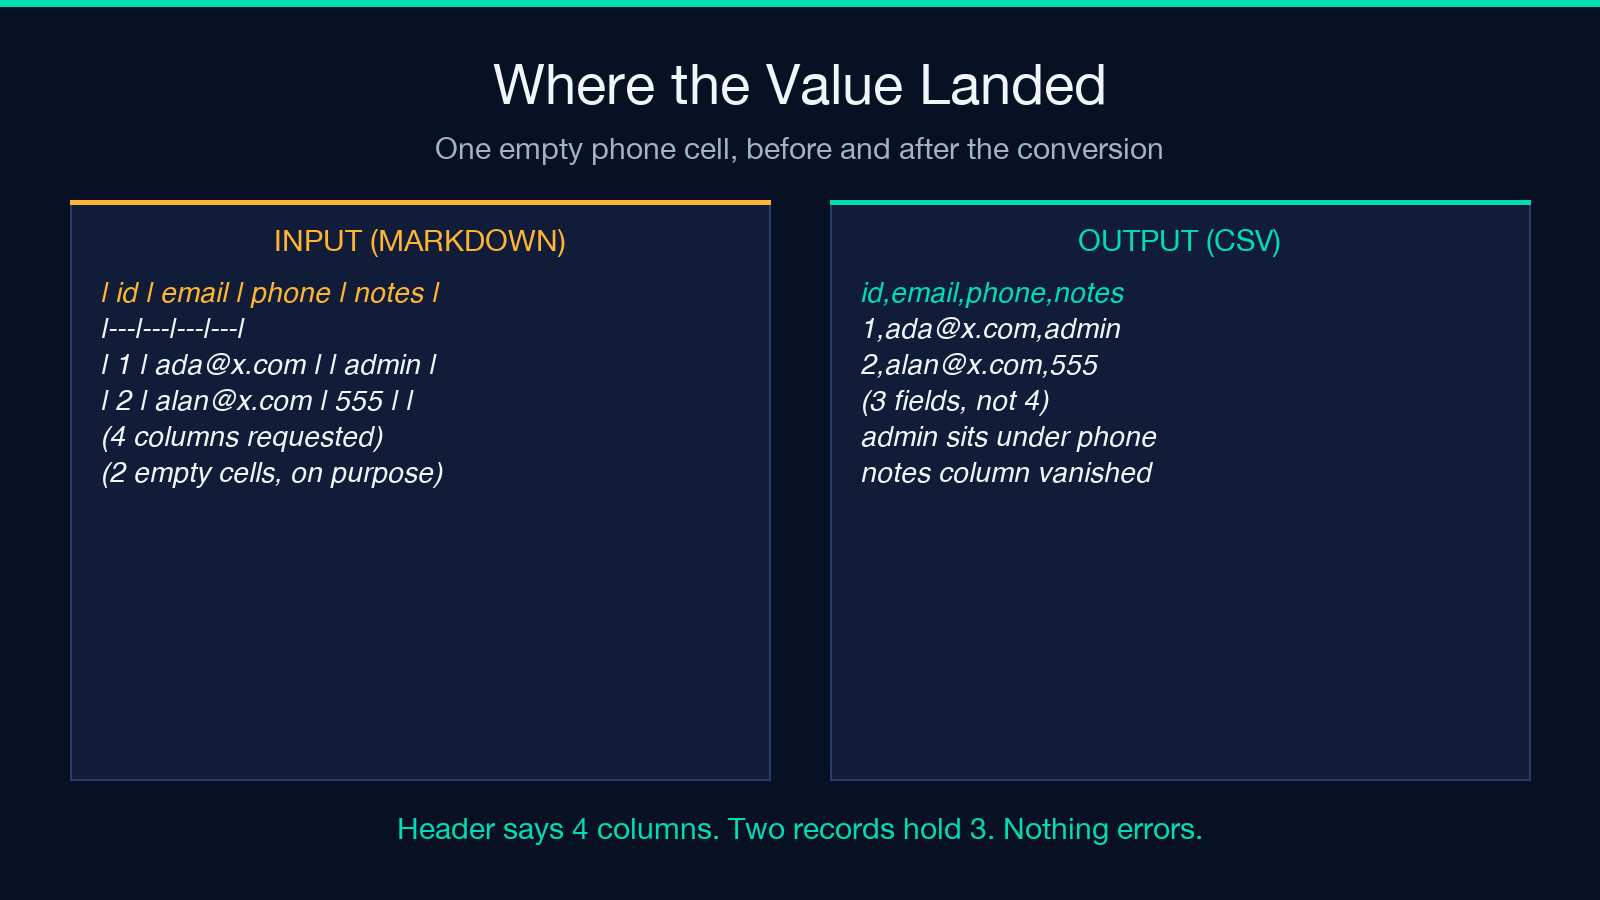
| Ada | [email protected] | | admin |
五个 token,四个非空。输出是 Ada,[email protected],admin,三个字段顶着四列的表头。这次错位把 admin 从备注挤进了电话列,这一行仍然是合法 CSV,字段数与列数不符是唯一留下的痕迹。
三根不算列分隔符的竖线
同一个切分完全没有转义的概念,日常 Markdown 里的三种写法都会变成断列。
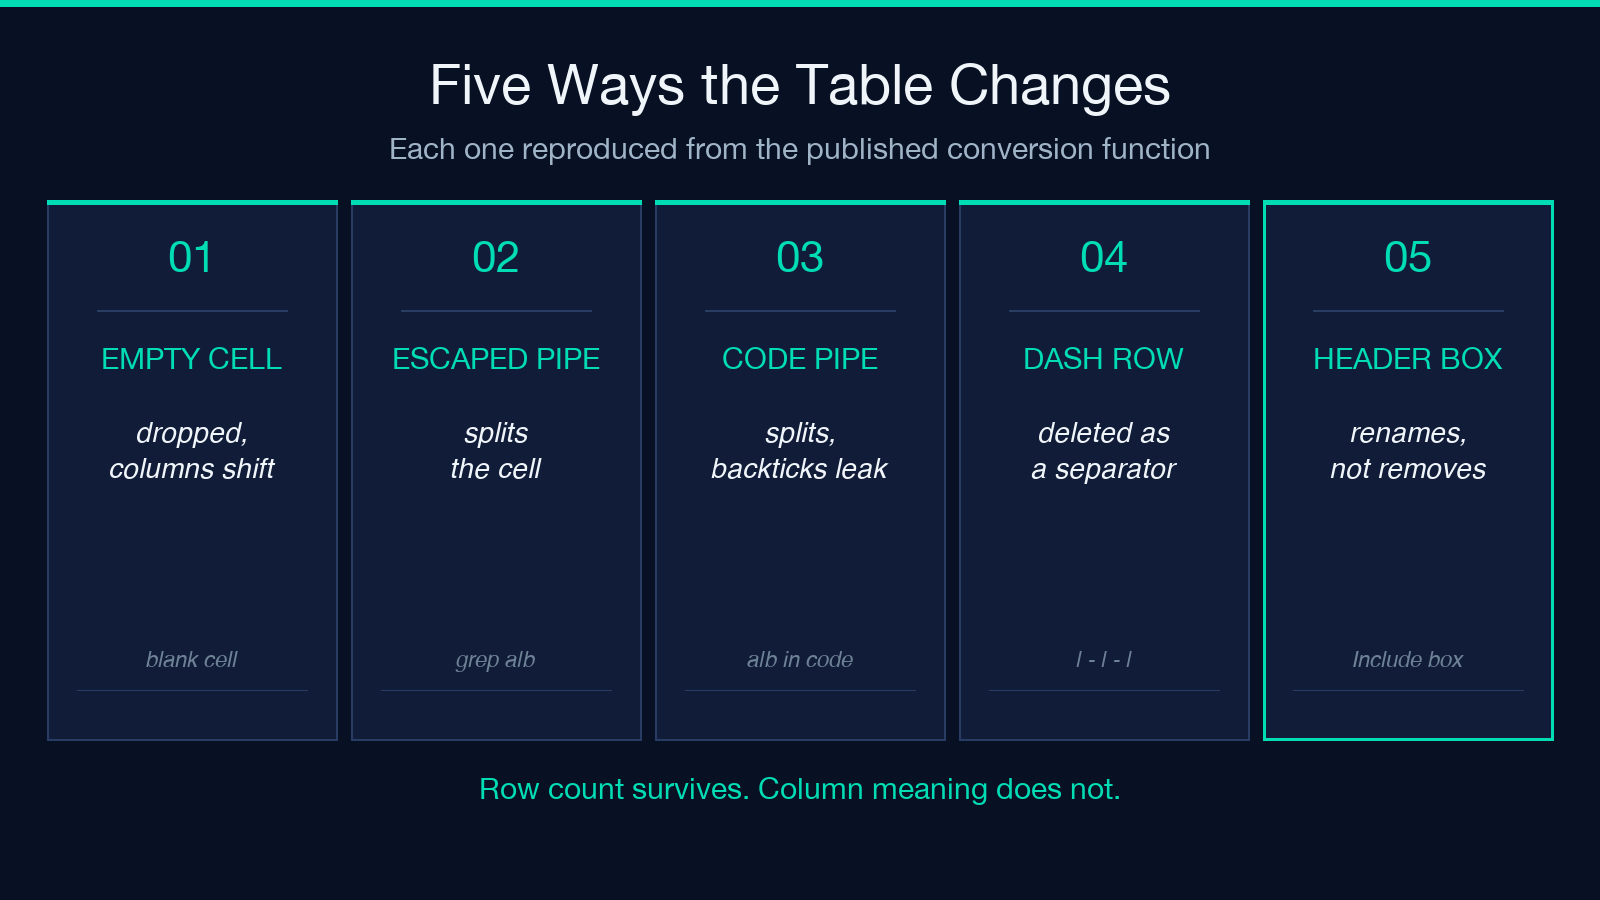
- 单元格里用反斜杠转义的竖线,这是表格里写竖线字面量的标准做法
- 行内代码片段里的竖线
- 表格之后某句话里的竖线
三种都是合法 Markdown,三种都会切开本该完整的单元格。转义竖线 grep a|b file 变成两个单元格,剩下的反斜杠留在输出里成了 grep a,b file。装着 a|b 的代码片段被切成两个未闭合的反引号,于是去反引号那一步永远不会触发,反引号原样进了 CSV。末尾那句 cat config | grep mode 更糟:它自造了一行表格记录,在输出里落成 Also run: cat config,grep mode。
取消勾选 Include Headers 是把表头改名,不是把表头删掉
这个标签读起来像一个丢掉首行的开关,代码干的却是另一件事。取消勾选后,转换器按列数凭空造一个表头,再把你真正的表头当成数据。
输入 | Name | Score |,下面是 | Ada | 91 |。勾着,输出先是 Name,Score,然后 Ada,91。清空勾选:Column 1,Column 2,然后 Name,Score,然后 Ada,91。
所以这个复选框什么都没删。造出来的名字顶替了你的表头,真表头降级成第一条数据记录。你要的如果是无表头 CSV,自己删掉那一行,别再指望复选框替你办。
一排短横线不是一排数据
分隔行规则会把单元格只由短横线和冒号构成的行整行切掉,对齐行就是这样消失的,而这条规则对数据行一视同仁。某行的值恰好都是一个短横线,它就被当成标点删掉了。
| Item | Qty | 下面 | - | - | 下面 | Bolt | 4 |,回来只剩 Item,Qty 和 Bolt,4。中间那行没了。拿短横线当占位符是写「无值」的常见办法,转换器把它读成分隔符。全是空的 | | | 会塌成零个 token,走同一条路径被跳过。
转换器做对了什么,边界又在哪里
难的那一半处理得对。单元格里的逗号会加引号,已有的引号重复一次,制表符和分号分隔符都受支持。Markdown 的强调、链接、图片、反引号会被剥掉,加粗的单元格不会带着星号过来。比如「Remove Markdown Formatting」默认开启,这个选项做到了标签承诺的事。
多张表能干净切开,中间用一个空行连起来。这个连接有讲究:记录之间的空行,对宽松的读取器来说很寻常,对严格按 RFC 4180 解析的程序却是一条单字段记录,所以一份文档里放两张表,不同工具会读出不同结果。参差不齐的行原样通过,没人修:三列的表头配一条两个字段的短行,得到一条两字段记录,没有补齐、没有报错、没有警告。
关于证据要说清一点。我实测的是把工具公开的转换函数逐行移植出来的版本,不是在网页界面上点。移植版复现了我读到的源码,站点跑的也是那份源码,但每个案例我都没在界面里走一遍。这些数字应当看作对公开逻辑的观察,不是对托管服务的基准测试。
信任这份 CSV 之前的两分钟检查
走一遍短流程,大部分风险都能排掉。
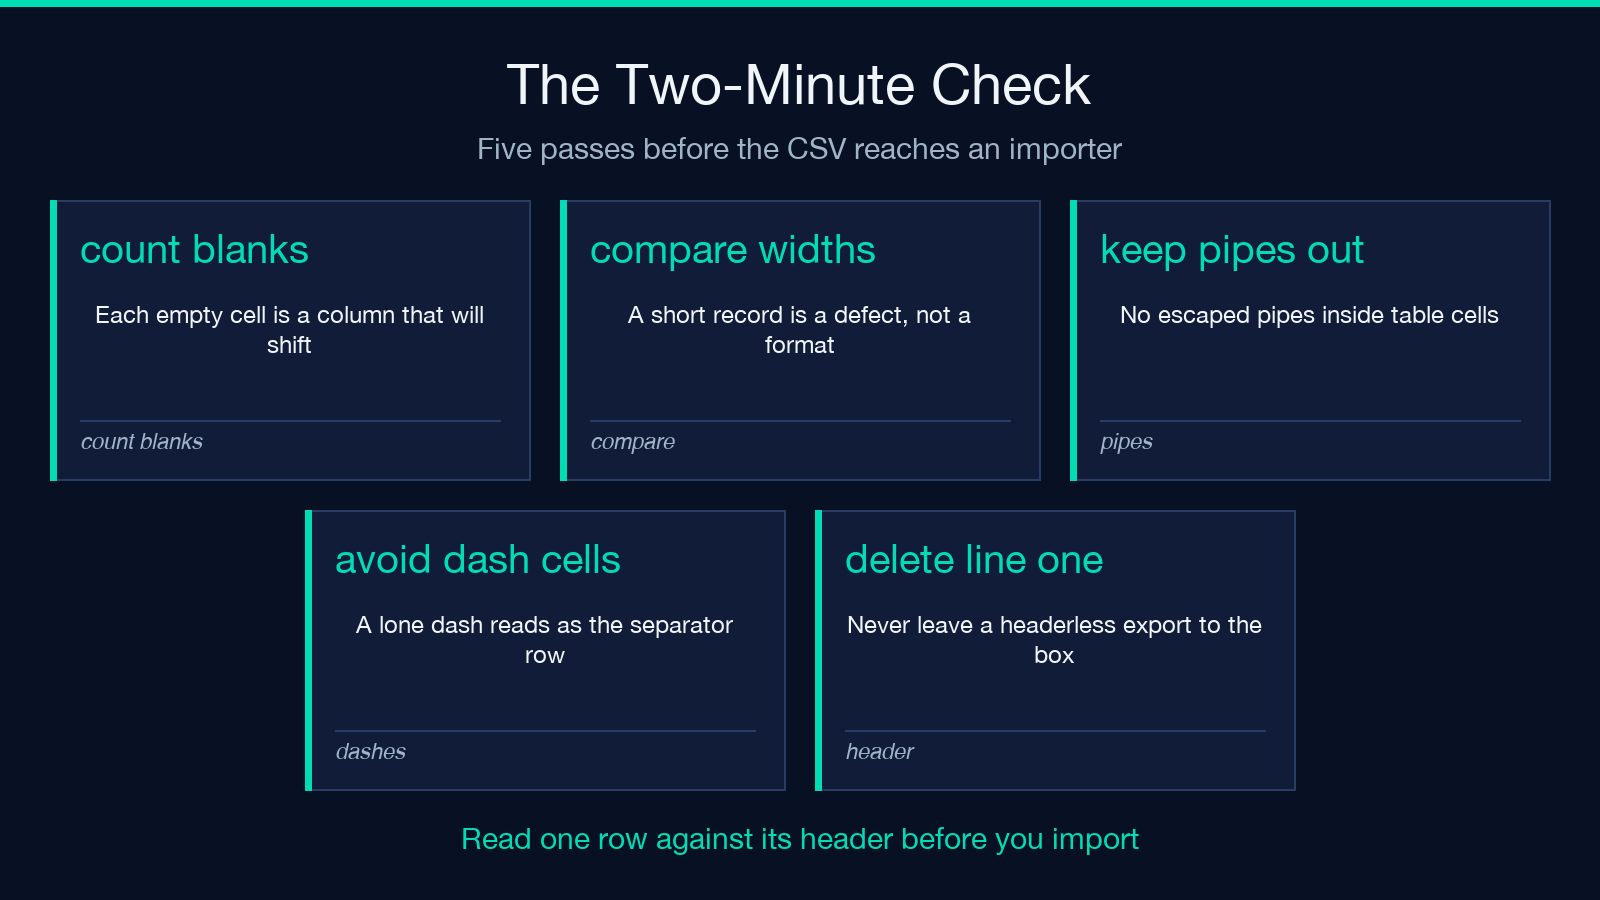
- 转换之前数一数源文件里的空白单元格,每一个都是一次错位
- 把表头宽度和每条记录的宽度对比,短记录当缺陷处理,别当格式
- 表格里别留转义的竖线,那段文字挪进围栏代码块
- 单元格里确实需要字面短横线,先写别的字符,事后再清理
- 无表头的导出永远别交给复选框,在自己脚本里删掉第一行
然后打开 CSV,拿一行对着表头读一遍。某个值待在错误的名字底下,你就在导入器之前发现了缺口。转换器本身在 Markdown转CSV,配套的 格式转换工具覆盖了流水线剩下的部分。
我一开始以为问题出在竖线上。它们吵,在输出里留下显眼的疤,diff 里一眼能看见。空白单元格很安静:你是刻意敲下这个格子的,转换器一声不响把它删了,这条记录照样被算作一行。四十一行进,四十一行出,从头到尾计数都是对的。所以在把文件交给导入器之前,问一个更笨的问题:哪些列是你故意留空的?

Pingback: A Blank Cell Is Not Empty. To a CSV Converter, It’s a Deletion. - COSESAI