
两个独立算法读同一份错误输入,会彼此一致,也会一致地违背你真正想画的那张图。我把 Tarjan 强连通分量 / 桥 / 关节点分解与拓扑排序器 的源码逐段看了一遍,把它报出的每个数重新推了一遍。在工具自带的 7 节点示例上,两个算法完全吻合;在你敲进去的图并不是你画的那张图时,它们同样完全吻合。这到底算谁的 bug?
交叉验证是真的,但它验的不是你的输入
工具对同一份边列表跑好几遍。它解析图,跑 Tarjan 强连通分量算法,再在反向图上跑 Kosaraju 的双通道算法,用 low-link 找关节点和桥,把分量缩成 DAG 并用 Kahn 入度法排序,报告环,最后用深度受限的 BFS 和 DFS 遍历图。
Tarjan 那一遍是迭代实现,显式维护一个帧栈,用 disc 和 low 数组,在栈回退时收集分量。Kosaraju 那一遍也是迭代的:先用迭代 DFS 记录完成顺序,再在反向图上跑第二遍收集分量。两者都不递归,节点链再长也不会爆调用栈。
那个「一致」徽章的含义比看上去窄得多。比较时先对各分量内部的成员排序,再对分量本身排序,所以它比的是划分,不是编号。Tarjan 的第 0 号分量和 Kosaraju 的第 2 号分量可以是同一批节点,这里就是。你读到的那张表用的是 Tarjan 的编号;Kosaraju 自己那份列表算完、比完就被丢掉了,源码里明确把它扔了。徽章就是一个布尔值。
两个算法走的是同一个邻接结构,它永远按你书写的方向、从你的边构建出来。两份实现可以因为输入正确而一致,也可以因为把同一个错误以同样的方式读错而一致。徽章认证的是算法,不是你的图。两者共享输入,一旦出现分歧就说明存在真 bug,所以「一致」是默认的预期结果,它对你喂进去的数据几乎不提供信息。
页脚声称每一遍都是 O(V+E),这里补一条诚实的脚注。这个界对 Tarjan、对 Kosaraju、对 low-link 割分析、对环分析、对两种遍历都成立。缩点里的 Kahn 循环是例外:它每弹出一个分量就把整份边列表扫一遍,代价是 O(C x E),C 是分量数、E 是边数。在这个工具可接受的规模上你感觉不到,到了 5000 个节点,可能会。
一行一个箭头,否则解析器会吞掉你半个图
解析器接受边列表(a b、a -> b、a,b,可带第三个数字 token),也接受 a: b c 这种邻接行。走边列表分支时,它先把行里的一个分隔符替换掉,再切分成字段,而这个替换只作用于行上找到的第一个分隔符。
于是一行 a -> b -> c 在第一个箭头被替换之后,变成字段列表 a、b、->、c。边取自前两个字段,得到 a -> b。那个字面量 -> 不是数字,也就没被当作权重读,它连同节点 c 一起被丢弃。这一次运行报出 2 个节点、1 条边,而不是 3 个节点、2 条边,解析警告 0 条。节点 c 在工具的世界里根本不存在。
把同样的意图写成一行一条边,你会得到 3 个节点、2 条边,还多出第三个关节点 b,一行版本从来没报过它。修法就是一个换行符。实测节点数从 2 变成 3,实测关节点数从 0 变成 1,其他设置一个都没动。
警告通道是存在的,但它只在这条边界的某一侧触发。字段太少的行会被拒绝,提示 Line ignored (need "a b" or "a -> b");字段太多的行会被接受,然后静默截断。整行丢弃时工具会告诉你,保留的行里丢了一部分,它一声不吭。
还有两个解析细节值得记住。行里任何位置出现冒号,这一行就会被送进邻接分支,所以 a: b -> c 会造出一个名字就叫 -> 的节点。第三个数字 token 会被解析成边权并挂在边上,而后续没有任何一遍读过它。权重被接受、被带着走,然后被忽略。
书写顺序决定分量个数
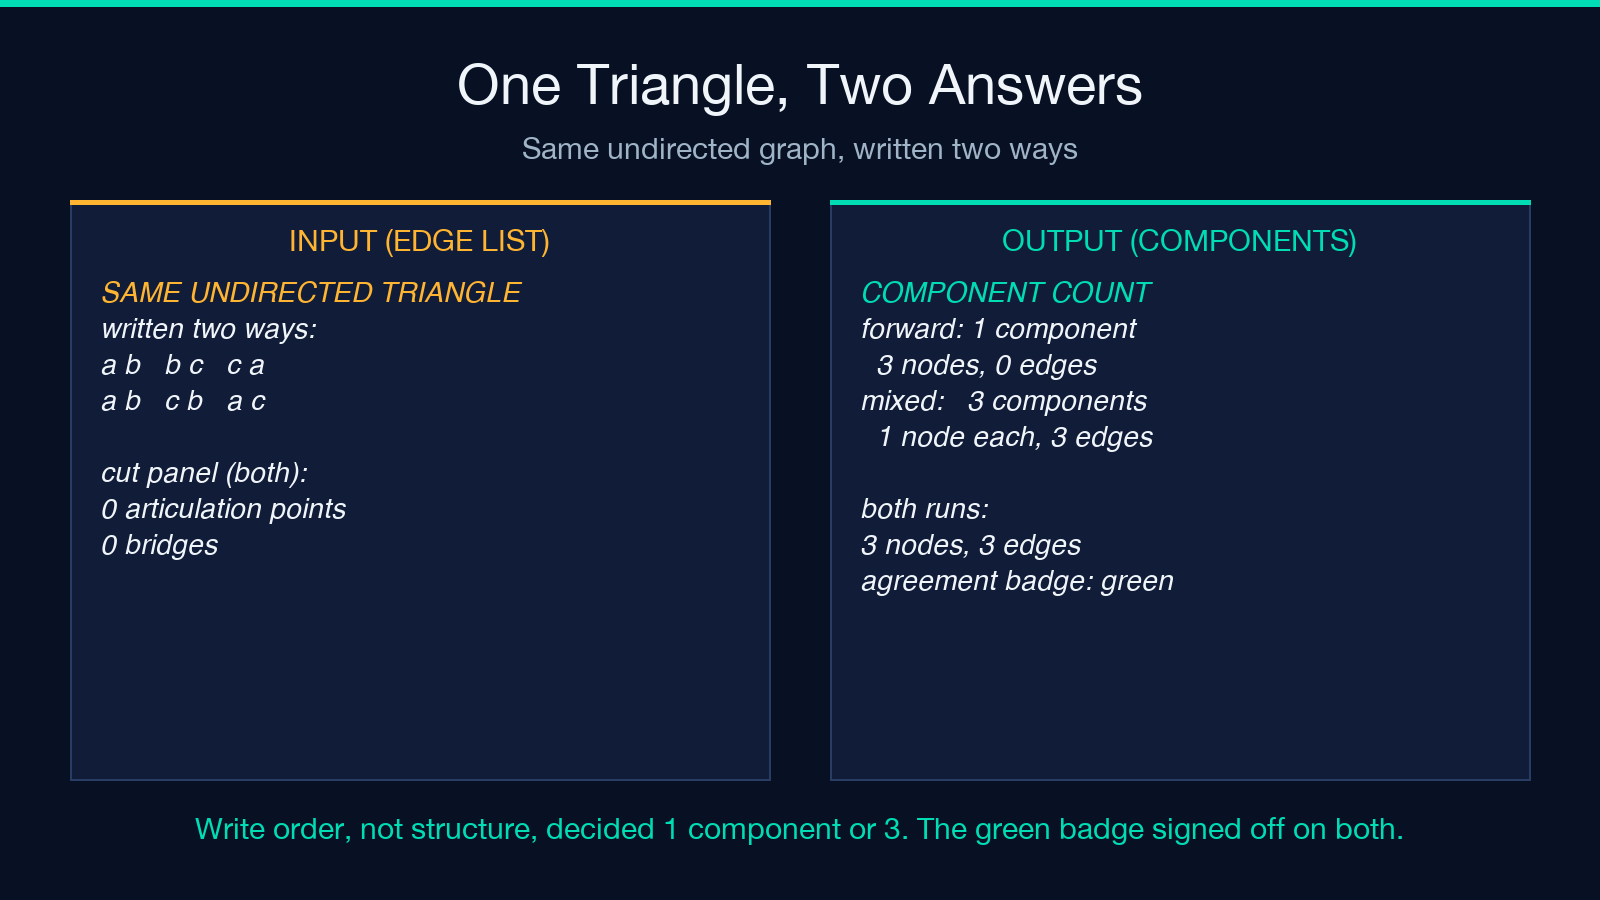
拿一个无向三角形,用两种写法写下来。第一种依次写 a b、b c、c a;第二种依次写 a b、c b、a c。两次都把「有向图」勾掉。
两种写法的无向视图完全一样:3 个节点上的一个完整三角形。割分析也完全一样:0 个关节点、0 座桥,因为三角形既没有割点也没有桥。分量个数则完全不同。
第一种写法的邻接是 a->b、b->c、c->a,是一个有向环,所以分量那一遍找到 1 个 3 节点分量,缩点结果是单个孤立节点。第二种写法的邻接是 a->b、c->b、a->c,是一棵树,所以分量那一遍找到 3 个单节点分量,缩点结果是 3 个节点、3 条边。
没有任何东西被解析错,也没有任何警告触发。两次运行都报 3 个节点、3 条边,徽章都是绿的。两份独立实现确认了同一个答案,这个答案描述的却是两张不同的图。差异只在缩点面板露出来,那里的形状完全不一样。
由此可以得出一条通用结论:强连通分量分解讲的是你写下的那张有向图,不是你想画的那张无向图。如果你要推理的是一个无向结构,分量面板回答不了你的问题。
「有向图」勾选框只打开一个面板
「有向图」勾选框听起来会改变整个分析,实际上它只改变输出里的一行。
跟着这个标志位走一遍实现,它只在一个地方被读:环分析。其他每一遍无论勾不勾都读同样的结构。Tarjan 和 Kosaraju 读邻接表,邻接表永远按你敲下的方向从你的边构建。缩点永远读同一份边列表。割分析永远读无向投影,勾不勾都一样,工具在割面板下面也正是这么说的。BFS 和 DFS 遍历永远读邻接表。
所以勾上「有向图」并不会让任何东西变成有向的。它只是打开环面板:环统计卡、自环列表、环上节点数,以及「为什么不存在完整拓扑序」的解释。
不勾这个框时,这个面板会隔着几行给出两个互相矛盾的说法。环统计卡显示 no,因为分析被跳过了,没什么可找。拓扑序那一行显示 none (graph cyclic) — component order: SCC...,因为排序字段是 null,渲染器回退到了这个固定字符串。下面那行细节又给出第三个版本:环分析只针对有向图。三行字描述的都不是你眼前这张图。
还有一处不对称收尾。自环是一个环,但自环也是一个单节点分量,分量表却只在分量成员多于 1 个时才打印 cyclic。在 a -> a、a -> b、b -> c、c -> b 这张图上,环面板数出 3 个节点在环上,分量表只把 {b, c} 标成成环,{a} 一点标记都没有。同一个节点,在一个面板里在环上,在另一个面板里不在。
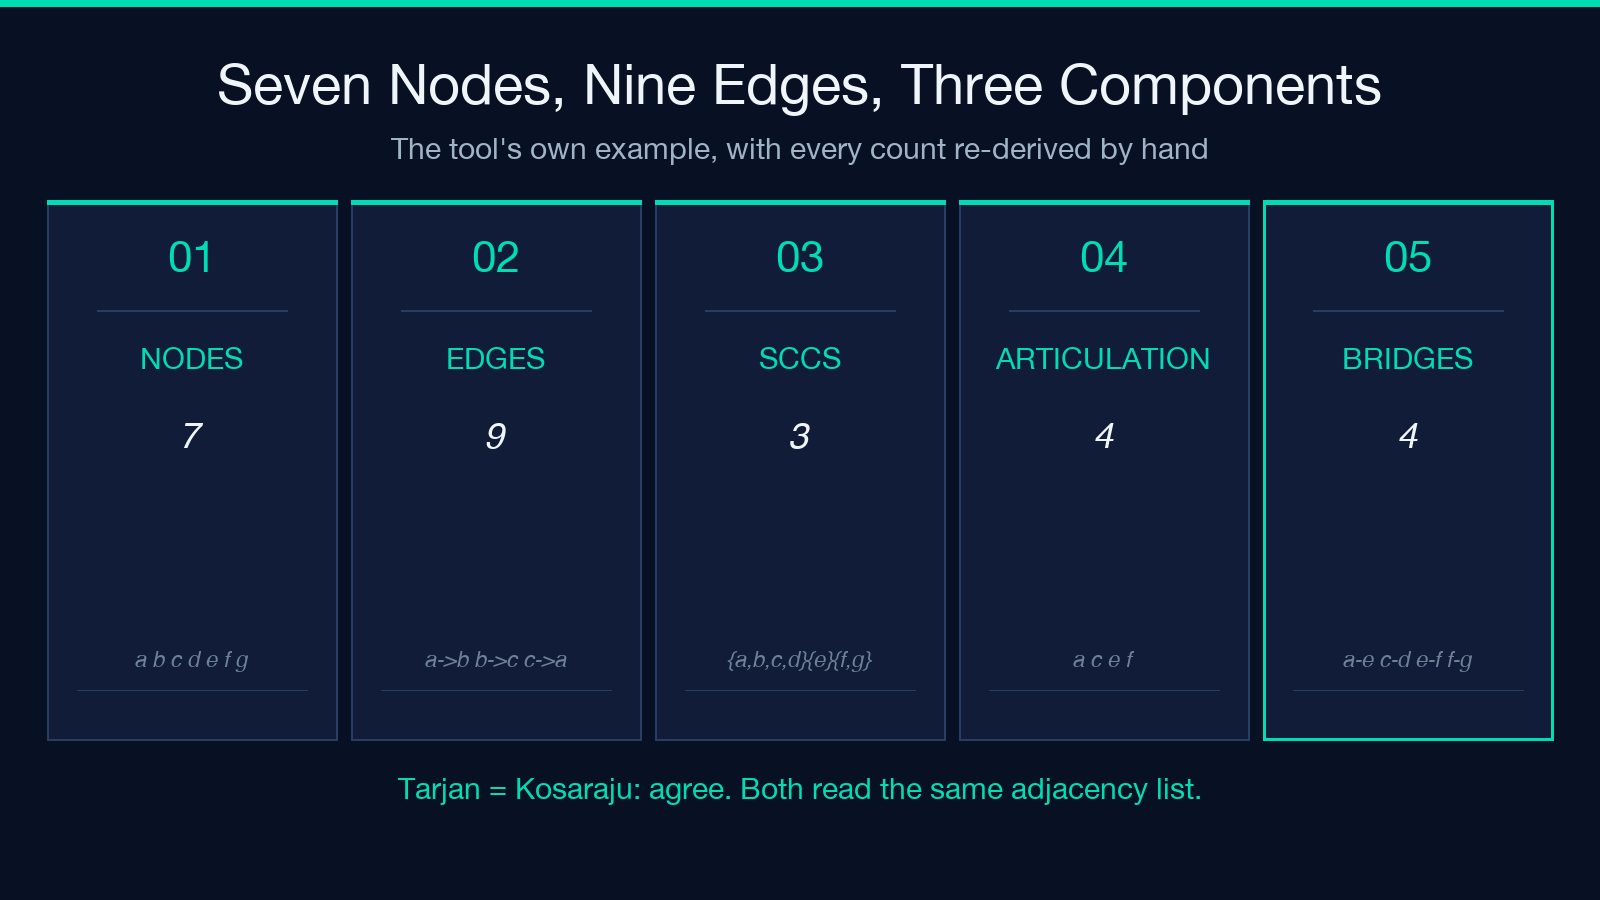
7 个节点,9 条边,3 个分量
工具自带的有向示例值得细看,里面每个数都能手算核对。
输入是 7 个节点、9 条边:a->b、b->c、c->a、c->d、d->c、e->a、f->e、f->g、g->f。Tarjan 找到 3 个分量:{a, b, c, d}、{e}、{f, g}。Kosaraju 找到同样的 3 个集合,顺序不同:{f, g}、{e}、{a, b, c, d}。排序之后完全一致,这就是那个徽章。
low-link 那一遍找到 4 个关节点 a、c、e、f,以及 4 座桥:a-e、c-d、e-f、f-g。缩点图有 3 个节点、2 条边,Kahn 法给出的顺序是 SCC2、SCC1、SCC0:先是 {f, g} 那个二元组,然后是 {e},最后是那个 4 节点块。
形状的原因讲得清。c->d 和 d->c 把 d 拉进了三角形 a->b->c->a,于是一个 4 节点分量把它吞了进去。节点 e 只靠一条边挂在 a 上,所以 a-e 是桥,e 是割点。f 和 g 自己闭合成一个二元环,f->e 又通过那座桥把这个二元组接回大分量。7 个节点里有 6 个在环上,唯一不在环上的 e,也是唯一一个纯粹的桥端点。
一个节点可以同时在环上又是割点。a 在 4 节点分量内部,仍然是关节点,因为割是在无向投影上算的:在无向图里删掉 a,e 就和图中的其余部分断开了。
遍历面板展示了深度上限在起作用。从 a 出发、最大深度 2 的 BFS 到达 3 个节点:a 在深度 0,b 在 1,c 在 2。其余 4 个列为不可达。
遍历面板也看你的箭头方向
BFS 和 DFS 读的是有向邻接,所以「有向图」框没勾,它们照样跟着你的箭头走。
拿 5 节点路径 a b、b c、c d、d e,用四种写法写下来,全部按无向处理,全部从 a 出发、深度上限 4。四种写法的无向视图都是 a-b-c-d-e。割分析在四种写法下都稳定:3 个关节点 b、c、d,4 座桥。缩点也稳定:5 个分量、4 条边。只有实测可达数在变。
- 顺序写
a b、b c、c d、d e:实测可达 5/5,深度 0 到 4,路径上所有节点都找得到。 - 写成
a b、b c、d c、e d:实测可达 3/5,d和e不可达。 - 写成
a b、c b、c d、e d:实测可达 2/5,c、d、e不可达。 - 倒着写
b a、c b、d c、e d:实测可达 1/5,只找到a。
最后一种最尖锐。路径里 a 落在箭头链的末端,所以 a 没有任何出边。遍历从 a 起步,无处可去,报出到达 1 个节点。隔了两个面板之外的无向投影,仍然显示 a 连着 b,两者之间有一座桥。
机制在混合写法里看得很清楚。在 a b、c b、c d、e d 里,节点 b 没有出边,遍历从 a 走一步到 b 就停了。在 a b、b c、d c、e d 里,链 a->b->c 在 c 处走不通,因为 c 唯一的那条边是指向它的。路径中间出现一个汇点,下游所有节点都被切断。
工具自带的第二个示例是正向路径、深度上限 3,可达 5 个节点中的 4 个,e 列为不可达。那是深度上限造成的,不是方向 bug,它的摘要行也这么说。两者仍然值得区分:深度上限让远端不可达,近端按顺序铺满;方向 bug 会在图的中间留一个洞,洞的两侧都有可达节点,遍历死掉的地方则是一个汇点。
老实读输出
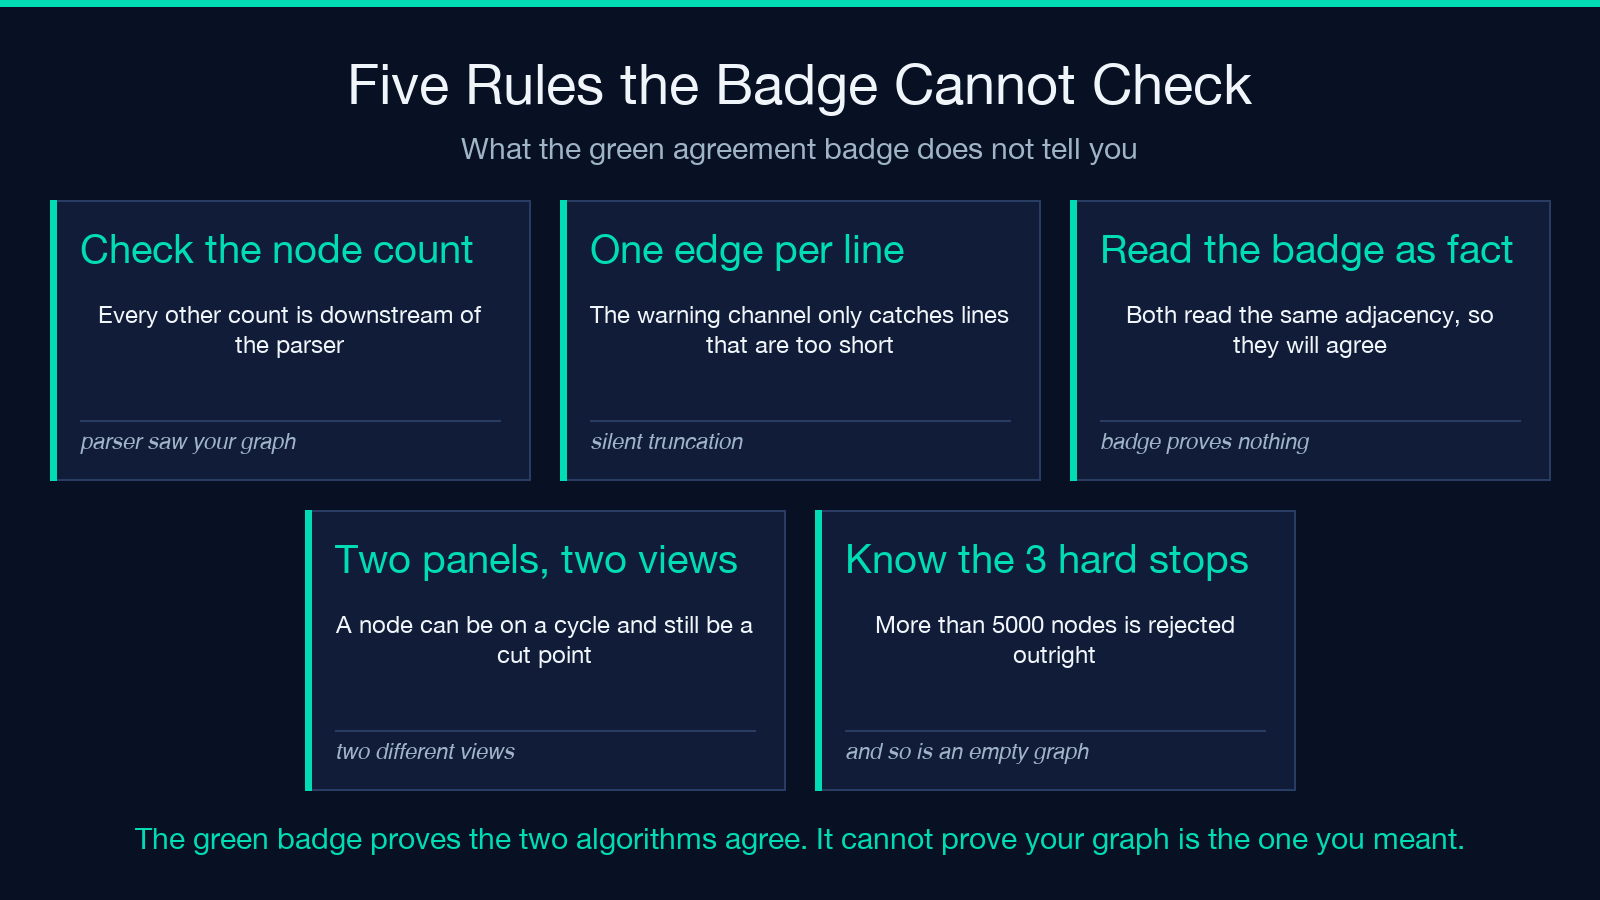
这个工具可以归成八条规则,每一条都对应实现里的某一行,不是关于图算法的泛泛建议。
- 先看节点数。它是唯一一个能反映解析器看到了什么的实测数字。
- 一行一条边。警告通道只抓太短的行。
- 把徽章当成关于算法的事实。两者读同一份邻接,所以必然会一致。
- 分量面板按有向读,割面板按无向读。一个节点可以在环上,同时又是个割点。
- 把「none (graph cyclic)」当成格式默认值。不勾框时,排序字段永远是 null。
- 自环要单独查环计数。自环在分量表里没有成环标记。
- 可达数会跟着箭头方向走。重排行的顺序,割不会动。
- 记住 3 个硬停点。超过 5000 个节点直接拒绝,没有边的输入也一样。
想要距离而不是分量时,图最短路径计算器(Dijkstra 手算辅助) 是最自然的搭配;最小生成树计算器(Kruskal / Prim) 用的正是这个工具割面板所依赖的那套无向加权视图;要把图弄成这个工具需要的边列表形式,GraphML / GEXF / 边列表网络转换器 是最实际的办法,比手敲箭头、事后才发现哪几行被丢掉要靠谱;当拓扑序本身就是目的、而非副产物时,关键路径法计算器(CPM 项目工期) 可以在活动网络上做排序,并且自带环检测拒绝。其余开发者工具可以在 Elysia Tools 的分类页里翻。
从这里往哪里走
7 节点示例、那个三角形,以及我喂给这个工具的每一份畸形输入,两个算法全都一致。我有时倒希望它们打起来。两份算法能以同样的方式一起错,这种实现比一个偶尔自相矛盾的实现更难发现,那个绿色徽章招来的信任,恰是解析器给不了的。
所以把节点数跟你本来想画的图对一下,并且一行只写一条边。算法不会替你做这件事,也永远不会告诉你它没做。问题不在于这个工具不可靠,而在于绿色徽章和正确的分解是两个不同的主张,徽章只能证明其中一个。
说到底,这个徽章提出的问题,是所有交叉验证都会提出的问题:两份实现一致时,是输入对了,还是它们把同一个错误以同样的方式读了一遍?老实的答案只要一个数字:数一下节点,然后比一比。

Pingback: Tarjan Graph Decomposer Field Guide: Two Algorithms, One Wrong Graph - COSESAI