
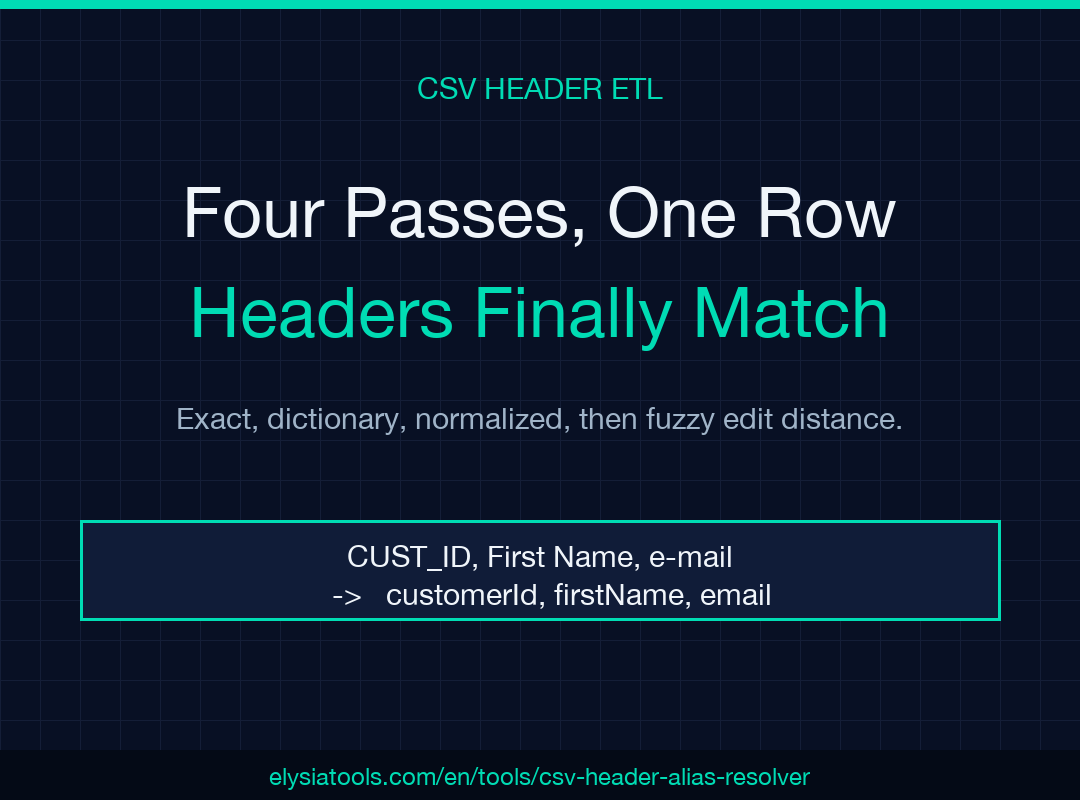
四道关卡,一次处理一行,你没写过的表头终于和你写好的表结构对上了。每条数据管道都会撞上同一面墙:源 CSV 里叫 CUST_ID,目标表结构要 customerId,JOIN 直接断掉。CSV 表头别名解析器把每个源表头依次过精确、字典、规范化、模糊编辑距离四道关卡,给出每一列命中的方式与置信度,并返回一张覆盖率表,在下游加载报错之前就告诉你是哪几个表结构槽位还空着。
本文按执行顺序拆开这四道关卡,再用一个把杂乱门店导出映射到干净 CRM 表结构的实例走一遍。读完你应该知道阈值怎么选、什么时候该补别名字典,以及为什么只靠模糊匹配也能救回一个差两个错字的表头。
表头漂移为什么会打断 ETL 加载
关系型数仓里的每个 join key 都从列名开始。源数据 feed 和目标表结构的名字一旦不同,JOIN 就静默返回零行,看板显示零,工程师凌晨 3 点被叫起来。漂移有三种形态:大小写(User_ID 与 userId)、分隔符(first name、firstName、first_name)、缩写(cust id 与 customer id)。第四种形态是错字,比如 frstname 或 emaiil,只在有人手工改过两次导出之间的表头时才冒出来。
朴素的 LOWER(header) = LOWER(schema) 能处理大小写,遇上分隔符就失效,遇上缩写也失效,面对错字毫无办法。纯 Levenshtein 匹配能抓错字,却会在合法区分上炸掉:customer_id 会以 0.85 的置信度匹配到 customer_id_clean,这是一种不该发生的碰撞。解法是分层:每一道关卡只处理它最擅长的那种形态,当前关卡失败才升级到下一道。CSV 表头别名解析器对每个源表头按顺序跑四道关卡,取第一个非空命中。
四道关卡,按执行顺序
解析器不会四道全跑再挑最高分。它按顺序跑,一旦某道关卡给出了命中就停下。这个顺序很要紧:把 customerId 直接丢给 Levenshtein 去比 customer_id,会返回 0.88 的置信度,结果是错的,因为规范化关卡能用 1.0 干净地处理掉。顺序是精确、字典、规范化、模糊。
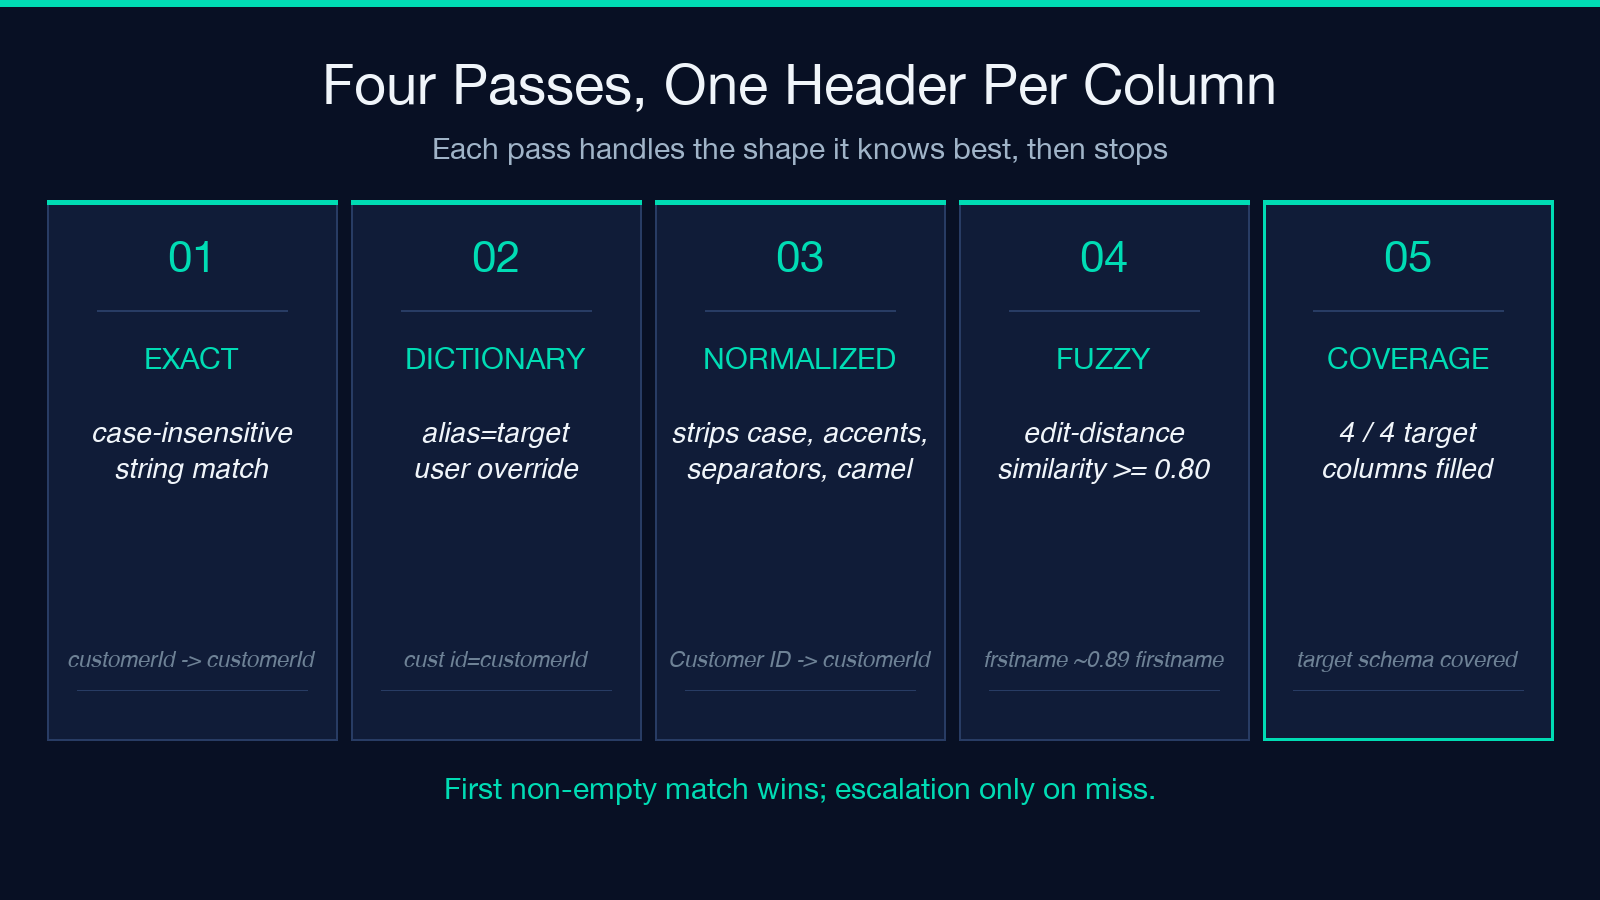
精确。忽略大小写的字符串比较。customerId → customerId。源表头本来就是规范形式时,这一关就赢了。
字典。每行一条别名,写成 alias=target。cust id=customerId 会把 cust id 改写成 customerId,再交给后面的关卡。字典条目永远优先于规范化,这正是它的意义:你说 cust id 就是 customerId,这个映射是人为约定的,应该压过规范化算出来的结果。
规范化。去掉大小写、重音、分隔符(_、-、空格)和驼峰词界,于是 Customer ID → customer_id → customerid,customerId → customerid,customer_id → customerid,全部收敛到同一个规范键,再拿这个键去和规范化后的目标表结构做精确匹配。
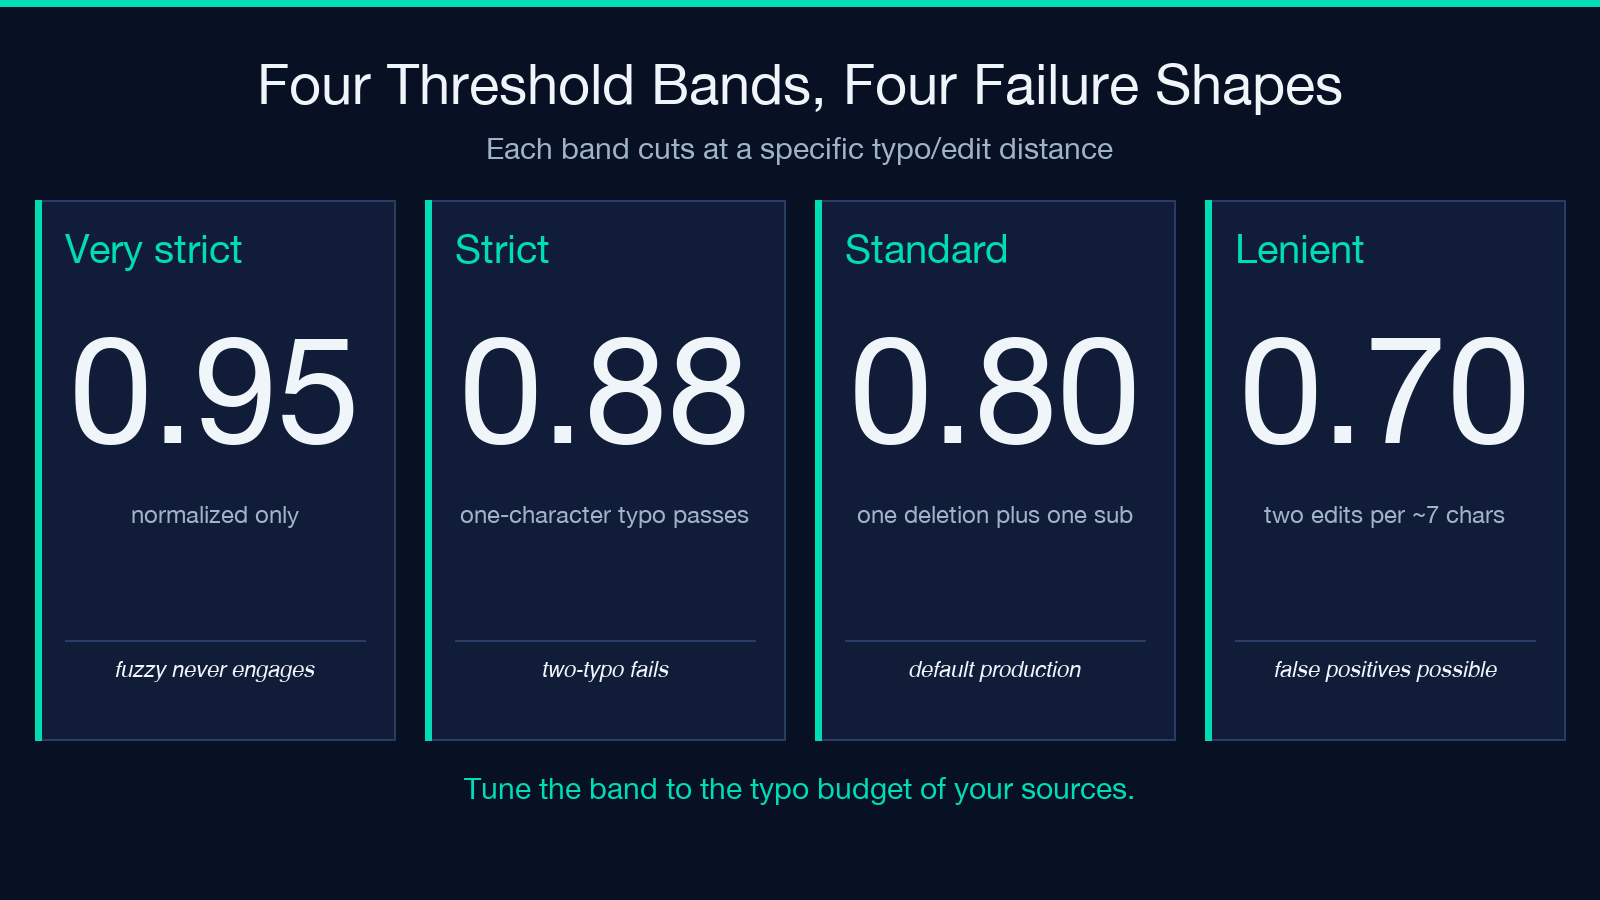
模糊。按选定阈值(0.95、0.88、0.80、0.70)做编辑距离相似度匹配。抓错字(frstname → firstname,0.89),也抓规范化漏掉的间距变体(e_mail → email,0.80)。返回阈值之上得分最高的目标列,没有超过阈值的就返回空。
实例:门店导出 → CRM 表结构
经典的 ETL 问题:Shopify 每天导出一份 CSV,表头是 CUST_ID、First Name、e-mail、Phone Number。CRM 表结构要的是 customerId、firstName、email、phone。朴素的小写加 join 会得到零行。
把 CSV 粘进去,分隔符设为逗号,粘上目标表结构(一行一列),再加一个小别名字典:
cust id=customerId
customer id=customerId
phone number=phone
阈值保持 Standard(0.80),打开「输出规范化 CSV」。解析器跑完得到:
| 源表头 | 解析为 | 方式 | 置信度 |
|---|---|---|---|
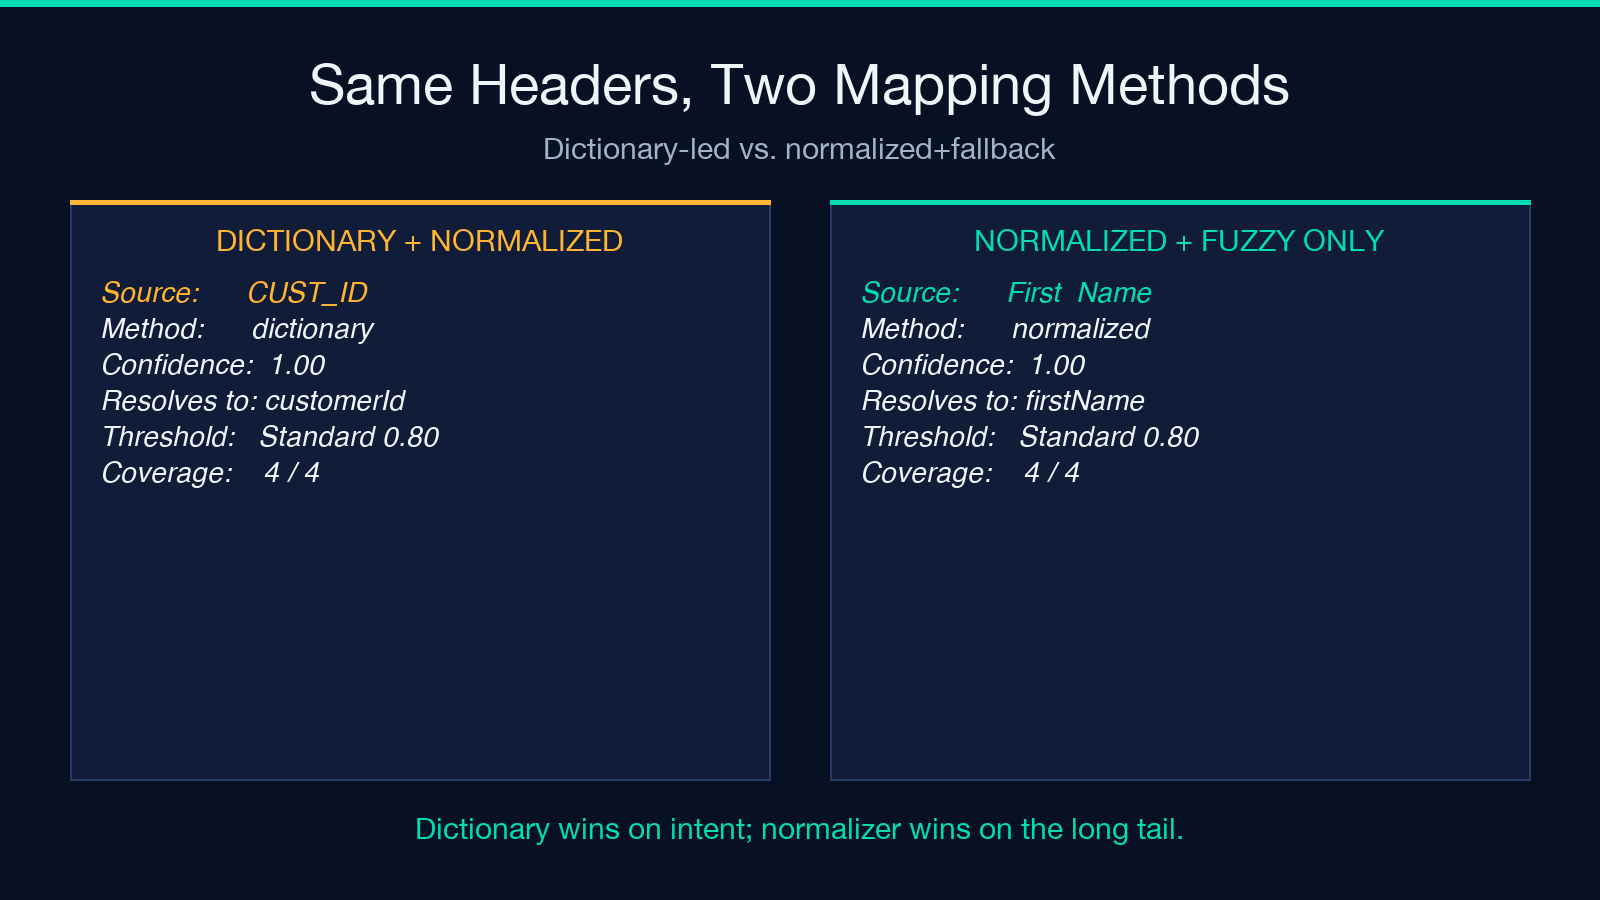
CUST_ID | customerId | 字典 | 1.00 |
First Name | firstName | 规范化 | 1.00 |
e-mail | email | 规范化 | 1.00 |
Phone Number | phone | 字典 | 1.00 |
覆盖率 4/4。规范化 CSV 导出里已经有四个规范表头,JOIN 到 CRM 每一行都能落位。整条流水线就是 CSV 表头别名解析器,全程在浏览器里跑,数据不出本机。
纯模糊模式:字典为空的时候
有些管道没法预先建字典,因为每个源用的表头习惯都不同。把别名字典留空,阈值降到 0.70,让解析器退回到规范化加模糊。
给定:
First  Name,frstname,emaiil
Grace,Hopper,[email protected]目标表结构:firstName、email。输出:
| 源表头 | 解析为 | 方式 | 置信度 |
|---|---|---|---|
First Name | firstName | 规范化 | 1.00 |
frstname | firstName | 模糊 | 0.89 |
emaiil | email | 模糊 | 0.83 |
覆盖率 3/3,宽松阈值下全中。两个错字能过 0.70,是因为编辑距离小(各差一个字符)。把阈值拧到 0.95,frstname 就会退成 fuzzy: empty,这条覆盖率警告会逼人补一条字典。
阈值调节:每一档切在哪里
四个阈值不是随手定的,各自对应一类失败形态:
- 很严格(0.95):只有规范化命中才算赢,模糊从不介入。想让解析器在任何一个没有干净规范形式的表头上大声失败、逼你为每个例外补字典时,用它。
- 严格(0.88):单字符错字能过,双字符错字过不了。生产 ETL 的默认值,一列一个错字是现实中的上限。
- 标准(0.80):一次删除加一次替换,或两次删除。抓得住
e_mail→email(插入了分隔符)、frstname→firstname(一次删除)。 - 宽松(0.70):大约 7 个字符允许两处编辑。抓得住
emaiil→email,也会把customer_id_clean匹配到customer_id,在带后缀的列名上可能误报。只适合配合目标表结构复核使用。
模糊关卡总是返回阈值之上得分最高的目标列。两个目标列都过阈值,就取分高的。如果解析器报告两个表头以高置信度落到同一个目标列,那是真正的碰撞:你的目标表里有重名,加载前得先去重。
输出覆盖率:缺列表
覆盖率是解析器最重要的输出。它告诉你四道关卡跑完之后,目标表结构里哪些槽位还是空的,也就是加载时会被 NULL 填上的列,因为源里没有任何东西匹配上它们。
覆盖率 100% 就是全绿。低于 100% 有两种可能:表结构要的列源里根本没有(下游在源建好之后加了列,这是典型情形),或者源的每一种写法四道关卡都没过(典型情形是目标列名本身有错字)。两种情况都要人来判断,解析器不会替你猜。
源里有、目标表结构里没有的列,会被标成未映射源列。映射表是双向的:每个源表头占一行,每个目标列要么配到源列,要么空着。未映射的源列通常可以直接丢掉,但值得扫一眼,有时源里有个 email_backup 列,CRM 其实也该收进去。
字典和规范化怎么选
两者不能互换。字典条目是人为声明:cust id 就是 customerId,句号。哪怕以后某个源写成 cust_id、规范化本来也能接住,这条声明依然优先。字典赢在设计上。
用到字典的时候:
- 源和目标之间有已知的语义缺口(缩写、内部黑话)。
- 规范化会产生错误匹配(
cust id和customer id都规范成customerid,可你的表结构里同时有customerId和customerIdHash,就得靠字典区分)。 - 某个固定的源写法必须永远落到同一个目标列,不管规范化算出什么。
只用规范化的时候:
- 源格式良好,只是大小写或分隔符不一致。
- 你不想为多个源维护一份字典。
- 目标表结构稳定,规范化能覆盖所有已知写法。
多数生产管道两者都用:一份小字典处理已知的人为映射,规范化兜住长尾。同一套逻辑做成的工具就是 CSV 表头别名解析器,一次跑完四道关卡,把每一列的方式和置信度都列出来,你能审出每个表头走的是哪条路。
拿你自己的管道试一次
找出真实表头漂移问题最快的办法:把最近一次让 JOIN 挂掉的 CSV 和目标表结构一起粘进去,看覆盖率表。低于 100%,缺的那几行会告诉你规范化漏了哪些写法、哪些列源里确实没有。一份 10 行的字典通常就够补上缺口。
想找更多数据整理工具,可以在 Elysia Tools 浏览,目录里还有 CSV、JSON、表结构校验,以及紧挨着表头解析器的整套 ETL 辅助工具。

Pingback: CSV Header Alias Resolver Field Guide: When Four Passes Fold a Row of Messy CSV Headers Onto One Clean Schema - COSESAI