
句号在成为小数点之前,只是个标点。1,204 里那个逗号、日期戳里的连字符、查询字符串开头那个问号,都是一样的道理。标点符号规范化器的用途是让引号、逗号和括号在整份语料里保持一致,这件事它做得不错。但它还带了个默认开着的开关,标签写着「Normalize Spaces」,我实测了这个开关的效果:3.14159 传进去,出来变成 3. 14159。
这个发现最扎痛的是把规范化当成安全前置步骤的人。对散文而言,这确实成立;对标识符不成立,而真实文本里两者往往同时存在。
同一个字形,在散文里和在数据里各有各的职责
句号在句子里当之无愧。在 3.14159 里它是小数点,在 example.com 里它分隔域名标签,在 v2.5.1 里它承担版本结构,它还能分隔 IP 地址和文件扩展名。
五种角色,一个码位,字符级映射表分不清它们。这是这类工具诚实的局限,不是这一款的缺陷。任何不解析上下文就改写字符的规范化器,都会在某处和数据里的标点撞车。
更有用的问题要窄一些:哪些设置会撞车,撞到什么,以及能不能在一份语料进去之前把撞车关掉。
我没照着标签猜,而是读了工具的源码,再把逻辑移植到第二份实现里,用固定输入比对输出。下面每一组都是这样测出来的。
两张表,三十二对映射,一个顺序决策
这个转换器是两张手写的查找表,按顺序做全局替换。中译英表有三十二条,英译中表有十八条。对散文来说足够全面,粗疏的程度也值得你在信任它们之前读一遍。
表里有三个细节会改变这一遍清洗的行为。比如欧元符号映射到它自己,这条空操作暴露出表是手工拼起来的。摄氏度符号映射成一个裸 C,这是套着标点外衣的单位换算。双 em dash 的规则排在单全角连字符之前,所以一对破折号会被整体换成两个连字符,不会被拆开处理。
英译中的方向挖得更深。它把连字符换成双 em dash,把星号换成参考标记,把尖括号换成中文书名号。这三条映射对中文散文没问题,对技术文本是破坏性的。
吃掉小数点的那个默认开关
空格规范化只跑一条规则,没有豁免名单:逗号、句号、问号、感叹号、分号或冒号后面跟非空格字符时,就在它后面插一个空格。下面是用工具默认设置跑一句普通句子的实测结果。
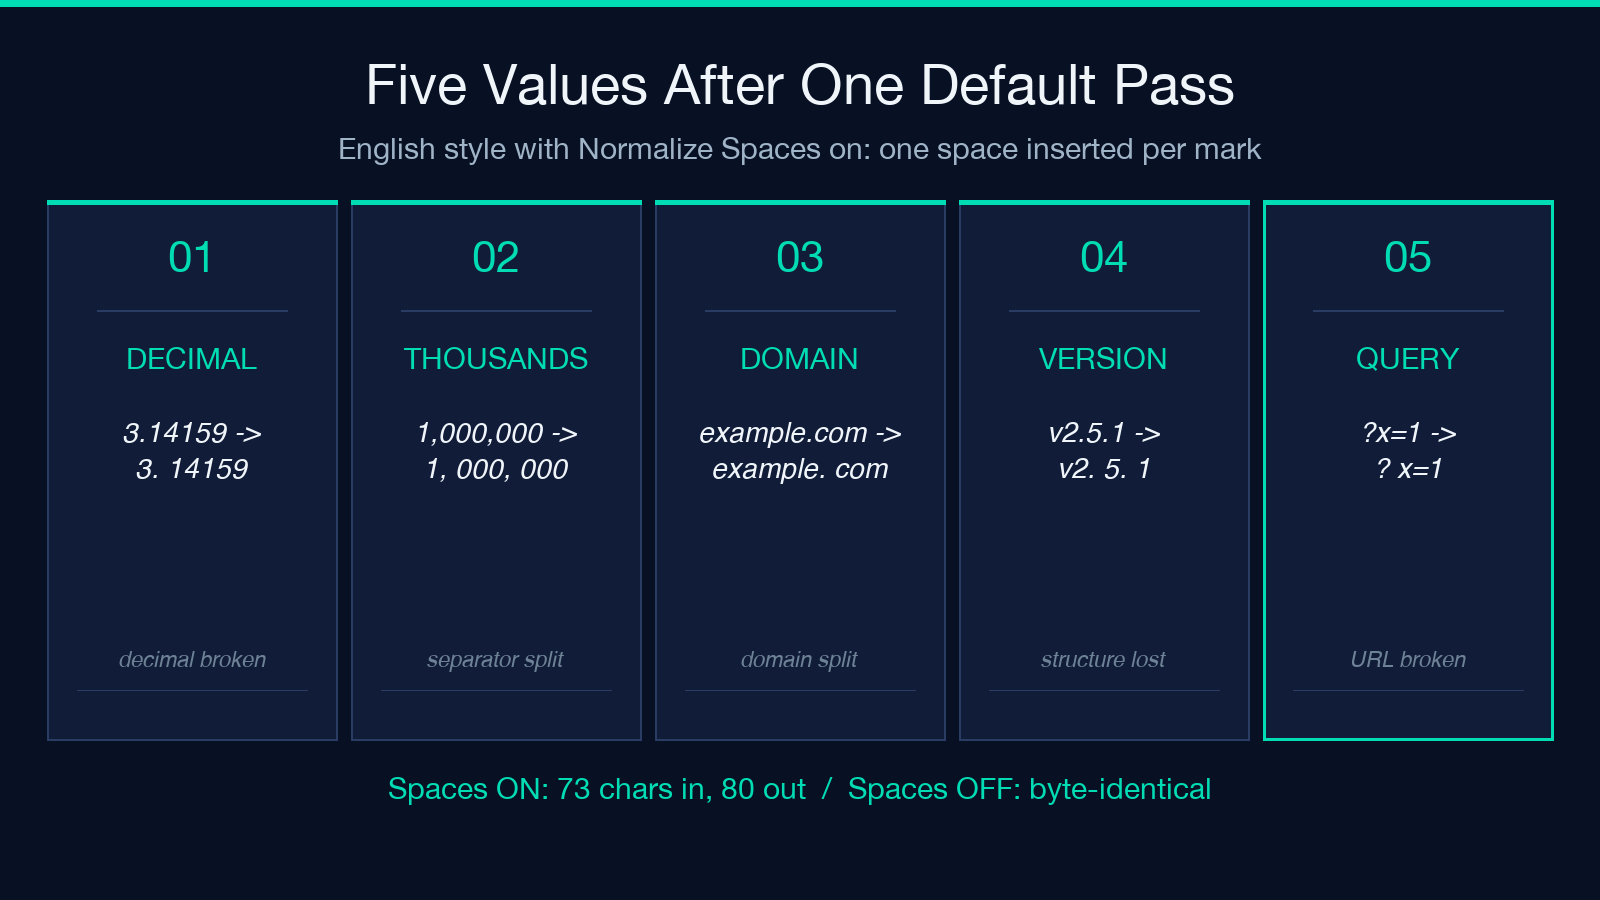
- 小数被撑开:3.14159 变成 3. 14159。
- 千分位被拆散:1,000,000 变成 1, 000, 000。
- 域名断裂:example.com?x=1 变成 example. com? x=1。
- 版本号碎裂:v2.5.1 变成 v2. 5. 1。
输入 73 个字符,输出 80 个。有一次我关掉空格开关跑同一句话,返回的结果逐字节相同,报告零处变更。这个对照把损坏锁定在开关本身。
值得记住的陷阱在这里。结果仍然读起来像英文,肉眼扫过去不会警觉。小数点变成句读,分隔符变成列表,域名变成两个词。没有任何地方报错,一万条产品记录之后,价格列已经变成了散文。
中文风格不是混排语料的标点设置
同一段源文本改用中文风格、关掉空格开关,我观察到另一种失败。像 2026-11-21 这样的日期变成 2026——11——21。像 5 * 3 < 10 这样的比较变成 5 ※ 3 《 10。$5.00 的价格变成 $5。00,被一个全角句号掐断。-42 这样的负数变成 ——42。
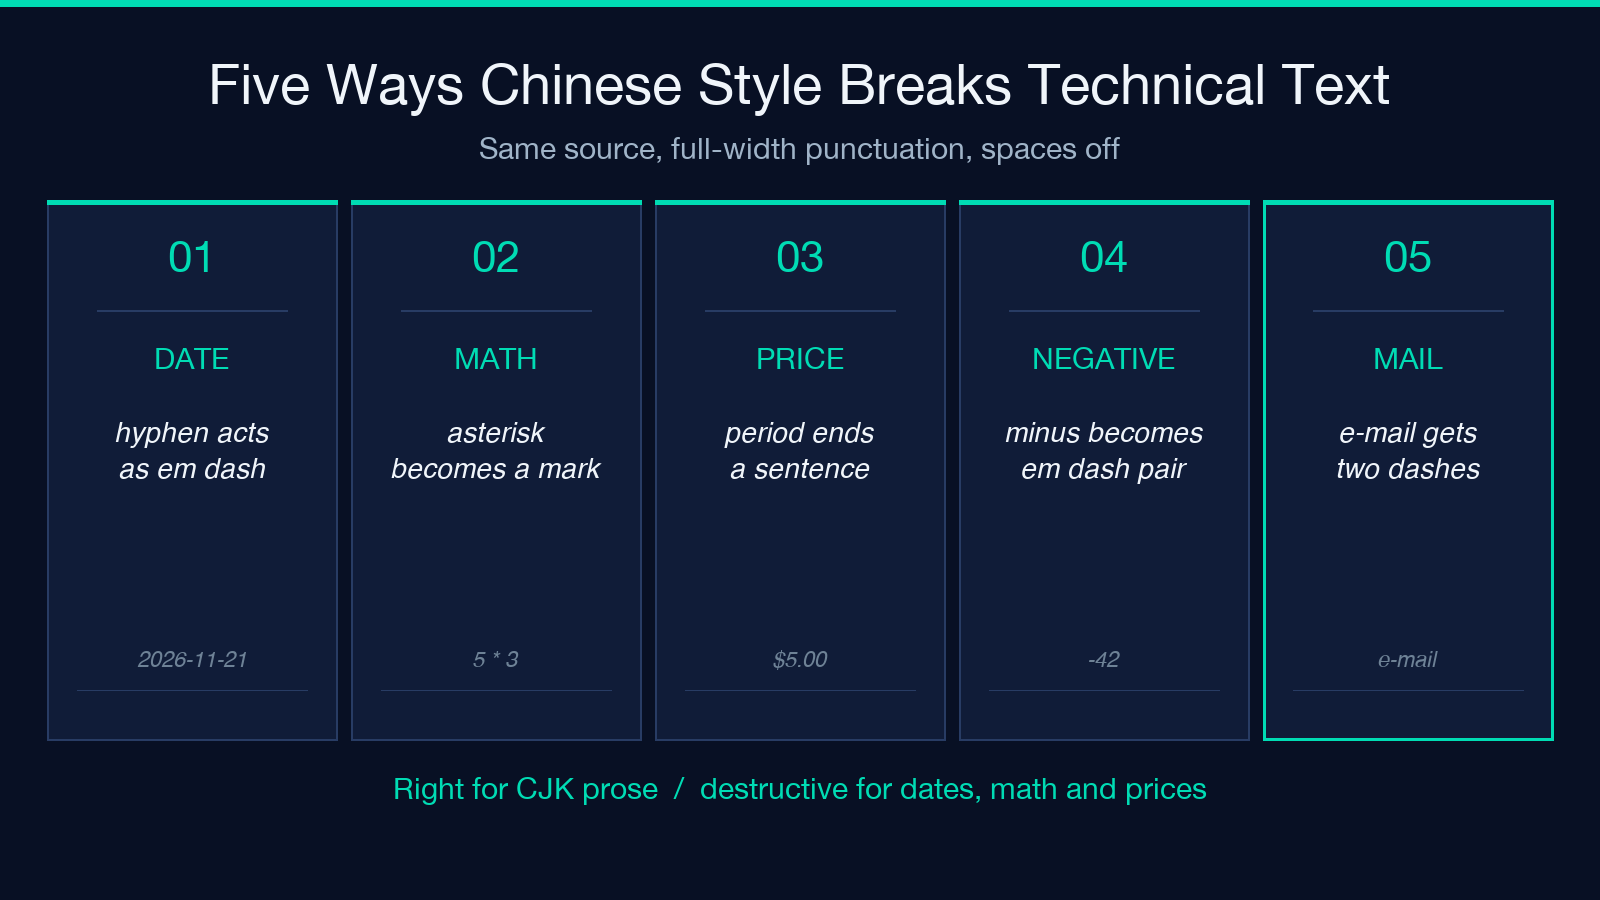
对一份中文文档来说,这些结果没有一个是错的,全角标点本来就该出现在那里。可一旦同一个缓冲区里还装着日期、表达式或价格(几乎总是如此),它们就错了。这个模式对散文是排版选择,对同一缓冲区里的其他一切是隐患。
混合模式是唯一会放过正确文本的模式
标着「智能混合(自动识别)」的那个模式名副其实。它先按句子终止符切分输入,ASCII 的三个和 CJK 的三个都算,然后逐段检测有没有 CJK 表意文字,按段套用对应的表。
我喂了一行中英混排、关掉空格开关的文本:一个中文小句,后面跟一个含美元金额的英文小句。它原样返回,零处变更。这是正确答案,也是这里唯一能给出这个答案的模式。
局限在切分上。只有句子终止符会切开文本,所以一句以中文为主的句子里,英文片段内部的 ASCII 逗号照样被转成全角。丢弃空片段的过滤器同时也丢弃纯空白片段,于是一对被一个空格隔开的标点会贴合到一起,空格消失。
这一遍清洗对换行和 Markdown 做了什么
换行规范化是第二个开关,分三步走。Windows 换行和单独的回车变成普通换行符;连续三个以上的换行折叠成两个;然后每一行做右去空格。
前两步正是你要的。第三步悄悄弄坏了 Markdown,因为行尾两个空格是硬换行的语法。把一段以双空格结尾的文本喂进去,它把空格削干净还给你,渲染时整段重新流成一个段落。制表符也会并成一个空格,不换行空格则原样保留。最后这个缺口,会让你在一次看似干净的清理之后仍然在 diff 里看到残留。
变更计数器报的数字不是变更次数
「changes」下面打印的那个数字,是整份输出里最容易误导人的部分,原因在四行逻辑。计数器按索引同时走过两个字符串,一个字符对一个字符地比。
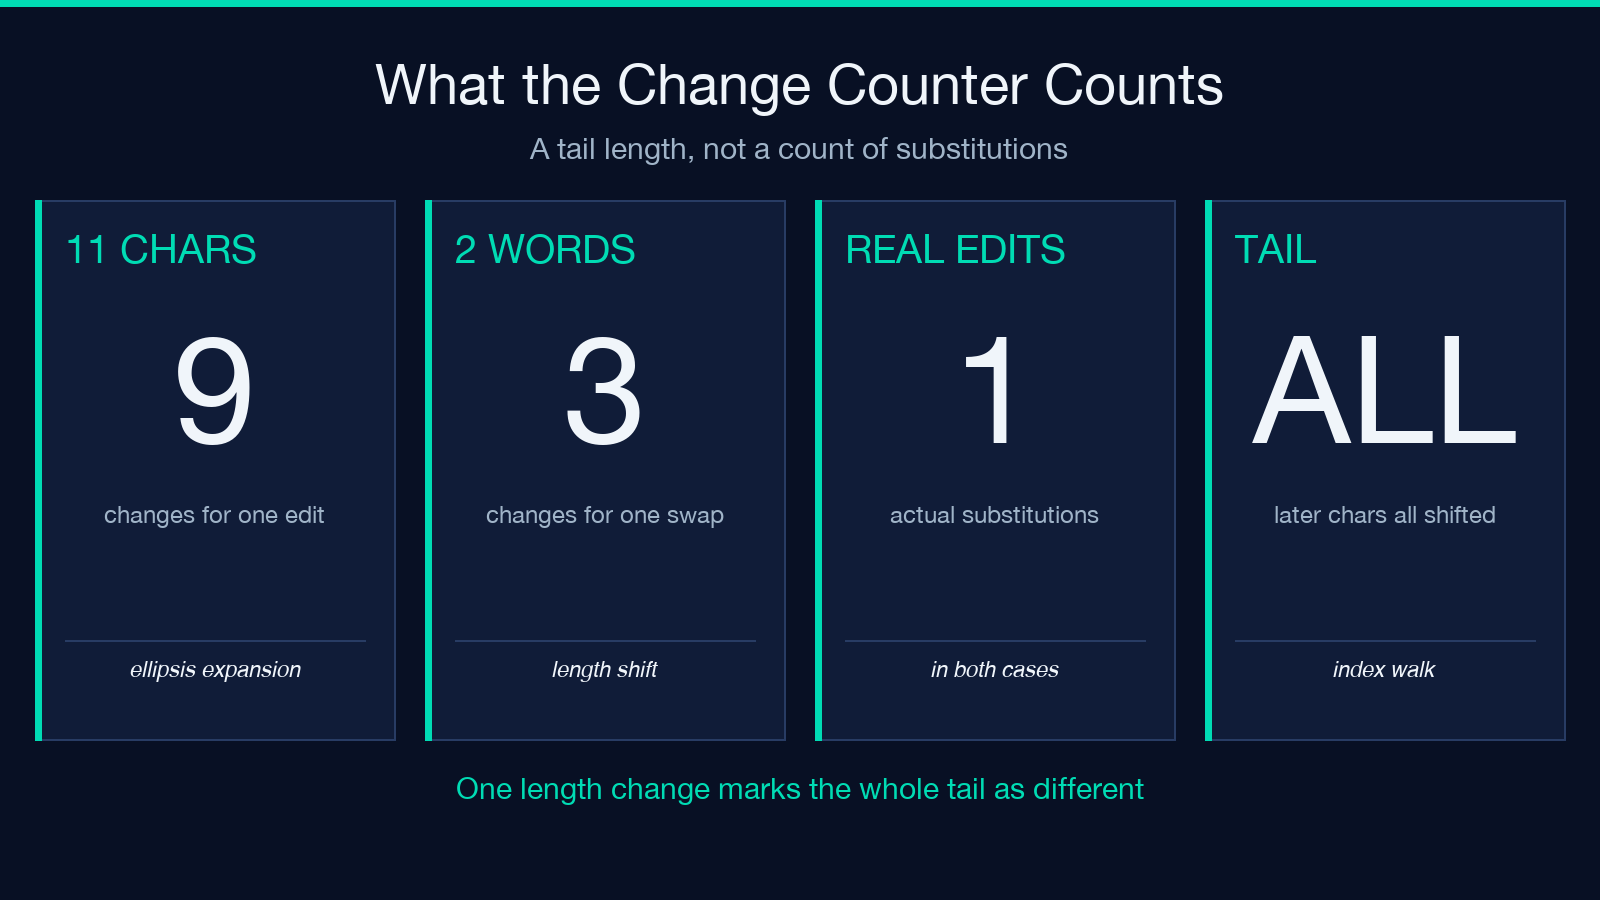
编辑不改变长度时,这没问题。一旦某次替换改变了长度,它之后每个字符都被记为不同。一次省略号展开作用在十一个字符的字符串上,一次替换报了九处变更;两个词的输入报了三处。这两个数字对字符串本身都没说错,因为两个字符串在这些位置上确实不同。可它们都不是替换次数,当成替换次数来读,会让一次两百条记录的清理看起来像一场灾难。
做这几件事的顺序
一份简短的清单,来自上面的测量。
- 正式跑语料之前,先拿十行有代表性的文本过一遍工具,比对数字,别只比对字词。
- 凡是含数字、版本号、地址或价格的文本,把空格规范化关掉。中文散文才打开它,全角间距正是那里的重点。
- 自定义替换只做一遍,因为它们按列出顺序依次生效、层层叠加。第一条把 A 改写成 B,第二条把 B 改写成 C,最终 A 就变成了 C。
- 替换目标里含等号时会在第一个分隔符处截断,一条三段式规则只会改写第一段,其余全丢。
- 缓冲区里有不止一种语言时,优先用混合模式而不是强制某种风格;缓冲区本身是数据文件时,干脆跳过规范化。
这款工具值得留在清洗流水线里,因为它的映射表确实能为带引号、带括号的文本省下编辑时间。稳妥的做法是在第一次运行之前就读清两个开关,而不是在第一次糟糕的 diff 之后。标点符号规范化器,前后比对数字个数,大约三十秒。更多文本工具在 elysiatools.com。
两年前我会说标点规范化是个已经解决的问题:一张字符对表,一个按钮,不需要判断。我现在不这么想了。规范化器改动的那些字形,正是把数字连在一起的那些字形;决定你的文本能不能活下来的,是语言标签旁边那个小复选框,标着语言的那一项并不管这件事,而那个复选框出厂就是开着的。下一次清理之前,与其问自己想要哪种风格,不如问你的输出还能不能四舍五入回同一个数。

Pingback: The Punctuation Pass That Turns 3.14 Into 3. 14 - COSESAI