
两个字母进,一个字母出。用 A1Z26 编码 AB,分隔符选「无」,得到 12。再解码,得到 L,悄无声息,没有任何提示。本应十一个字符的地方只剩一个,整个词就没了。这是 bug 吗?不是。这是网上最简单的密码法出厂自带的默认设置。改一个开关,同一套密码法就能完美往返。
映射一行就能写完
A1Z26 给每个拉丁字母指定它在字母表里的序号:A=1、B=2、C=3,一直到 Z=26。编码器遍历字符串,读出每个码点,大写减 64,小写减 96。两个分支,三十个字符的逻辑。没有密钥,没有要随程序发出去的码表,收发双方也不需要事先约定任何东西。
有意思的地方不在映射,而在编码器怎么处理那些不是字母的东西。
编码 Hello, World!,工具返回 8-5-12-12-15-23-15-18-12-4,并报告跳过了 3 个字符。十三个输入字符变成十个数字。逗号、空格和感叹号被丢掉了:数过,但没带走。
那个跳过计数器是这些字符存在过的唯一证据。编码 A1 得到 1,跳过 1 个;编码 A 也得到 1,跳过 0 个。输出一样,输入不同,把它们区分开的只有一个元数据字段里的整数。如果你只记录数字、丢掉计数器,这个差别就消失了。
大小写下拉框不改变任何结果
工作台提供三种大小写模式:全大写、全小写、保留原样。拿 Hello 把三种都试一遍,每次输出都是 8-5-12-12-15。三种模式下的字母和也都是 52。
原因在运算顺序里。编码器先把字符串规范化,再走两个分支:A–Z 减 64,a–z 减 96,两条路落到同一个整数。规范成小写,进的是第二个分支;规范成大写,进的是第一个分支;preserve 跳过规范化,哪个分支匹配就走哪个。三条路,一个终点。
解码完全不看这个设置,输出永远是全大写。
这件事比看上去重要。一个看起来要你做决定、实际不做任何决定的控件,会让用户连界面的其余部分一起不信任。如果你要做这个工具的变体,不要在编码路径上加大小写开关。它没有语义,只会引出一个合理却错误的假设:a1z26 和 A1Z26 之间有什么不同。
sep: none 是唯一不可逆的选择
分隔符下拉框里有四个选项:连字符、空格、逗号、无。前三个只是定界,第四个是销毁。
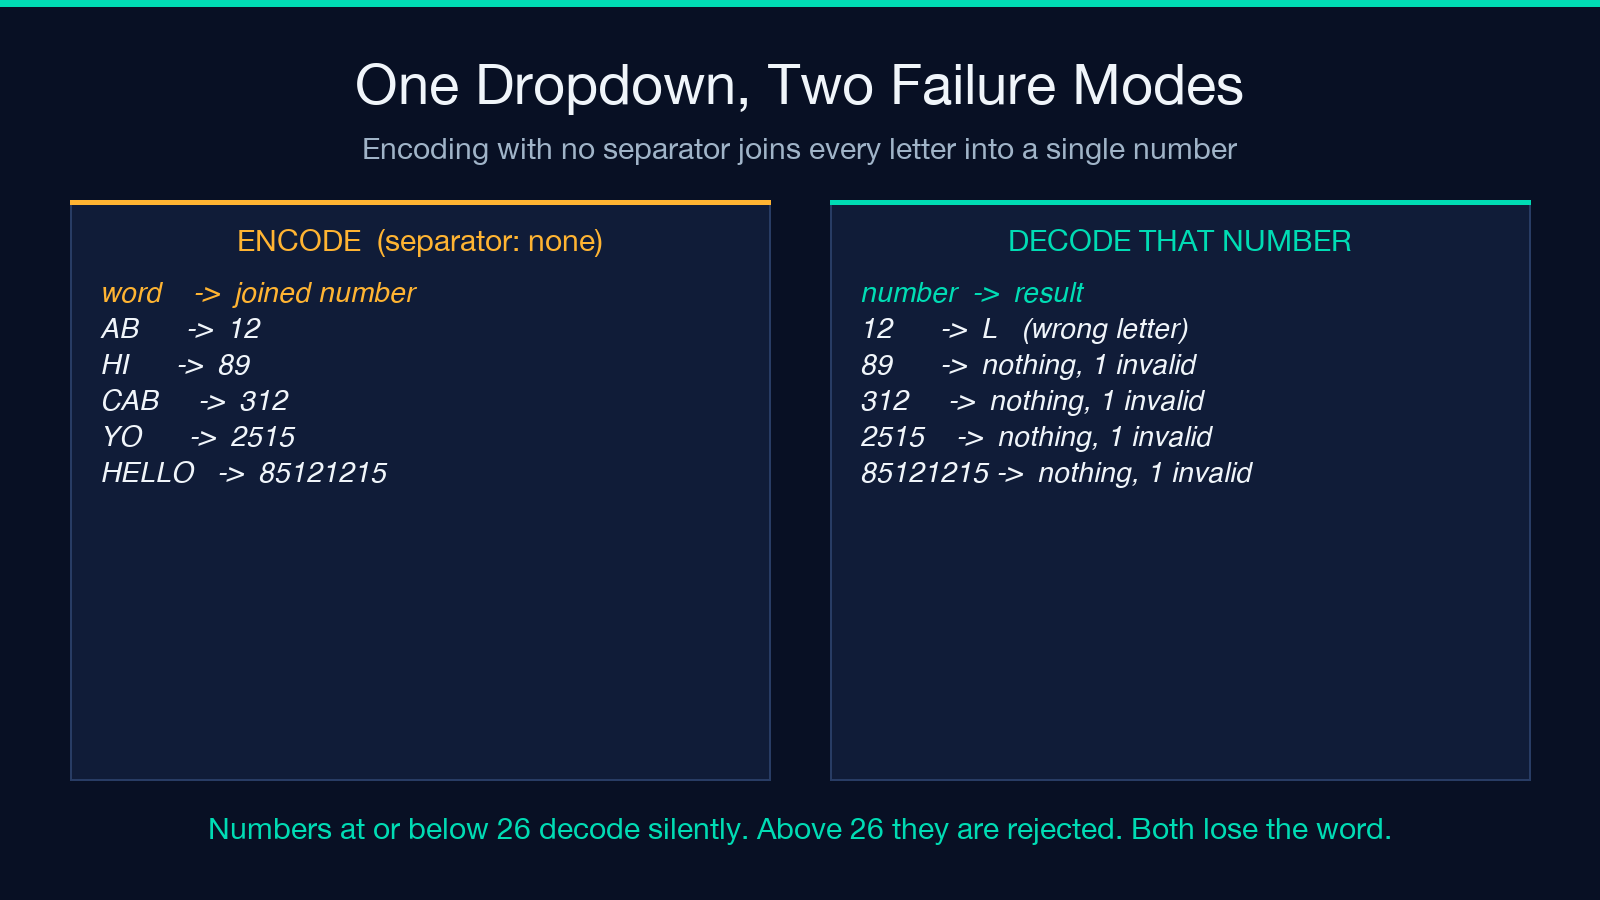
解码时,输入会按任意一段非数字字符切分。有连字符时,8-5-12-12-15 变成五个 token,解出 HELLO。分隔符选「无」,同一条消息只剩一个 token,也就是数字 85121215,它过不了 1 到 26 的范围检查,被计入无效。字母没了。
短词坏得更彻底,因为它坏得悄无声息:
AB编码成12,解码成L。少了一个字母,零个警告。HI编码成89,什么也解不出来,报告一个无效 token。CAB编码成312,超出范围,拒绝。YO编码成2515,超出范围,拒绝。
所以存在两种完全不同的失败,其中只有一种会自己吭声。合并后不超过 26 的数字会解出一个说得通的字母:错的,却底气十足,和正确答案看不出区别。超过 26 的合并数字会被拒绝,至少还告诉你出了事。看起来安全的那些输出才是危险的。
分隔符不是输出上的装饰。它是让消息变得可读的定界本身。你可以到 A1Z26 字母数字工作台 自己跑一遍往返。
解码比编码宽松,宽松在三处
解码器用两条规则校验每个 token:只能由数字组成,数值必须落在 1 到 26 之间。它从不检查 token 的长度。由此有三个后果。
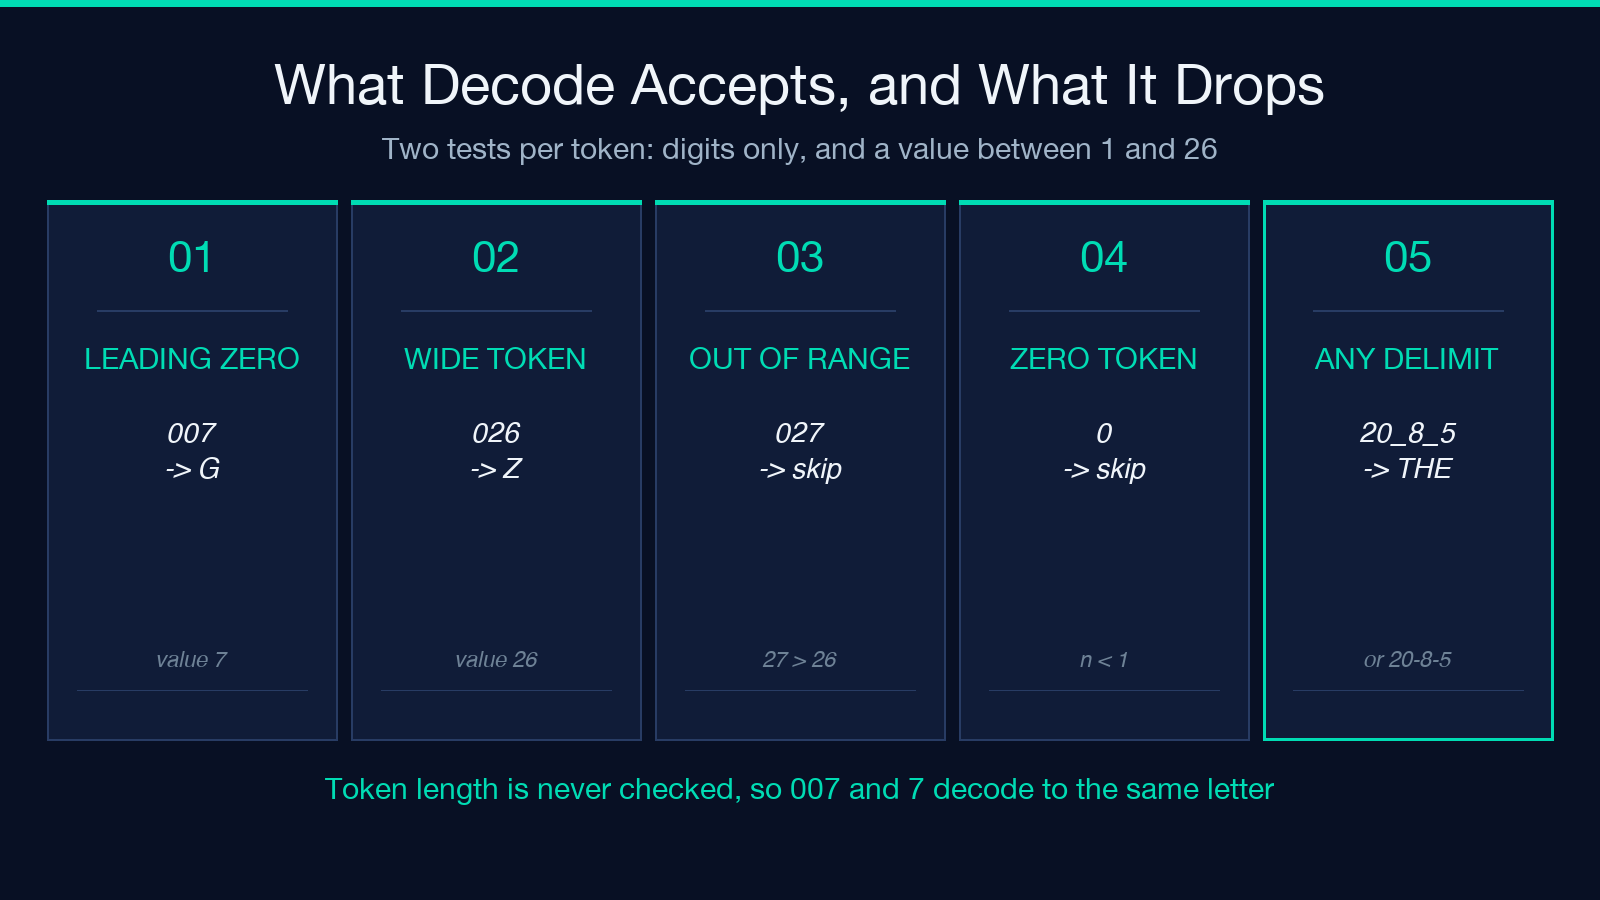
- 前导零被接受。
007解出G,00008解出H。 026解出Z:值对,宽度不对。027被拒绝,因为不管怎么排版,27 都超出范围。- 任何非数字串都算分隔符。
20-8-5、20 8 5、20,8,5、[20][8][5]、20_8_5都能解出THE。
第二点对排查问题最有用。007 和 7 解码结果完全一样,这意味着解码无法反推回你最初的 token 字符串。如果你的流水线把解出的文本重新编码、再和原始 token 比对,那么输入本来就没错,它也会报不一致。
第三点解释了为什么从表格列或聊天记录里粘来的文本通常能用。解码器对分隔符本来就宽容,括号、短横、下划线,它都当成同一个东西。
能否往返,取决于设置,不取决于这套密码法
说得直白些:用连字符、空格或逗号时,先 encode 再 decode 能拿回原来的字母,前提是原文只有字母。选 none,就拿不回来。
这是一处如实说明的缺口,不是缺陷。编码器没有给标点留直通通道:非字母只会让计数器加一,然后被丢掉,所以换任何分隔符都补不回这部分损失。在拿它搭东西之前,这一点值得先说明。
字母和回答的是另一个问题
第三种模式完全跳过编码,直接把字母值加起来。ABC 是 6,Z 是 26,AZ 是 27,ZA 也一样。Hello, World! 在十个被计入的字母上是 124。
这个总和忽略非字母、忽略顺序、忽略大小写:Hello 在三种大小写模式下都返回 52。合起来意味着它是一个多对一的映射,一大族不同的字符串会压到同一个总和上。AZ、ZA、BY、YB 都落在 27。
所以总和永远无法确认一个字符串,它只能否掉一个。只有对不上才说明问题。如果一道谜题说某句话的和是 124,而你的候选是 118,你确实知道了点东西;如果你的候选正好是 124,你几乎什么也没知道。
它该用在哪,不该用在哪
A1Z26 是个热身。它会出现在解谜活动的第一关、ARG 的线索碎片、课堂上的替换密码练习,也会作为字母值类工具(gematria 那一类)背后的算术。
它不是加密。二十六个符号,没有密钥,没有混淆层,频次分布拿一段英文手算就能读出来。任何用到它的地方,都只能当作混淆,不能当作保护。
它真正展示的,是这一页的主题:一种编码可以看起来像数字系统,同时仍然是一套带定界规则的格式。摩尔斯电码有它的间隔,Base64 有它的填充,A1Z26 有它的分隔符;你把分隔符丢掉的那天,就是把消息切成两半的那天。
信任一次解码之前的四项检查
把这些检查跑一遍,大多数意外都会在你付出消息的代价之前消失。
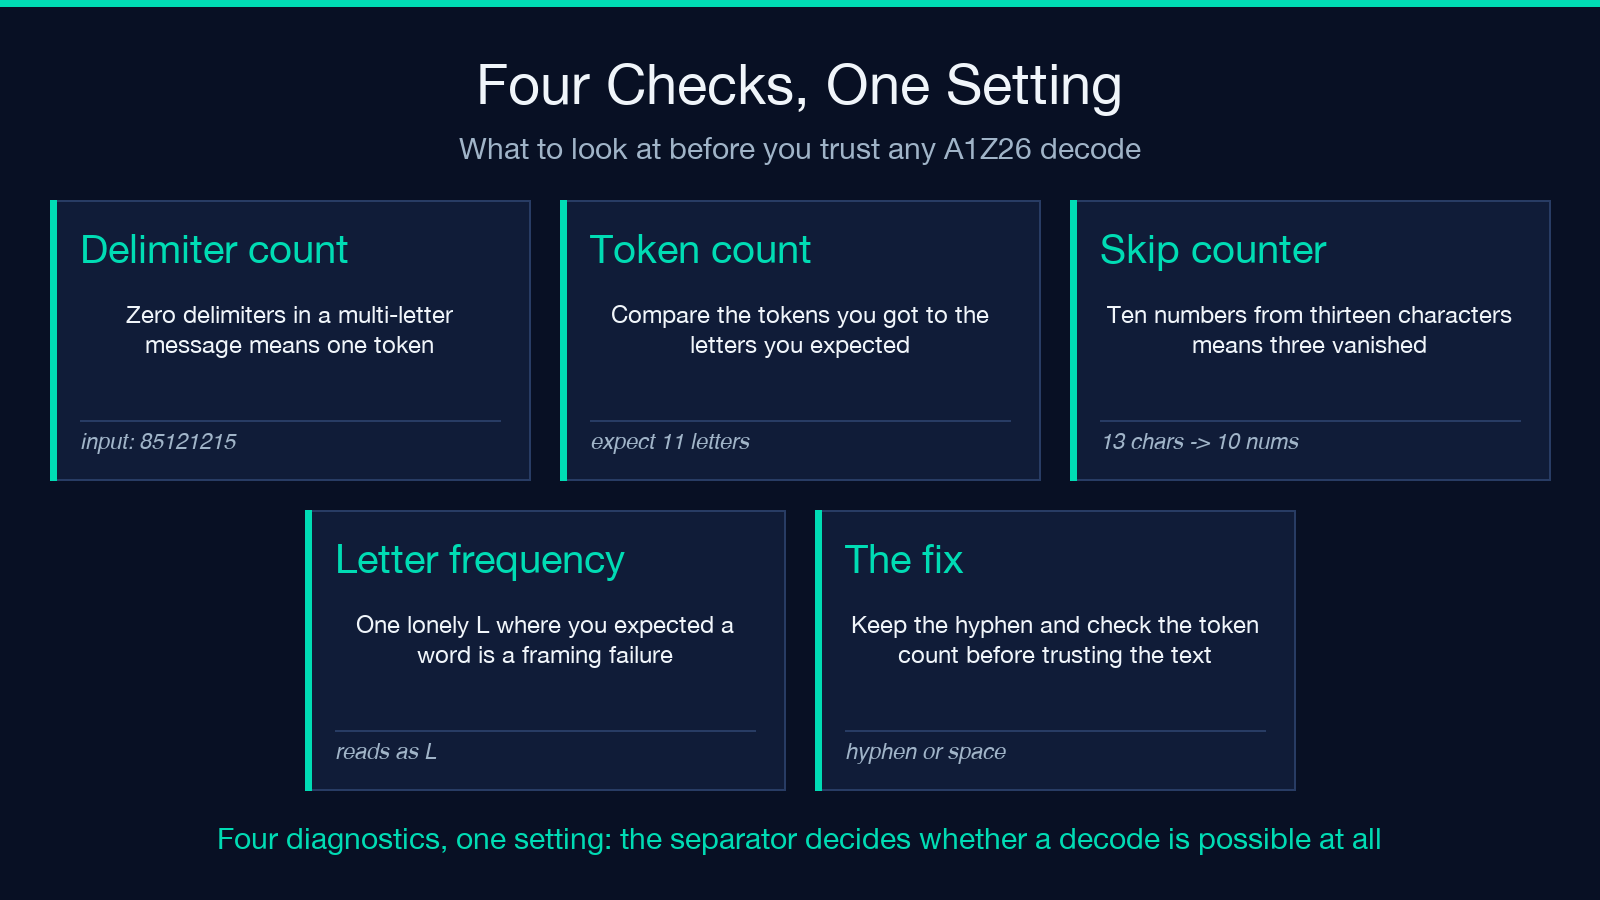
- 数输入里的分隔符。多字母消息里没有任何分隔符,就意味着只有一个 token,而一个 token 最多对应一个字母。
- 把 token 数和预期字母数对一下。本该十一个字母的消息只产出一个 token,它已经失败了。
- 拿跳过计数器和原长度对照。十三个字符得出十个数字,说明三个字符消失了,而且它们不是字母。
- 读解码结果里的字母频次。本该是一个词的地方只解出一个
L,那是定界出了问题,不是密码法出了问题。
工作台会直接报告这四个数字,这也是该用专用页面、而不是草稿本里一段正则的主要理由。解析逻辑只有三行 JavaScript,你真正需要的是这些诊断信息。
想浏览其余工具可以看 elysiatools.com,如果你正在做一条解谜流水线,也可以从 文本处理分类 开始。
很多年里我把 A1Z26 描述成「字母变成数字」,这话没错,也没什么用。修正幅度其实很小:只有在保留分隔符的时候,它才是字母变成数字。丢掉分隔符,AB 和 L 就不再是两个不同的词;保住它们,这套密码法每次都能往返。那么该带走什么?一个字符之差,决定了你手里是密码还是猜测。这一页别的内容都可以不记,请把那个连字符记住。

Pingback: A=1 Is Easy. Decoding It Back Is Not. - COSESAI