
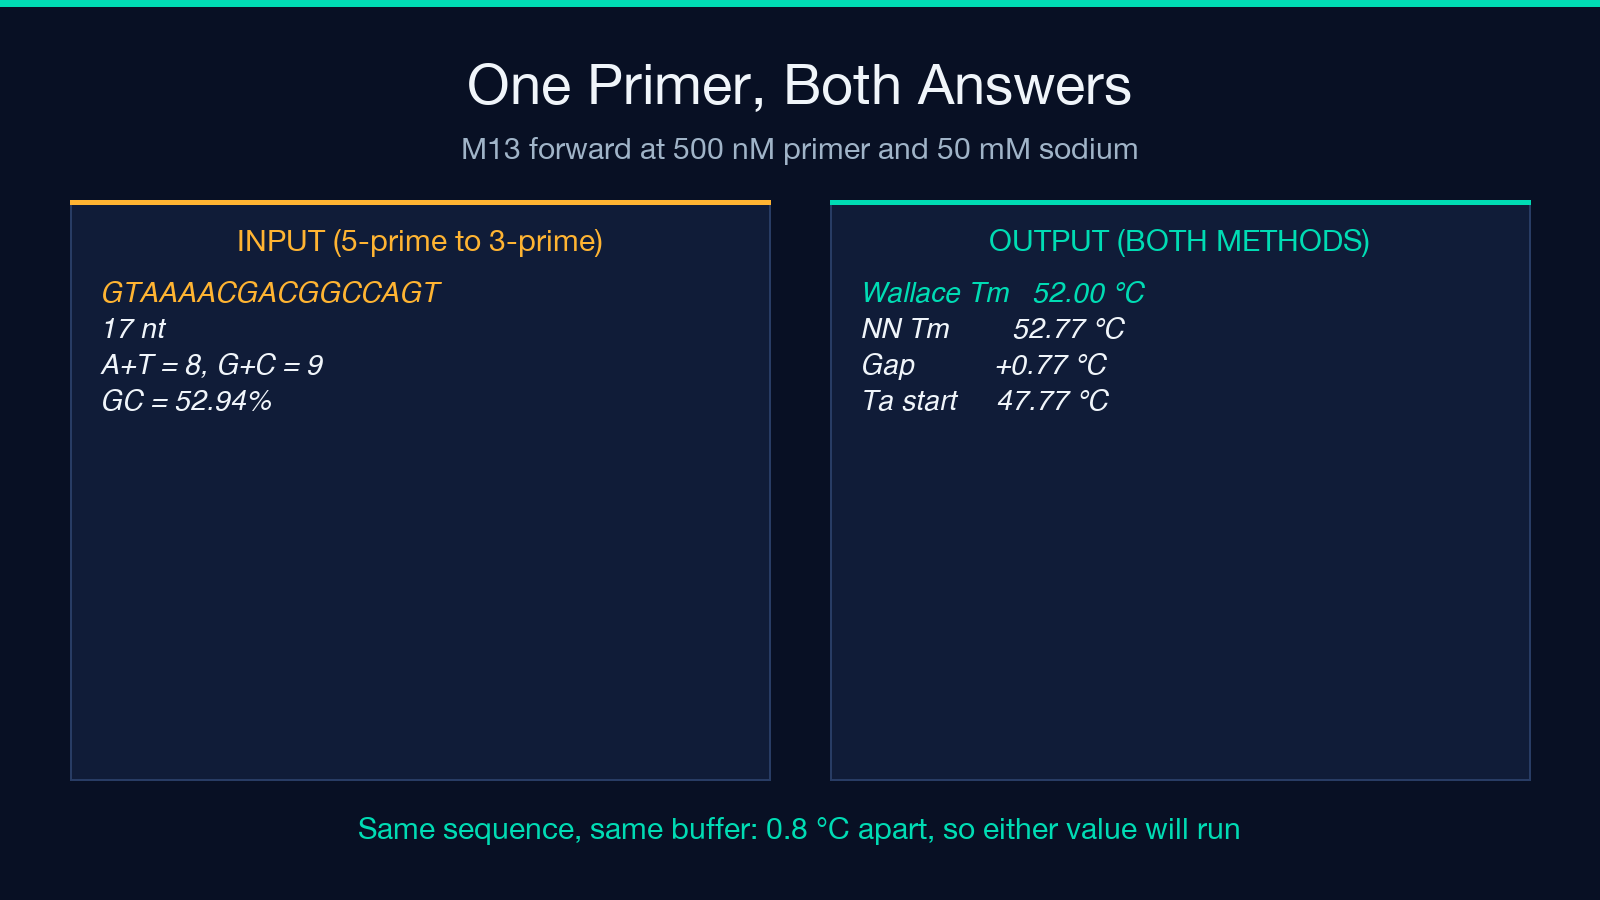
把同一条 17 个核苷酸的引物分别交给两个解链温度(melting temperature,Tm)模型,Wallace 2-4 规则给出 52.0 °C,SantaLucia 最近邻(nearest-neighbor)加和法给出 52.8 °C。序列相同,缓冲液同为 50 mM,两者相差 0.8 °C。换成一条十个碱基的富 GC 寡核苷酸,分歧扩大到 16.6 °C。同一条引物算出两个 Tm 并非缺陷,差距本身就是信号。
2-4 规则数的是碱基字母,不是相邻关系
1979 年的 Wallace 规则只问一件事:这条寡核苷酸里有多少个 A 或 T,多少个 G 或 C。答案就是 Tm = 2 °C × (A + T) + 4 °C × (G + C)。M13 正向引物 GTAAAACGACGGCCAGT 含八个 A 或 T、九个 G 或 C,规则算出 2×8 + 4×9 = 52 °C。整个计算到此为止。
它不知道哪个碱基挨着哪个。十个碱基全是 G 或 C 的寡核苷酸得 40 °C,只有六个的得 32 °C,字母顺序完全不影响结果。
这条规则活了四十五年,是因为它在一个很窄的窗口里大致正确。Primer3 的 oligotm 计算早已默认采用 SantaLucia 1998 模型,2-4 规则主要作为合理性检查留存下来。对 14 到 20 个碱基、盐浓度约 50 mM、引物 0.2 到 1 µM 的场景,它犯的误差往往互相抵消。一旦离开这个窗口,它就不再是粗略估计,而是一个精确到小数点后一位的错误答案。没人会把它挑出来,因为那个数字看起来很合理。
十六个堆积步骤取代两次碱基计数
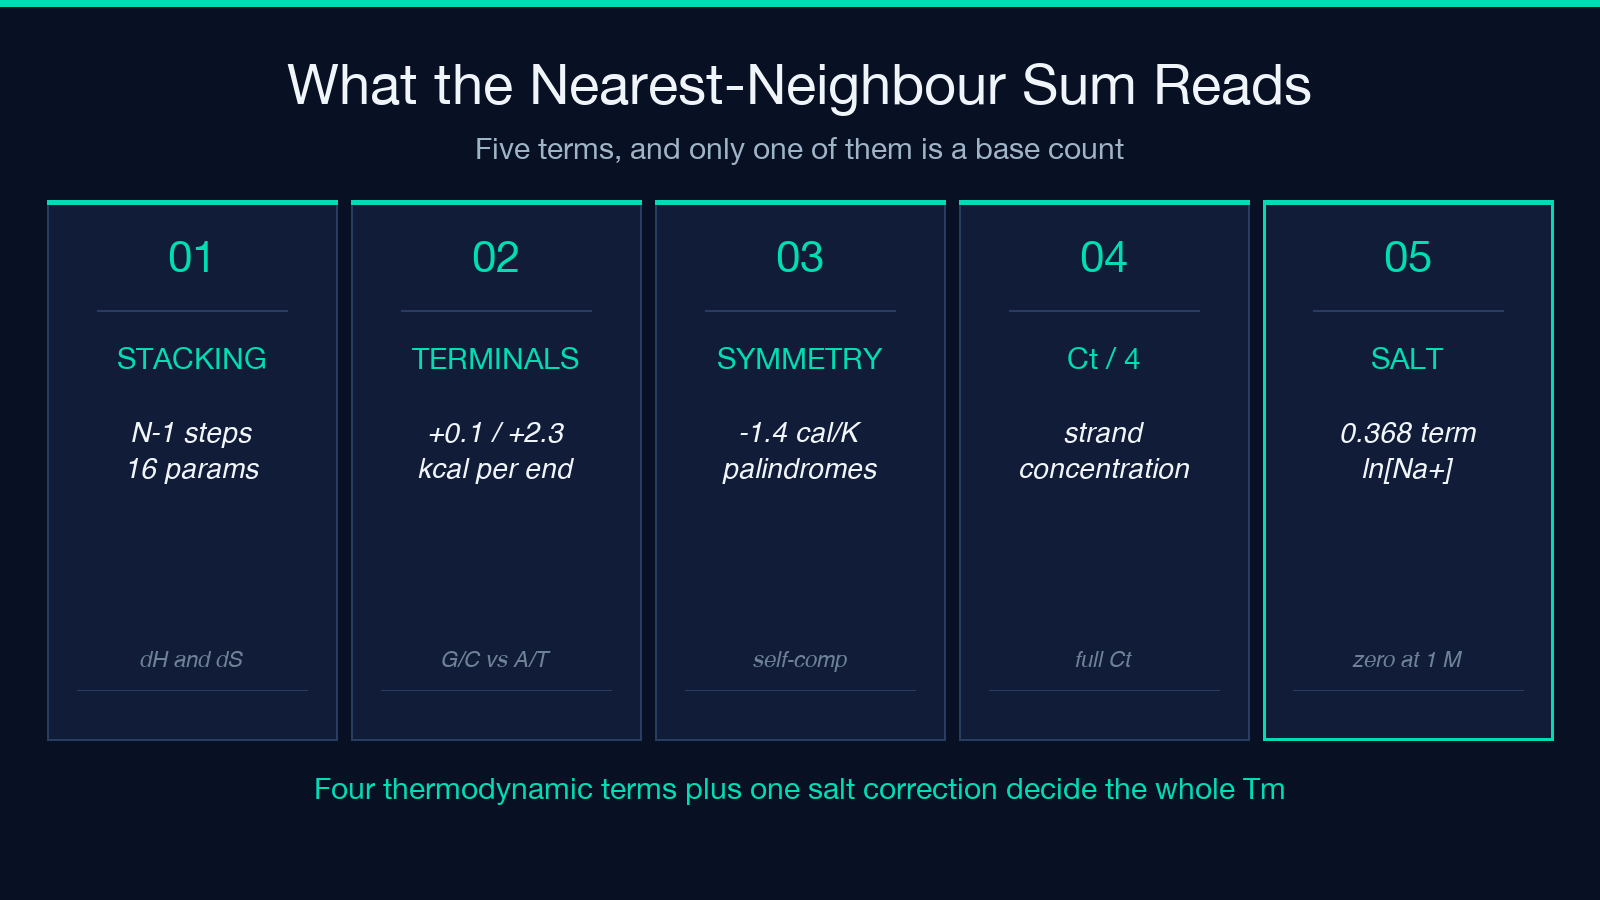
最近邻模型把双链看成由二核苷酸步骤堆成的楼梯,不再是一袋字母。引物里 N−1 个相邻碱基对,每一对都从实测参数表中取出一个焓项和一个熵项,两端的碱基再加一项起始项。把这些加总,你就得到整条螺旋的 ΔH 和 ΔS。
发表版的 SantaLucia 1998 模型写作:
Tm = 1000·ΔH / (ΔS + R·ln(Ct/4) + 0.368·(N−1)·ln[Na+]) − 273.15
R 是气体常数,取 1.987 cal/(mol·K);Ct 是引物链浓度;最后一项是按 SantaLucia 参数集折进 ΔS 的 1996 年盐校正。决定答案的东西全在这两个热力学求和里。
这些实测参数不能互换。一个 CG 步骤的焓是 −10.6 kcal/mol,熵是 −27.2 cal/(mol·K);一个 AT 步骤则是 −7.2 和 −20.4。旋转对称把十六种可能的碱基对压缩成十一组不同的参数,所以发表出来的表总比你预期的 4×4 网格短。
把同一套求和用在刚才那条十碱基富 GC 寡核苷酸上,答案是 56.63 °C,比规则的 40 °C 高出 16.63 °C。分子本身一点没变。模型开始读碱基之间的接缝,不再只数碱基个数。你可以拿任意序列,在 PCR 引物 Tm 计算器(Wallace / 最近邻法)里把两种方法并排跑一遍。
两个末端碱基能把答案挪动 1.5 °C
首尾两个碱基只参与一个堆积步骤,模型因此单独给它们计费。末端是 G 或 C 时贡献 +0.1 kcal/mol 和 −2.8 cal/(mol·K);末端是 A 或 T 时贡献 +2.3 和 +4.1。符号不对称这一点很重要。悬空的 AT 末端比堆叠好的 GC 末端松散,参数表把这层差别写了下来。
我拿碱基组成完全相同的寡核苷酸对做了对照。GAATTCGC 以 G 和 C 结尾,算得 16.59 °C;AATTCGGC 同样八个碱基,以 A 和 C 结尾,算得 17.94 °C。Wallace 规则对两者都报 24.0 °C,因为它根本看不见末端。
第二组结果一致:GCAATTCGC 以 G 和 C 结尾,27.67 °C;AAGCTTCCG 以 A 和 G 结尾,26.12 °C。组成相同,相差 1.55 °C,而 2-4 规则又一次对两者都给出 28.0 °C。
盐浓度和引物浓度是两个一直踩在默认位置的踏板
解链温度在给定的浓度下才有定义,只报一个 Tm 却不交代这两个旋钮,等于只报了半个测量结果。盐浓度能说明缺失的那一半代价有多大。M13 正向引物不变,引物浓度 500 nM,最近邻模型在钠离子 10 mM 时给 45.40 °C,25 mM 时 49.55 °C,50 mM 时 52.77 °C,100 mM 时 56.04 °C,200 mM 时 59.39 °C。五个盐浓度之间摆动了 14 °C,序列一字未改。
引物浓度的影响小一些,但并非为零:盐浓度固定、序列不动,50 nM 时 49.17 °C,1 µM 时 53.86 °C。物理含义落在 Ct/4 这个除数上。形成双链需要两条链彼此找到对方,四分之一这个因子来自链置换平衡,不是随手定的约定。
盐为什么把温度往上推?0.368·(N−1)·ln[Na+] 这一项在分母上,低于 1 M 时对数为负,[Na+] 升高,分母变小,Tm 随之升高。到 1 M 时整项归零。在这个浓度以下,盐校正是 45 °C 退火和 59 °C 退火之间的差别,不是四舍五入级别的细节。
回文序列要丢掉 Ct/4 这个除数
自互补引物就是自己的反向互补序列,模型对这种情况加两项校正。熵求和要算入 −1.4 cal/(mol·K) 的对称校正,有效浓度则从 Ct/4 换成完整的 Ct。
ACGTACGTACGT 是真正的回文序列。在 250 nM、100 mM 钠离子下,两项校正都加上,结果是 42.65 °C。去掉校正、像普通引物那样用 Ct/4,同一序列算得 56.90 °C。误差 14.25 °C,足以让一个信任它的程序崩掉。
这件事在实验台上要紧,因为自互补引物同时也是引物二聚体的候选。对称校正是模型在提醒你,这个分子能和自己的拷贝配对;浓度切换是模型在提醒你,这种配对比普通双链来得更早。两条信号指向同一个实验问题。
六条引物,一张诚实的记分卡
我把六条有代表性的寡核苷酸在 500 nM、50 mM 钠离子下同时跑两种方法,看两个数字有多经常接近。六条里只有一条,两种方法落在 2 °C 以内。
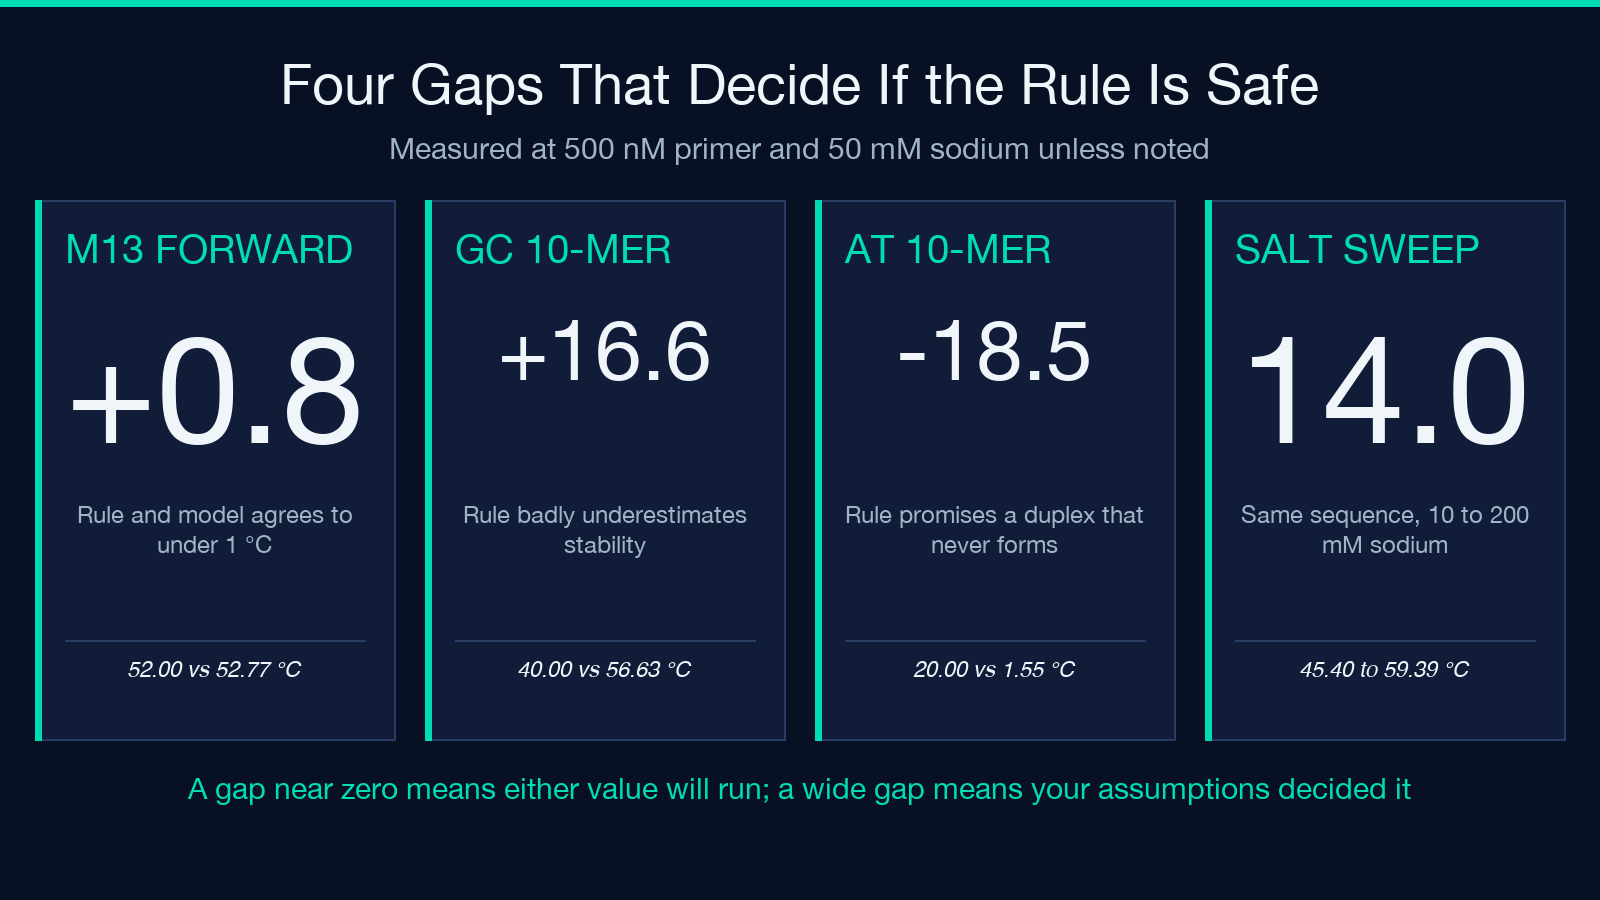
- M13 正向引物,17 nt,GC 52.9%:Wallace 52.00 °C,最近邻 52.77 °C,差距 +0.77 °C。
- 50% GC 的 20-mer:Wallace 60.00 °C,最近邻 55.01 °C,差距 −4.99 °C。
- 50% GC 的 12-mer 回文:Wallace 36.00 °C,最近邻 41.11 °C,差距 +5.11 °C。
- 富 GC 的 10-mer GCGCGCGCGC:Wallace 40.00 °C,最近邻 56.63 °C,差距 +16.63 °C。
- 富 AT 的 10-mer ATATATATAT:Wallace 20.00 °C,最近邻 1.55 °C,差距 −18.45 °C。
- 六碱基 GATTAC:Wallace 16.00 °C,最近邻 −17.19 °C,差距 −33.19 °C。
正负号指出规则往哪边错。差值为正,说明 2-4 规则低估了稳定性,出现在富 GC 和堆积良好的情况,粗糙的规则每个 GC 对只记 4 °C。差值为负,说明规则高估了稳定性,出现在富 AT 和短链的情况,它给一个几乎成不了双链的螺旋每个 AT 对记 2 °C。
富 AT 那一行是我在讨论里最常引用的。规则许诺 20 °C,听起来能用;实测的热力学求和报出 1.55 °C,意味着这条寡核苷酸在你实际会用的任何温度下都没有像样的双链。这两个数字谈不上是同一个量的两次估计,它们是一盏绿灯和一盏红灯。M13 那条结果对得上,不能证明 2-4 规则正确,只能证明 50 mM 盐下的一条 17-mer 恰好落在两个模型的交汇点上。
推荐的退火温度跟着你点的那个方法走
这个陷阱值得点名,因为它藏在一个很整齐的输出里。计算器把两个 Tm 都列出来,规则的系统偏差因此看得见。但推荐退火温度是用所选方法的 Tm 减 5 算的,不是用更准的那个。
拿 250 nM 引物、100 mM 钠离子下的 12-mer 回文做例子。选 Wallace,工具打出 Tm 36.00 °C,推荐 Ta 31.00 °C;同一序列改选最近邻,打出 Tm 42.65 °C,推荐 Ta 37.65 °C。一次点击造成 6.65 °C 的差别,屏幕在两个方向上看起来一样笃定。
两个数字来自同一次输入、同一次运行,所以修的办法在流程上,不在数学上。推荐 Ta 一律从最近邻那个 Tm 往下减;把 Tm − 5 当作梯度 PCR 的起点,不要当成一个固定温度。设计引物对时,让两条引物的最近邻 Tm 彼此相差不超过 2 到 3 °C,因为相差 6 °C 的一对会扩增出一个等位基因、漏掉另一个。
模型拒绝看见的东西
计算器接受 5 到 60 个核苷酸、1 到 10000 nM 引物、1 到 1000 mM 钠离子,这些边界诚实标出了它的适用范围。在这个范围之内,有几种真实效应根本不在算式里。
没有错配项,所以内部一个错配在输出里不付任何代价,实验台上报出的惩罚是 1 到 3 °C,取决于位置。没有二级结构项,发夹或自身二聚体从不出现在数字里。也没有添加物项,DMSO 这类助溶剂每增加一个百分点大约把 Tm 拉低 0.6 °C。没有修饰碱基项,LNA 或 2′-O-甲基残基一律按普通 DNA 计分。
还有一处诚实的缺口在参数集内部。本工具用的是 SantaLucia 1998 统一值,其中 AA/TT 是 −7.9 和 −22.2;若干库采用的 2004 修订版对同一步骤给出 −7.6 和 −21.3。两套数据在多数引物上只差零点几度,远小于你要读的方法间差距;但它意味着,精确到小数点后一位的 Tm 量的是模型加分子,不只是分子。
所以差距是耐用的那个数,绝对值是一次性的。两个模型相差 0.8 °C,说明换个方法答案依然站得住。相差 16 °C,说明答案是你假设的产物,再多的位数也救不回来。
更多工具见 elysiatools.com。
这件事里我想留下的习惯是:先读差距,再读数值。差距接近零,说明两个模型描述的是同一个分子,用哪个值都能跑。差距十六度,说明它们描述的是不同的分子,缓冲液决定你的热循环仪最终能不能建成你设计的那条双链。说到底,手里那条引物,不如它周围的盐重要。你手上哪条引物正悄悄属于第二类?

Pingback: One Primer, Two Melting Points: Why a 16 °C Gap Is the Signal - COSESAI