
Redis 的 RDB 文件不是数据库,是一盘磁带。这个区别决定了你怎么读它。磁带有一个 magic number、一个声明的格式版本、一串只向前走不回头的带类型记录,末尾还有个校验和告诉你这次读取到底有没有落到位。Redis 快照、LevelDB 与 RocksDB 的预写日志、SSTable 页脚、Memcached 线缆报文、BoltDB 页面、LMDB 页面,在这个意义上都是磁带。取证时要问的从来不是存储里装了什么,而是字节流自己声称了什么,以及它自带的完整性校验同不同意。
RDB/SSTable/LevelDB/RocksDB/Memcached 二进制 KV 存储编码谱系解码器在一个浏览器标签页里走过六种存储格式:判断一段十六进制数据究竟是哪一种,展开每个头部与记录字段,校验该格式自带的校验和;再粘进第二份快照,它还会报告哪些键新增、消失、值变了或在 TTL 上漂移。
磁带这个比喻:六种格式共有什么
六种格式听起来像六份互不相干的规范。从结构上看,它们是同一个想法换了六套衣服。
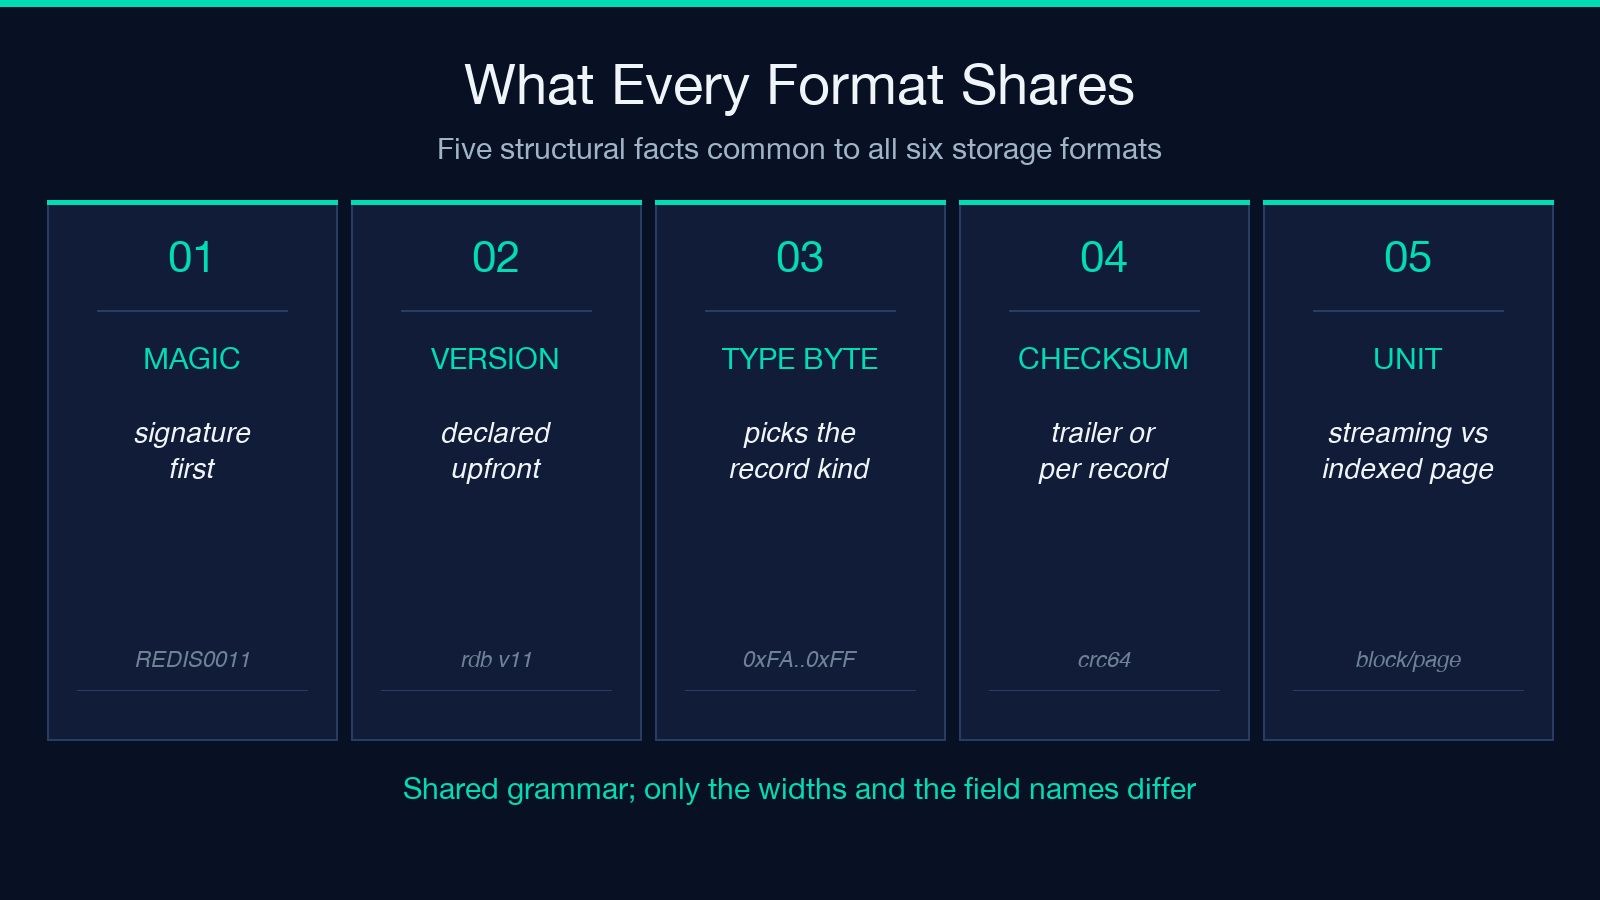
每一种都以 magic 签名开头,读到的字节不是预期的,读取程序就可以拒绝继续。Redis 在每个 RDB 文件开头写下九个 ASCII 字节 REDIS0011,末尾几位数字是格式版本。LevelDB 的日志给每条记录加 7 字节头部,第一个字节承载记录类型。Memcached 的二进制协议用首字节的最高位标记响应,也就是 0x80。
每一种都会在载荷之前声明后面跟的是哪种记录。RDB 用一个字节选择 string、list、set、hash、zset 或某个辅助 opcode。LevelDB 日志里,这个字节取 1 表示完整记录,2 表示首片段,3 表示中间片段,4 表示跨块拆分的同一条逻辑记录的最后一段。
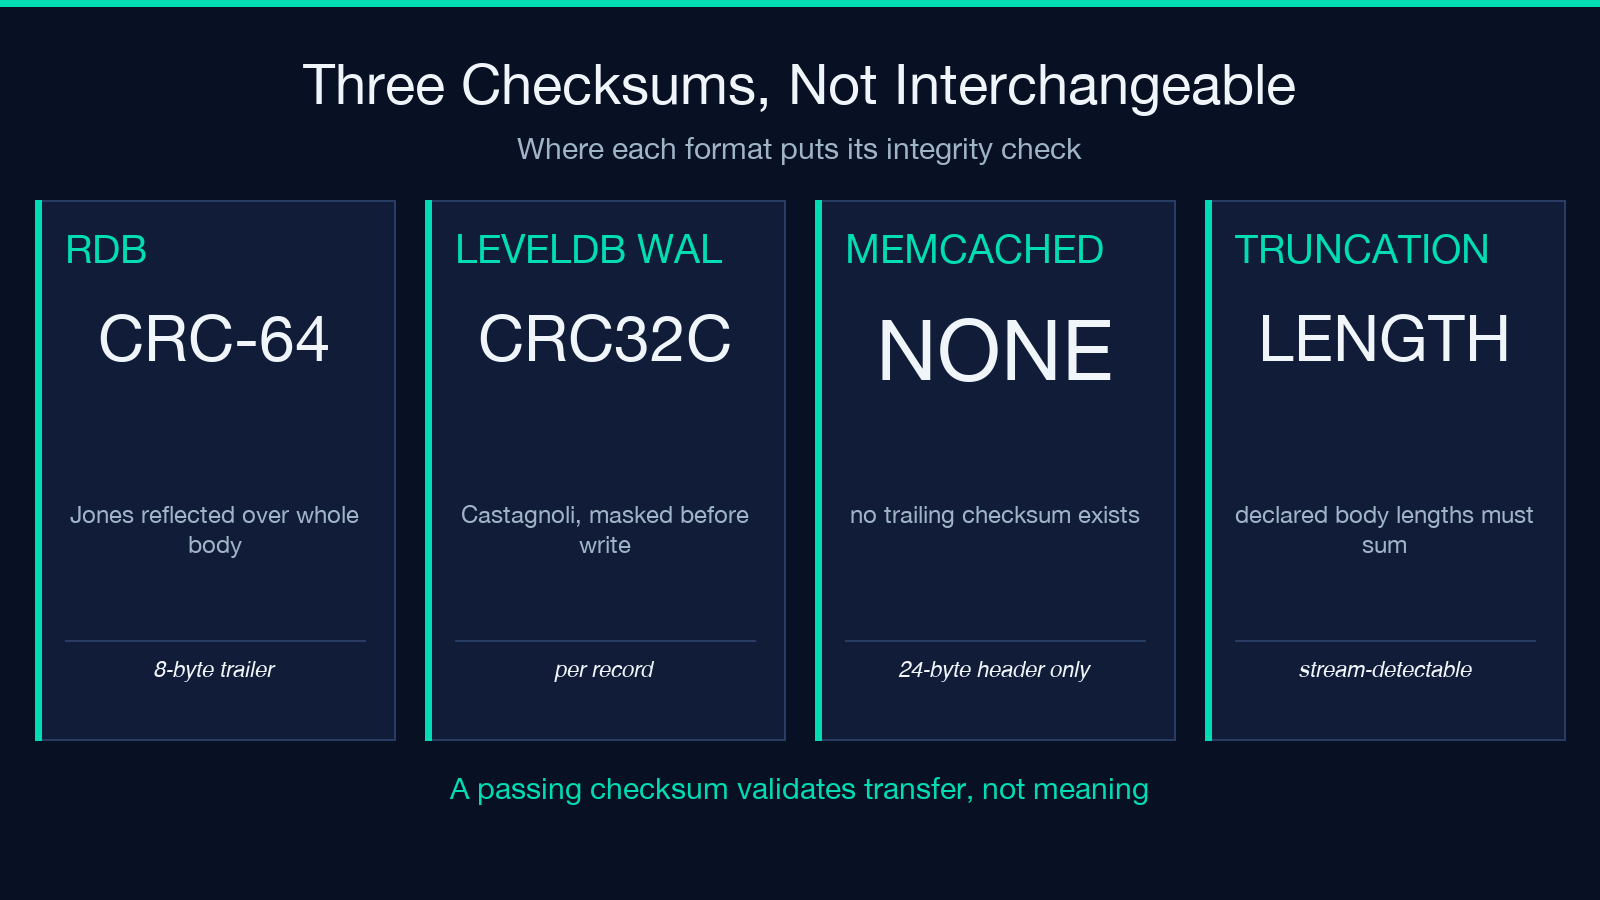
每一种都以一次完整性校验收尾,校验对象是已经读到的内容。RDB 用 CRC-64(Jones 多项式,反射实现)。LevelDB 的逐记录 CRC32C 在写入前先做掩码。Memcached 根本没有尾部校验和,这本身就是一个发现。
把这族格式当谱系看,而不是当清单看。流式、索引、分页这三条轴决定了哪个字节回答哪个问题:RDB 与 LevelDB 日志向前流式写记录,SSTable 页脚是文件末尾的定宽索引,数据块排在它前面;BoltDB 与 LMDB 页面则是定长的槽式页。
读 RDB 头部与它的 AUX 字段
从家族里最简单的文件入手,因为它教的语法后面几种格式都会复用。
九个 magic 字节承载两个事实。REDIS 是签名,紧跟其后的四位数字是 RDB 版本;测试语料取自 redis-server 7.2.4 的真实 431 字节快照,这里读出的版本是 11。紧接着是 AUX 字段对:一个 opcode 字节 0xFA,后面跟长度前缀的键和值。示例把 redis-ver 解成 7.2.4,把 redis-bits 解成 64。任何调查都先看这两个:一份声称版本 11、却报告 redis-bits: 32 的快照,说明它出自 32 位构建。
RDB 的长度前缀不是定宽的。首字节小于 0x40 时,它本身就是长度。首字节最高两位是 01,表示后面跟 14 位大端长度。最高两位是 10,表示后面跟 32 位长度,取值范围顶端还编码了特殊情形。正因为有这三路分支,“读一个长度字节”的朴素解析器碰到任何含大 value 的快照都会翻车。
AUX 字段结束后,opcode 0xFE 选择数据库索引,0xFB 声明 resizedb 提示。这两个 opcode 标出头部在哪里结束、键空间从哪里开始。
承载数据的那些 opcode
每个键前面都有一个类型字节,这个字节决定了键字符串之后所有内容的布局。
普通字符串用两种常见编码。0xC0 是整数编码的字符串,载荷是 1、2、4 或 8 字节的小端有符号值,具体宽度由编码字节的低位决定;零长度变体就是标准的 null。0xC0 家族里的其他取值都是普通字符串,载荷带长度前缀。在示例里,greeting 走整数编码路径解成 hello world,name 按普通字符串解成 Ada。
容器才是格式有意思的地方。小 hash 用 listpack 编码,一整段连续字节装着所有字段和值,靠反向引用定位;zset 也能这么存。小的整数集合用 intset,一个定宽整数的有序数组,头部带计数。短 list 存成 quicklist,一条由 listpack 节点串起来的链,而不是逐个分配节点。示例里的 hobbies 键从一个 listpack 载荷里解出六个具名字段。
文件被截断或被篡改时,有两个 opcode 值得注意:0xF8 是 64 位的 module aux 字段,0xF7 是 module 载荷,两者都意味着自定义 opcode,需要模块源码才能解释。文件的最后八个字节是 CRC-64 尾部;示例里这个尾部校验通过,这决定了它是“一份 Redis 快照”,还是“这些字节只是以 REDIS 开头”。
先验 CRC-64,再谈相信任何东西
完整性校验是格式知识变成取证信心的地方:校验和覆盖整个主体,因此也验证了你此前解出的每一个字段。
这里出现三种校验和,彼此不能混用。RDB 用反射版 CRC-64(Jones)。LevelDB 与 RocksDB 日志用 CRC32C(Castagnoli),存储前先掩码;这一层掩码的存在,是为了让恢复过程中 CRC 值永远不会被误认成合法的长度字段。Memcached 没有尾部校验和,所以一条被截断的链无法自报截断。
CRC32C 掩码这个细节坑过不少人。你对载荷重算 Castagnoli,结果与存储值不符,差异可能完全来自忘了掩码。恢复日志记录意味着两种值都要查:写入时的掩码值,以及你的库返回的未掩码值,因为库几乎一律返回未掩码形式。
校验和买到的东西很窄,但很实在。CRC-64 干净,说明快照内部自洽。它不说明这就是你要的那份快照,也不说明数据内容正确。它只说明传输途中没有字节被翻转、截断或重排,所以你发现的任何语义异常都出在数据或写入方,不在传输。
校验失败时,解码器依然会报告它能解出的每个字段。这种部分解码常常比硬失败更有用:它标出文件从哪个偏移开始不再可信,此前的部分仍然算证据。
WAL 记录、数据块与 32 KiB 边界
预写日志是这个谱系与快照分道扬镳的地方,读法也因此要改。SSTable 不可变且有序,日志两样都不是。
日志是一连串 32 KiB 的数据块,块边界是硬性的物理约束。装不进剩余空间的记录会被拆开,片段靠类型字节标记,读方据此重组。每条记录带 7 字节头部:一字节长度(超过 256 之后,长度位分高低两段)、两字节日志编号、两字节载荷长度、两字节掩码 CRC32C。头部的长度是包含自身头部与校验和在内的总逻辑长度,载荷长度字段只算载荷;把这两个当一个数读,就是经典的差七错误,整条流从此错位。
日志尾部有一堆垃圾并不意味着损坏。那是崩溃发生在部分写入与完成之间留下的正常残留;现代 LevelDB 与 RocksDB 会在最后一个有效校验和处截断。
SSTable 几乎是镜像。它的页脚是文件末尾的定宽块,含 metaindex 与 index 块的 varint64 BlockHandle 对(偏移与大小)、一个 varint32 metaindex 句柄、填充到 40 字节,然后是 40 字节 magic。数据块内部靠前缀压缩与重启点省空间:每个重启区间以一个共享键偏移为零开头,重启点之间的条目与前一条目共享前缀,所以把每个键都当完整键读的朴素解析器,在多数条目上都会产出垃圾。varint 本身也不自定界,延续标志在最后一个字节上。
Memcached 报文:没有校验和的头部
Memcached 把磁盘格式依赖的安全属性反过来。它没有尾部校验和,24 字节头部就是全部约定。
头部按固定顺序排八个字段:请求或响应 magic、opcode、键长度、extras 长度、数据类型、vbucket 或 status、主体总长度,以及客户端用来匹配响应的 opaque 标识。请求与响应的 magic 只差首字节的最高位,自动检测因此把 0x80 当响应标记。报文其余部分依次是 extras、键、值。
opcode 就是全部词汇表:0x00 get、0x01 set、0x02 add、0x03 replace、0x04 delete、0x05 increment、0x06 decrement、0x07 quit、0x08 flush,外加 stats 一族。extras 长度读错,后面每个字段都会错位,所以解码器必须把声明的 extras 长度当作键起点的权威依据。
工具的第二个示例把五个报文首尾相接贴进来:一个取 “Hello” 的 GET,它命中后返回带 flags 和值 “World” 的响应,一个带 flags 与过期时间 extras 的 ADD,一个报告 1.3.1 的 VERSION 响应,以及一个键不存在的错误。解码器报告五个报文、两个请求、三个响应,第一个键是 Hello。这个示例比 opcode 表更有价值,因为它展示了同一套偏移算术如何在一个无值报文、一个有值报文和一个错误报文上同时成立。
报文链也是这一族里唯一能单凭字节流就看出截断的地方:声明的各段主体长度之和与可用字节数不相等,链就是短的。
两份快照的差异与 TTL 矩阵
差异对比让它从解码器变成工具,它分的五类正好对应调查者真正会问的问题:新增、删除、变更、过期时间变化、未变。
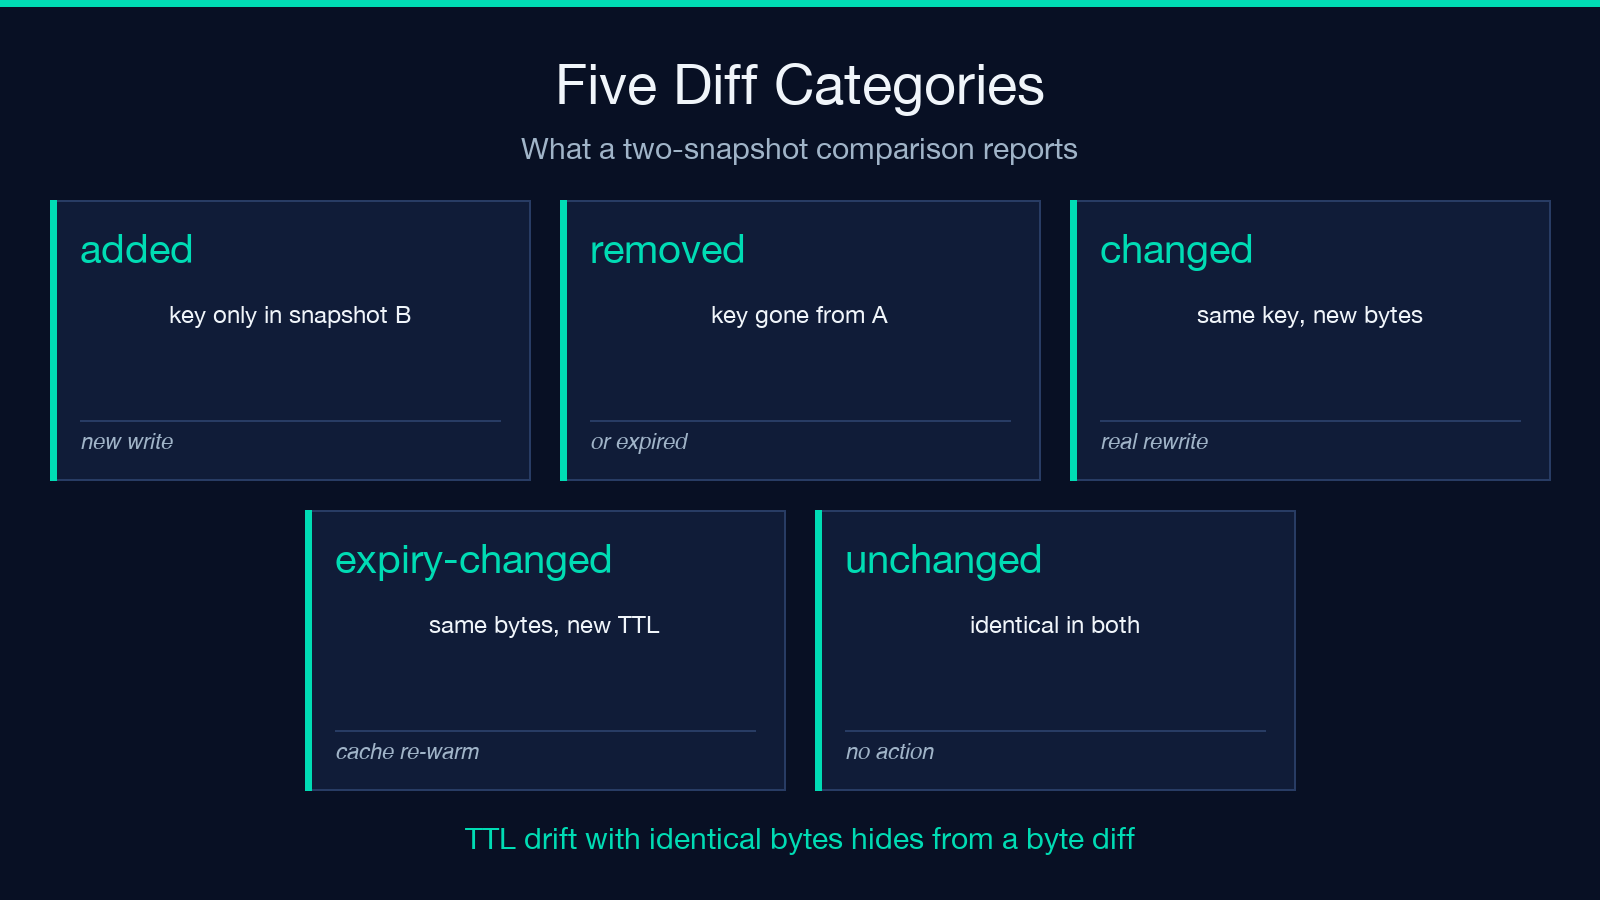
在示例里,改过键之后再取一次 SAVE,结果恰好是一个键新增、一个键删除、一个值变更、一个过期时间漂移、七个未变。翻成白话就是“有人加了一个键、删了一个键、改写了一个值、刷新了一个 TTL”。每一项都单独报数而不合并,这正是重点:字节完全相同、只有 TTL 漂移的情况,对字节级 diff 是隐形的,而这恰好是你否则会漏掉的信号。
这个矩阵需要你给一个输入:参考的 Unix 时间戳。过期时间存成绝对 Unix 秒数,或者在较新的 0xFC opcode 里存成 4 字节小端毫秒数,它取代了更早的 1 字节与 4 字节秒级绝对编码。没有参考时间,你能报告某个键会过期,但分不清它是在你调查的事故之前还是之后过期。给一个时间点,矩阵就变成时间线:已过期、一小时内过期、今天稍晚过期、永不过期。
它也决定了一个“看起来缺失”的键意味着什么。快照 B 里没有的键,要么被删除,要么过期了,两者成因不同。当这个键在 A 中存在、且过期时间落在两次保存之间时,过期矩阵能消掉这个歧义。
把差异当作证据,不要当作意图的 diff。它报告的是字节和时间戳。判定是运维人员而不是定时任务干的,属于另一个需要旁证的推断;不过字节层面的事实现在集中在一处,不用再从两份 hex dump 手工重建。
相信一次解码之前的交付前清单
五项检查决定一份解出的键空间能不能扛住一次调查的分量。按顺序跑,省下的是最贵的那种自信:等别人重读这个文件时,你才发现自己错了的那种。
读字段之前先确认 magic。检测出的格式是解析之前的一个声明。如果不是你预期的格式,停下来查清原因,再花时间看内容。
看完整性结论,把失败当作截断点。CRC-64 或 CRC32C 有效,说明它之前的每个字节都可信。失败则说明从那个偏移起不可信,此前的部分解码仍然能用。
核对那些会让后续偏移整体移动的头部字段。Memcached 报文里是 extras 长度;LevelDB 记录里是两个互相竞争的长度字段;对十六进制输入而言,通常是看你贴的是不是连续十六进制,有没有混进分隔符,半字节数是不是奇数。
把键数与差异类别对平。快照 A 有十个键,差异说新增一个、删除一个,那快照 B 也必须有十个。对不上,说明三个数字里有一个错了,在这里发现更便宜。
把参考时间戳和输出一起写下来。没有用来评估的那个 Unix 秒数,过期结论没有意义。
五项都跑完,解码才算证据。漏掉一项,它就只是一个听着合理的故事,而故事更难被发现有问题。单说完整性这一侧,CRC32 校验和能对你自己的字节算 Castagnoli,这是确认日志头部里某个掩码值有没有挺过往返最快的方式。问题如果是“这个文件里到底有什么”而不是“这个格式是什么意思”,该去 十六进制查看器。要看可读的载荷结构而不是字节流,MessagePack转换器用你能读的格式展示同一套长度前缀与类型标签思路,Protobuf转换器则覆盖与 RDB 整数编码相似的线类型。其余工具在 elysiatools.com/zh/tools浏览。
