
十六进制时间戳是一串字节穿上了数字的外衣。 按书写顺序读,0x5F6B3A2F 解出一个看着像模像样的 1995 年日期;把这四个字节倒过来,得到的却是 2020 年一条真实日志里的时间。几乎每个解错的十六进制时间戳,根子都在这个歧义上,而不是转换代码坏了,所以要修的是一条读法规则,不是一个更强的解析器。
Unix 十六进制时间戳转换器 正是为这一类问题准备的。它接受十六进制秒值、裸 8 位十六进制值、十进制秒、十进制毫秒,或者一个普通日期,一次把同一时刻的所有形式都还给你:UTC 下的 ISO 8601、十进制秒、十进制毫秒,以及两种十六进制输出。
转换器认得的四类输入
工具在转换之前先判断你粘进来的是哪一类,并把判断结果作为输入类型报给你。这个标签很要紧,因为四种类型并不等价。
- 十六进制秒。 可以带前缀,如
0x5F6B3A2F,也可以不带,如5F6B3A2F。两者是同一个 32 位值。 - 十进制秒。 像
1600862767这样的 10 位数字,多数 API 输出的就是这种。 - 十进制毫秒。 像
1600862767000这样的 13 位数字,JavaScript、Java 和多数遥测管道输出的就是这种。 - 日期。 任何可解析的日期字符串;当日志给你的是一条渲染好的时间戳而不是数字时,用它。
文本框旁边是字节序选择器,两个选项:大端(big-endian),标注为「按原样」;小端(little-endian),标注为「反转字节」。默认大端,这对人工输入的值或网络协议承载的值都是正确假设。
如果你的流程以十进制为主、十六进制只是顺带,那就用专门的 时间戳转换器 处理这个方向,不必纠结字节序。
时间戳为什么一开始就是十六进制
Unix 时间戳是一个 32 位无符号整数。写成十六进制正好占八位,也就是四个字节,一个 32 位字。这与这些值实际出现的场合刚好契合。
嵌入式固件把时间戳写进定宽的 struct 字段,设备缓冲区的转储自然就按每个时间戳八位十六进制呈现。网络流量的十六进制转储同理。带预计算常量的 C 头文件把时间写成十六进制字面量。调试器打印的处理器寄存器与内存转储默认也是十六进制。这些场合里,八位是机器自己的字,不是显示上的选择。
由此可知,十六进制时间戳本质上是一片碰巧可以打印出来的字节,而不是你为了好看才转成十六进制的数字。读它,意味着判断这个字段遵循的是几种约定里的哪一种;而位数是成本最低的线索。
先数位数这条规则
解析之前先数位数。位数给出字段宽度,字段宽度给出时间单位。
- 八位十六进制 是 32 位值,也就是秒。十进制范围从
268435456到4294967295,对应合理纪元下的 1978 年到 2106 年。 - 十一位或十二位十六进制 是 5 或 6 字节值,也就是毫秒。十一位十六进制数覆盖的毫秒范围远超 2000 年。
- 十六位十六进制 是 64 位值,通常是微秒或纳秒。
在相信任何解码结果之前,先在脑子里过一遍这个检查。八位数值解出 1978 年,很可能就是对的;八位数值解出 2306 年,更可能是上游某处丢掉一位的毫秒值。
完整示例:解码 0x5F6B3A2F
拿那个标准值来试。0x5F6B3A2F 是八位十六进制,按上面的规则属于 32 位秒。转成十进制是 1600862767,该时刻的 UTC 时间是 2020-09-23T12:06:07.000Z。
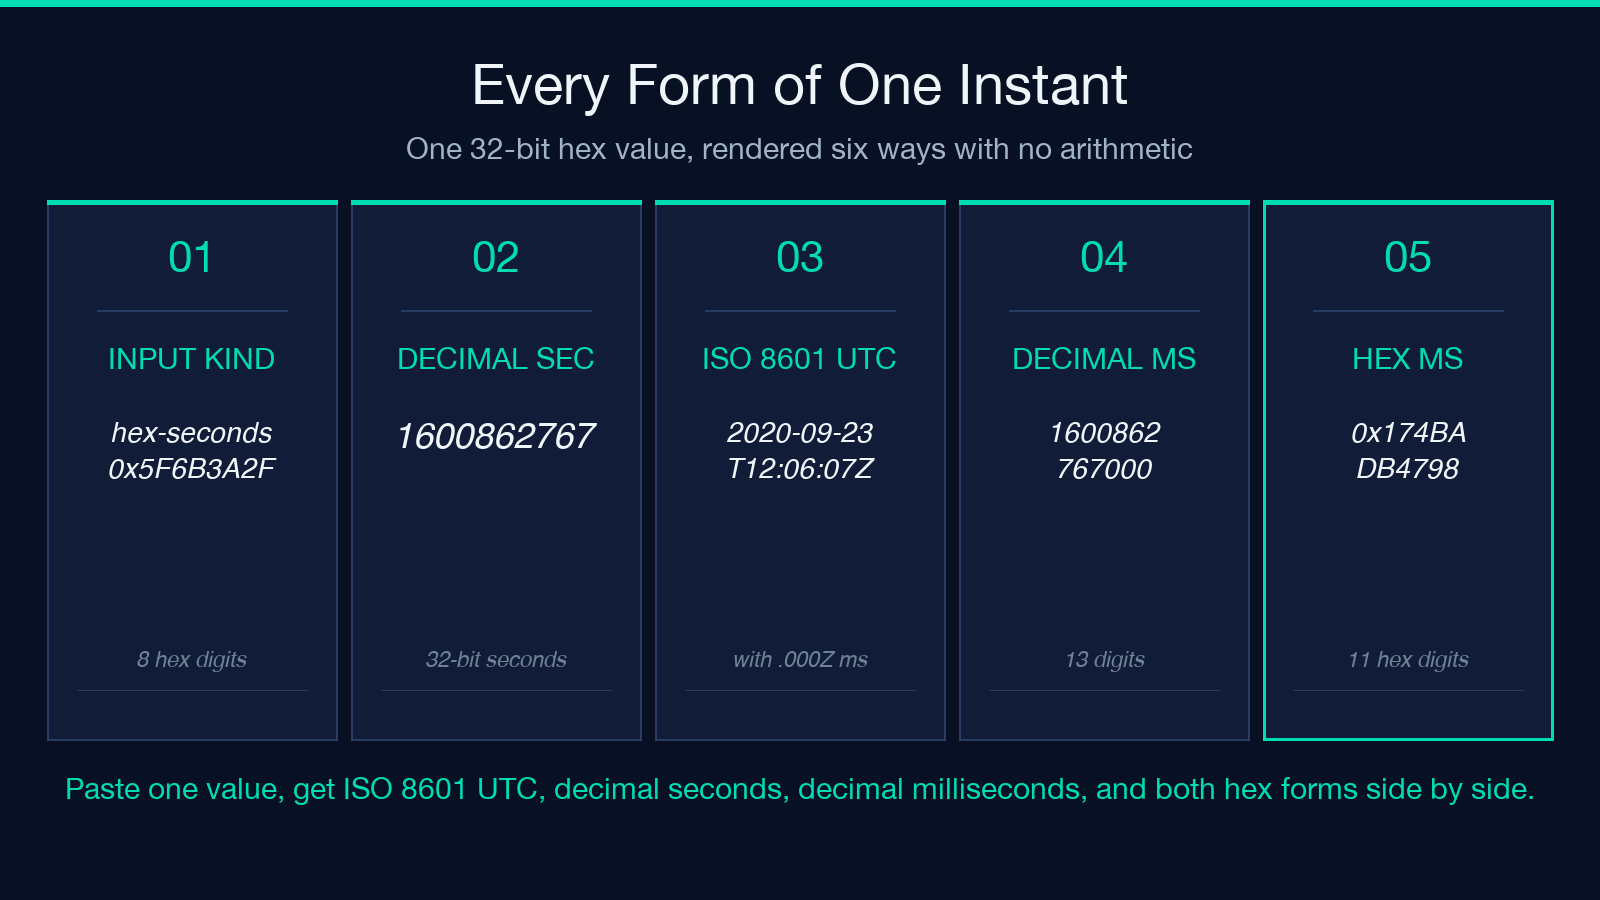
同一时刻的其他形式值得抄下来,因为写 bug 报告或给日志加注时用的就是它们:
- ISO 8601 UTC:
2020-09-23T12:06:07.000Z - 十进制秒:
1600862767 - 十进制毫秒:
1600862767000 - 十六进制毫秒:
0x174BADB4798
注意,毫秒值并不是在秒值后面补三个零的十六进制。它是秒值乘以一千之后再渲染的结果,位数因此涨到十一位。指望得到 0x5F6B3A2F000 的人会差出很远,这个错误够常见,值得单独点名。
字节序陷阱:给出一个看似合理的错误日期
接下来是促使人们去动字节序开关的那种情况。拿 2F3A6B5F 这个值。按大端读,它是 792357727,一个完全合法的时间戳:1995-02-09T19:22:07Z。
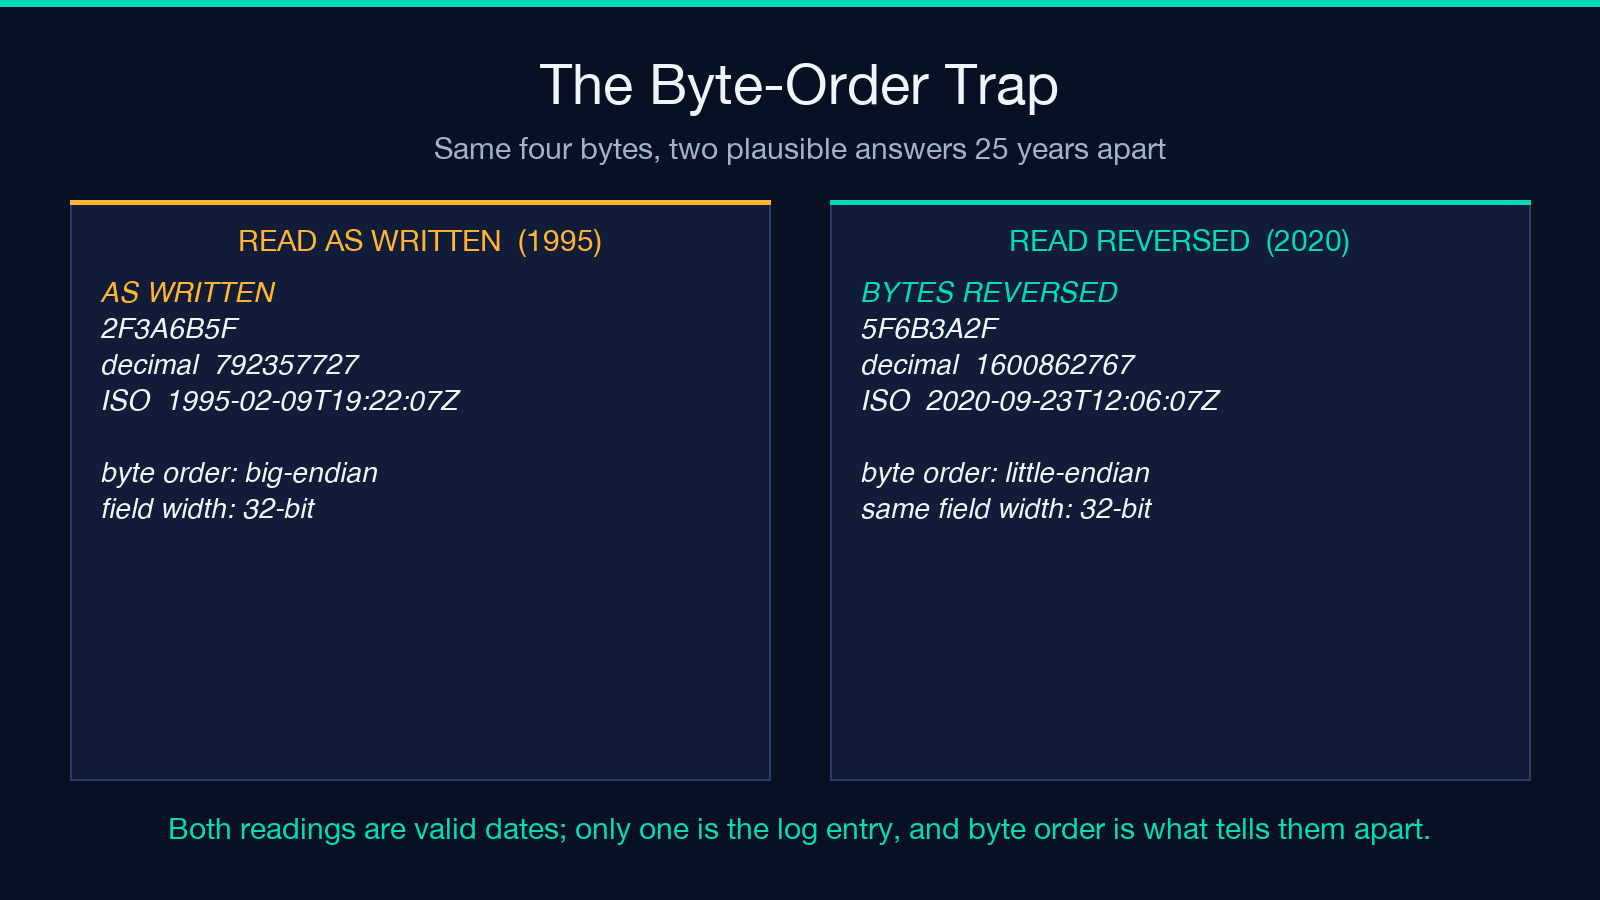
可要是这个字段其实是小端的生产者写下的呢。把这四个字节倒过来,2F3A6B5F 变成 0x5F6B3A2F,即 1600862767,即 2020-09-23T12:06:07Z,正是上一节那个时刻。
这种失败模式之所以危险,恰恰因为错答案看上去是对的。2026 年的日志里冒出 1995 年的日期,总有人会注意到。落在合理近期范围内的误读却没人留意。所以解码结果看着怪却又说得通时,先翻字节序,再去找数据的问题。
从十六进制这边看秒与毫秒
同一个年份在两种单位下差别很大。今天 UTC 零点的纪元秒是 1792713600,即 0x6ADAA380,八位十六进制。同一时刻的毫秒是 1792713600000,即 0x1A1660EAC00,十一位十六进制。
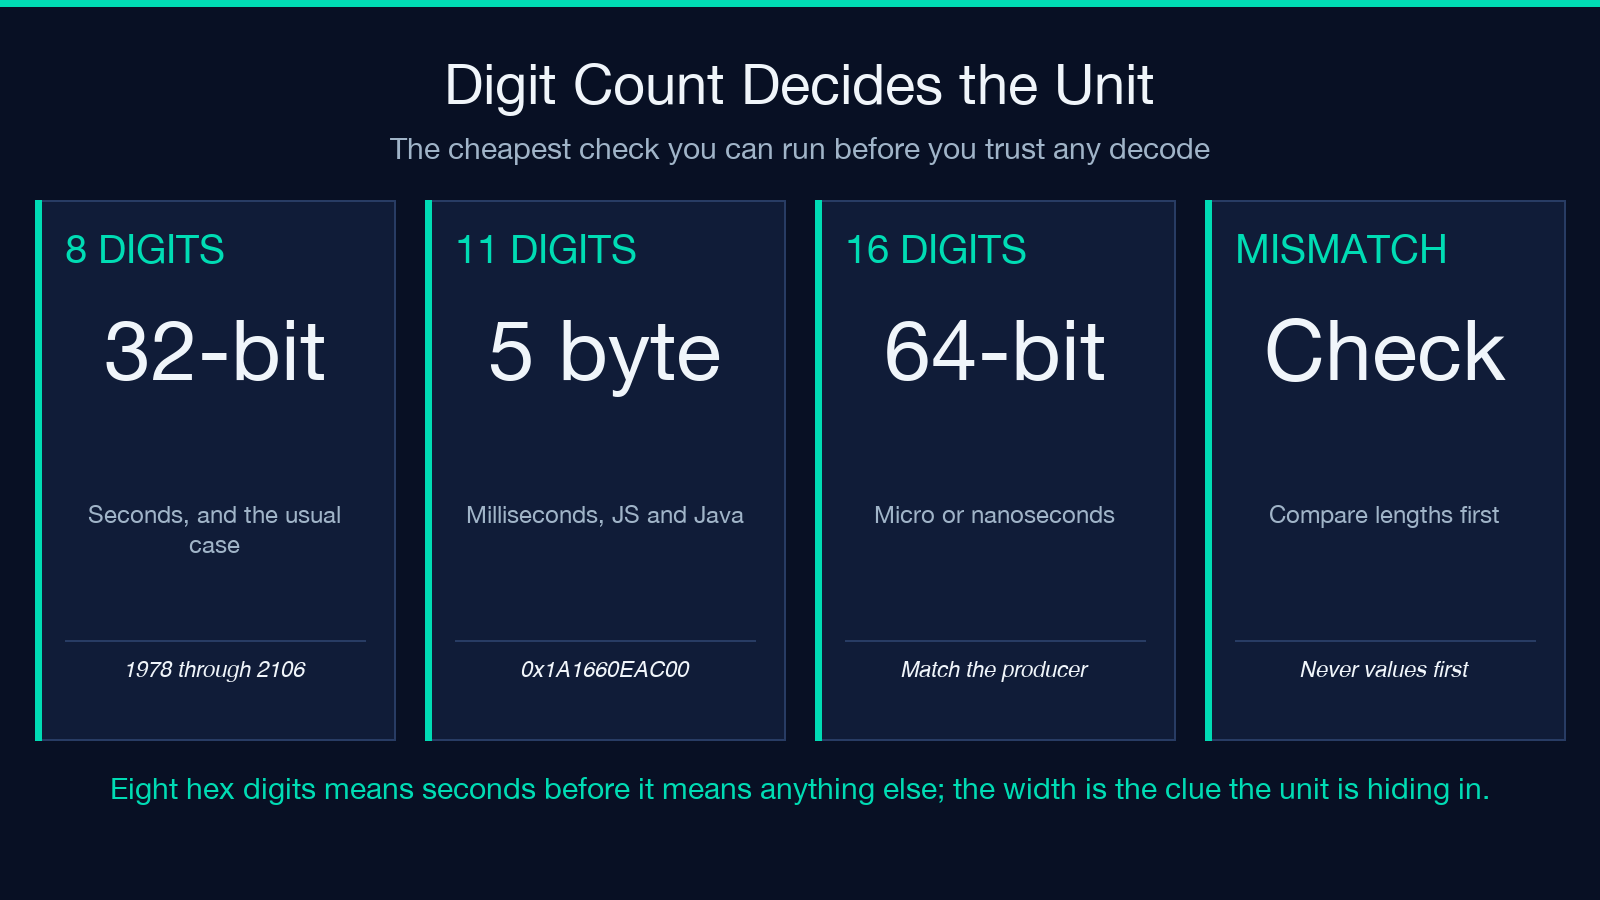
由此得两条实用规则。其一,秒字段与毫秒字段的十六进制位数从不相同,单看长度就能区分。其二,拿十六进制字段与 API 打印的十进制值比对时,先把长度对齐再比数值,否则看起来像数据损坏,实则只是单位不一致。
相信解码结果之前的五项检查
按顺序执行,一分钟内能做完,几乎能抓住所有错答案。
- 数位数。 八位是秒,十一位或十二位是毫秒,十六位是微秒或纳秒。
- 确认字节序。 时刻看着合理却不对,这个字段很可能是小端。
- 看年代。 2026 年的设备给出 1995 年的结果,通常是字节序翻了,不是时钟坏了。
- 明确时区。 上面所有输出都是 UTC。事件时间线用本地时间的话,要显式转换,不要想当然。
- 校验推算出的日期。 通用的 日期时间校验器 能在畸形输入进入下游解析器之前拦住它。
十六进制时间戳在真实系统里的出处
网络授时是最常见的来源,因为 NTP 把纪元和偏移字段编进与十六进制相邻的二进制结构里。如果你的问题涉及闰秒或纪元回绕,而不只是单位换算,那就交给 NTP RFC 5905 / SNTP 闰秒与纪元解码器,它处理纪元逻辑,简易转换器是有意略过这一块的。
第二类是令牌系统。JWT 把 iat 和 exp 作为 JSON 数字携带,习惯十六进制的调试器会把它们渲染成八位十六进制。手工读的时候,先用 JWT 解码器 解开声明,再转换里面找到的时间戳。
第三类是原始日志初筛。需要在时间戳字段旁边看清字节如何映射到可打印字符时,「十六进制与 Unicode:字节和码元」示例 用三种呈现方式展示同一串字节。目录里的其他东西,去 elysiatools.com 工具全集 浏览完整清单。
要记住的规则很短:数位数得宽度,用宽度得单位;结果看着合理却不对时,先怀疑字节序,再怀疑数据。
