
双向(Bidi)问题是排序问题,不是渲染问题。 这类问题只在同一行混排不同文字时出现。一行希伯来语发票,括号里放一个账号,在数据库里看着对,在 JSON 里看着对,上屏却是错的。原因在于 Unicode 用一个四遍算法确定视觉顺序,而几乎没有哪个应用自己实现过它。本指南按规则族逐个走查这条流水线,并借用解说器工具内置的两个完整示例:下次括号跑到错误的一侧,你能叫出是哪条规则把它放过去的。
你把文本粘进数据库时用的是逻辑顺序,也就是读者打字的先后。屏幕显示的是视觉顺序,从左到右或从右到左。两种顺序之间夹着 Unicode 双向算法(Unicode Bidirectional Algorithm),规范编号是 UAX #9。它没有一个可以直接调用的库,全世界文本栈都同意遵守这份契约;契约足够长,几乎每个调试它的人,实际上只是在调试其中某一条规则。
流水线:一行文本过四遍
UAX #9 分四个阶段运行,每个阶段的输出就是下一阶段看到的输入。第一步,由规则 P2 和 P3 取出段落嵌入级别,依据是第一个强类型字符,除非方向已被强制指定。第二步,由规则 X1 到 X8 遍历显式格式控制符,在方向状态栈上压入、弹出并记录嵌入级别。第三步,由弱类型与中性规则确定字符类型:W1 到 W7 处理弱类型,BD16 加 N0 处理配对括号,N1 和 N2 收拾剩下的。第四步,由 I1 和 I2 给出最终级别,再由 L1、L2、L4 重排行内顺序并镜像字形。
顺序比单条规则更要紧。一个括号如果在两侧嵌入方向确定之前就被定了类型,结果必然出错,N0 存在的意义正是防住这种情况。每一步的中间状态,都能在 Unicode 双向算法配对括号/隔离/嵌入控制符规则逐步解说器的走查输出里看到。
显式嵌入搭出一个方向状态栈
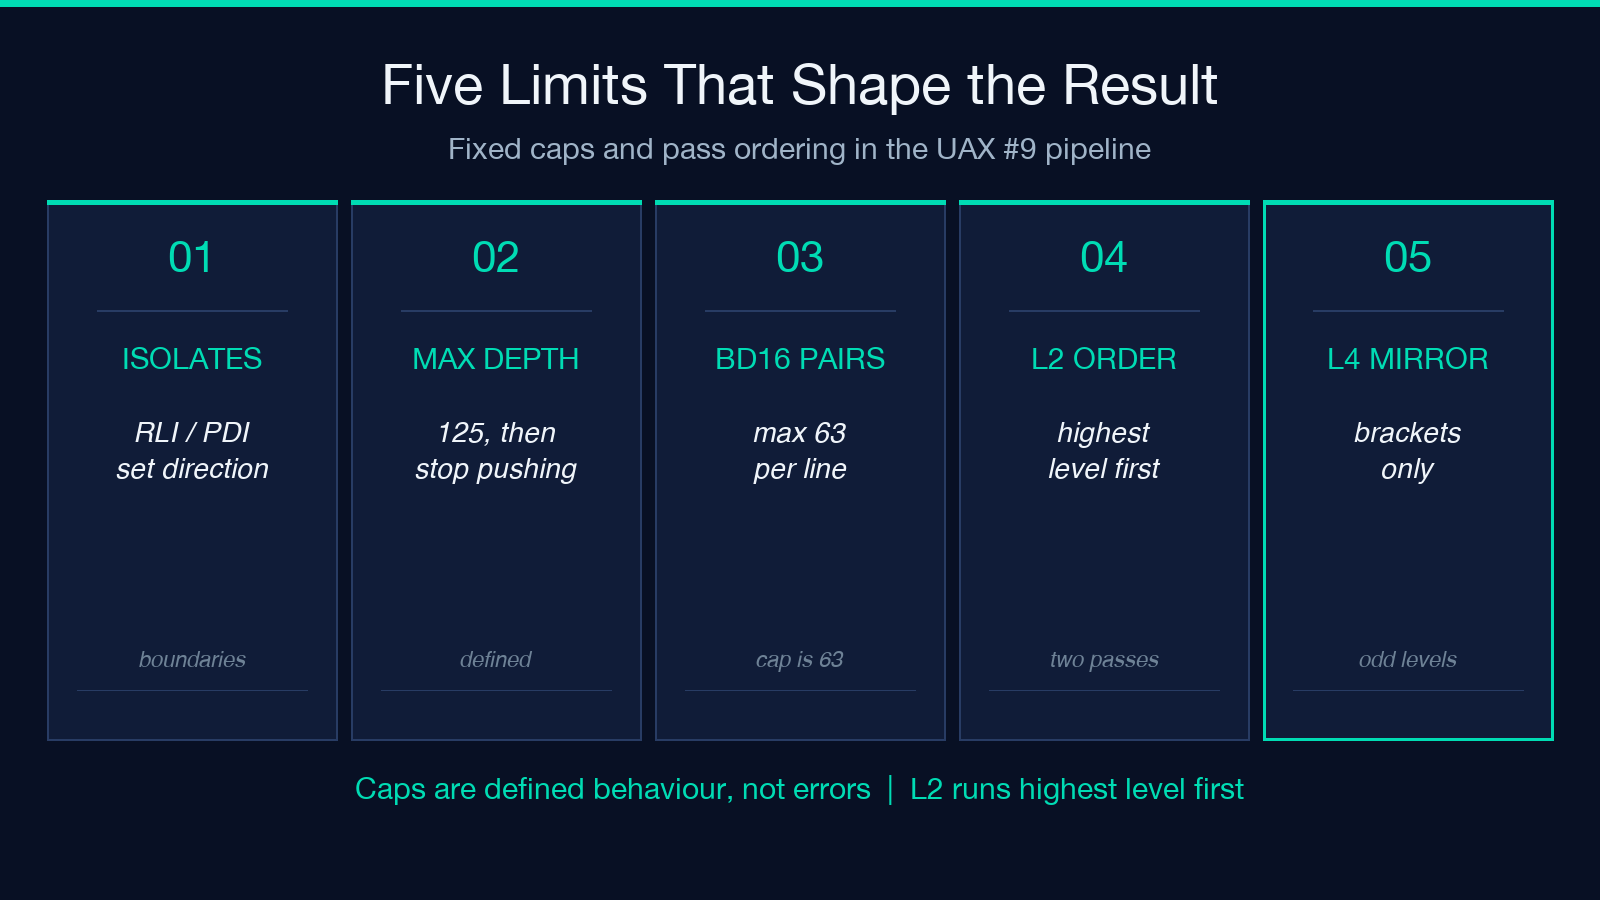
X 遍历是开发者最先撞上的部分。文本里真正能改变方向的字符只有 RLE、LRE、RLO、LRO、PDF,以及较新的隔离符 LRI、RLI、FSI、PDI;其余字符都只是继承。解析器维护一个栈,遇到起始符就压入一条新记录,遇到终止符就弹出,栈深硬性上限为 125。超过这个深度属于规范定义过的行为,不算错误:算法停止压栈,继续渲染。
有两个记号值得记住。<RLI> 开启一个从右到左的隔离区,<PDI> 关闭它。与更早的嵌入控制符不同,隔离符对周围文本同时充当一道中性边界,所以在多数真实内容里结果更干净。输入时既可以写具名记号,也可以写反斜杠加 u 的四个十六进制位转义,例如用 u2067 表示 RLI;工具会在每个字符之后报告当时的栈状态。
隔离运行序列才是解析单位
X 遍历之后,这一行会被切成若干隔离运行序列(isolating run sequence)。一个运行序列是同一嵌入级别上最长的一段字符,两端由隔离符或段落边界限定;它解析时总是只参照两个合成强类型字符:开头的 sos 与结尾的 eos。有了这两个合成类型,弱规则才能就地工作,不会把方向泄漏到隔离边界之外。
这是整份规范里最有用的一个思维模型。后面的所有步骤(W1、N1、括号规则)都以序列为单位运行,从不以段落为单位。含一个隔离符的行通常裂成两个序列,各自的最终级别可以不同;这就是为什么一个很短的示例在输出里会出现两遍重排。
弱类型看邻居定归属
W 规则通过观察上下文,把弱类型改判成强类型。W1 把紧跟在阿拉伯字母后面的欧洲数字或阿拉伯数字改判为阿拉伯数字。W2 把阿拉伯字母之后的欧洲数字改判。W3 把欧洲分隔符改成通用分隔符。W4 把夹在两个同类型数字之间的单个通用分隔符并入该类型。W5 把紧邻欧洲数字的一串欧洲终止符并入这个数字。W6 把剩下的分隔符与终止符改成通用类型。W7 在前一个强类型是阿拉伯字母时,把欧洲数字改成阿拉伯数字。
实际后果是:拉丁账号后面那个句点保持拉丁属性,希伯来数字后面同样的句点却被判成阿拉伯属性,改由中性规则定位。数字可以带有与段落不同的隐式方向,双语发票里标点跑到错误一侧,多数源头就是数字。
配对括号先走 BD16,再交给中性规则
这是多数实现会跳过的那条规则,跳过的后果就是那个经典 bug:本该贴住被括内容的括号,跑到了行的另一头。规则 BD16 依据 Unicode 的 Bidi_Paired_Bracket 属性,从文本中建一张括号配对表,上限 63 条。规则 N0 随后逐个检查配对,判断括号内部是否含有与周边嵌入方向相同或相反的强类型。
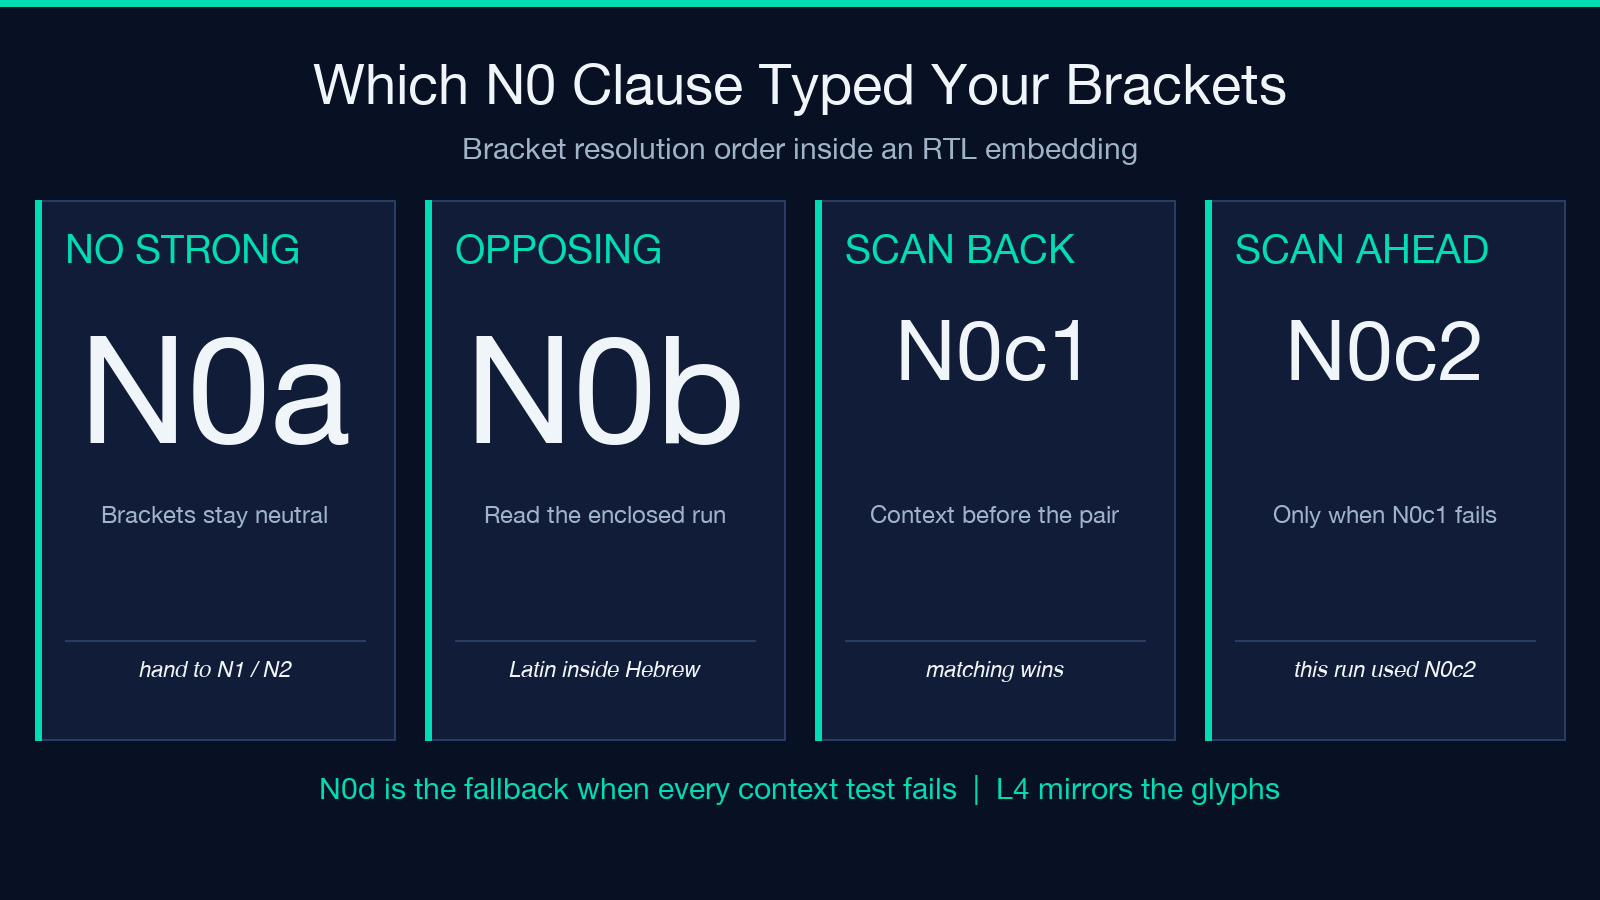
条款一共四条。N0a 适用于配对内部完全没有强类型的情况,两个括号都留作中性。N0b 看的是括号里包住的那个强类型。N0c1 检查前面的上下文,N0c2 检查后面的上下文。只要其中一处与嵌入方向一致,括号就取这个方向。N0d 是兜底条款,把括号交给中性规则处理。类型确定之后,规则 L4 镜像字形,屏幕上左括号看上去仍然是左括号。
中性规则 N1 与 N2 收尾
括号配对定完类型,剩下的就只有中性字符:空格、制表符,以及夹在两个强类型之间的标点。规则 N1 处理夹在同向两个强类型之间的中性序列,让它取这个方向;两侧邻居不一致时就不动它。规则 N2 再兜住所有剩余部分,包括每个隔离运行序列开头和结尾的那几段,一律回落到嵌入方向。
段落边界上的归属,就是由 N 规则决定的。以希伯来语开头的段落,末尾那个句点是中性字符,一侧是强希伯来语,另一侧是合成的 eos,于是 N2 把它交给段落方向,它渲染在左侧。把段落方向改成 LTR,同一个字符就会翻到另一侧;同样的输入,方向选项一换答案跟着变,原因就在这里。
隐式级别、重排遍数与镜像
规则 I1 把每个从右到左字符的级别加一;I2 把成串的欧洲数字、阿拉伯数字及其尾部隔符的级别加二。规则 L1 重置整行,把段落边界处的空白与隔离格式控制符隔离出来,恢复行尾空白。规则 L2 随后从最高级别降到最低奇数级别,逐级反转连续片段;混排的一行需要好几遍处理,原因就在这里。
反转这一步最不直观。因为处理从最高级别开始,而最高级别对应最内层的隔离区,等外层处理执行时,内层内容已经翻过一遍了。镜像是另一件事,范围小得多:只有处在奇数级别、且存在奇数镜像变体的字符才会互换,实践中基本就是括号字形。手写复现时,镜像过头是常见 bug;排查该翻没翻的问题,先查级别,再查字体。
两个完整示例,逐条规则走一遍
第一个示例的段落整体从左到右,里面用 RLI 隔离区包住一段拉丁文本和一段希伯来文本。P2 在隔离符之前找不到强字符,所以段落级别是 0。隔离符把这一行切成两个序列,序列数是 2。隔离区内的拉丁词升到级别 2,希伯来段留在级别 1;先在级别 2、后在级别 1 做两遍反转,得到的视觉行里,句点跑到最左边,希伯来文绕着拉丁文翻转:先是 .def,接着是反转后的希伯来文,最后是 abc。
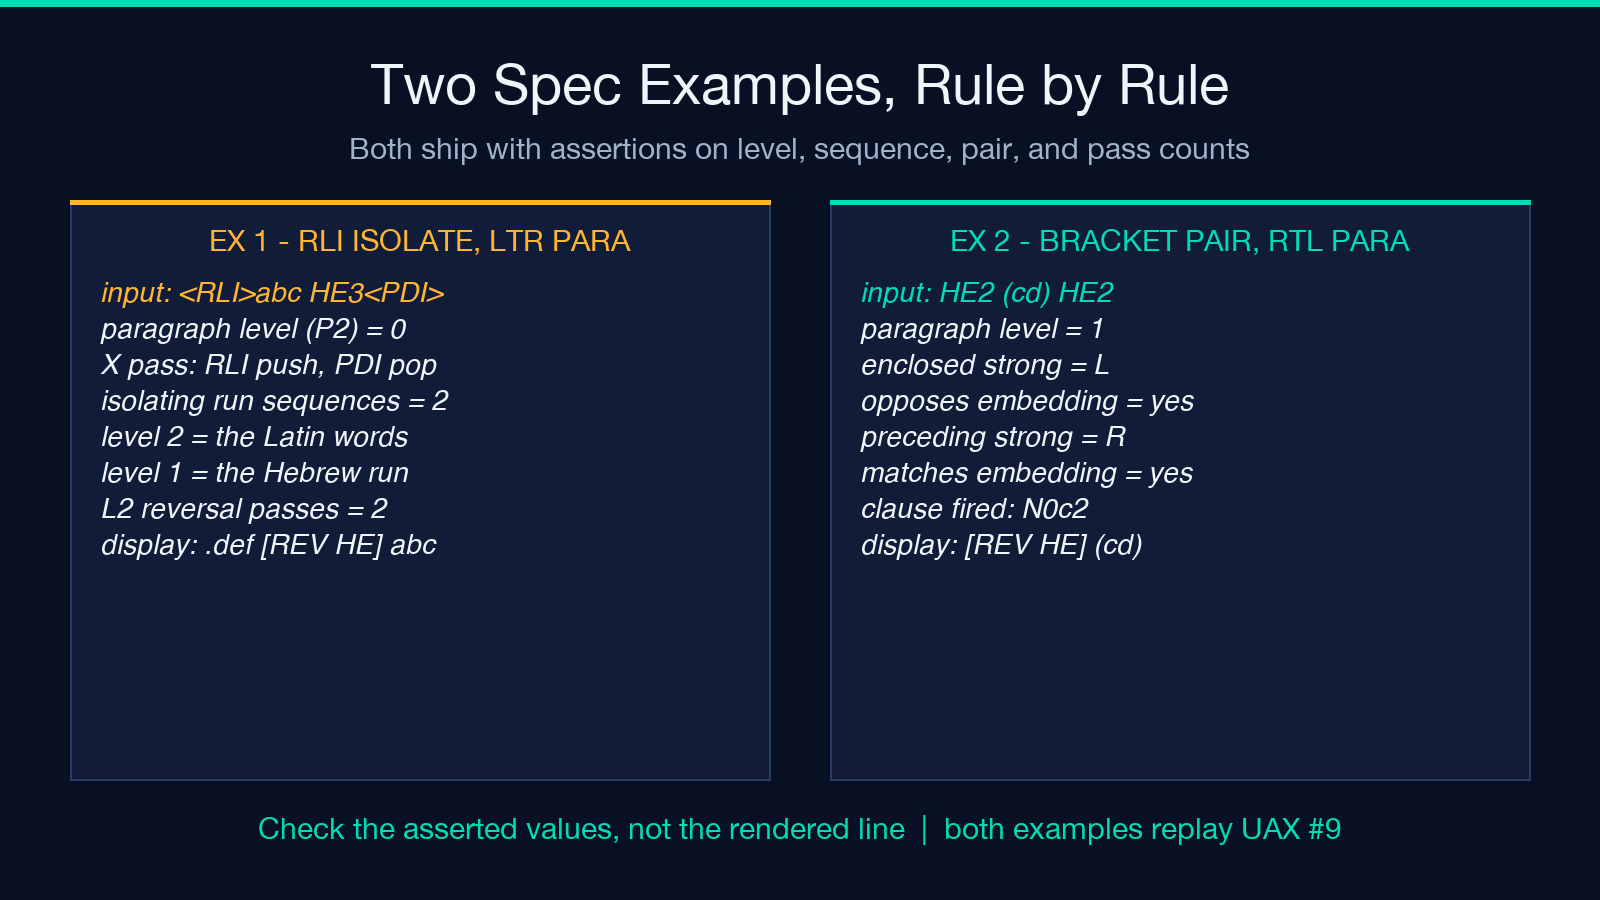
第二个示例是 RTL 段落,级别 1,括号里只包拉丁强字符。N0 找到这个配对,看到内部的强类型与嵌入方向相反,于是回扫到前面的希伯来文,发现它与嵌入方向一致而非相反,便按 N0c2 把两个括号都定为 R。接着 L4 镜像字形,括号在视觉行里仍然读得对。两个示例都附带断言,覆盖段落级别、序列数、反转遍数、括号配对数和最终显示字符串;你可以拿精确的期望值核对自己的实现,不用靠眼睛。
如果只要视觉结果、不需要逐步走查,用 镜像文字 把一行反转过来快速看一眼就行。换成文档场景,问题会从字符转到字体和嵌入,这部分由 PDF双向文字测试 单独检查。
别再怪渲染器。 双语行排错了,缺陷几乎总是落在一条规则上,而这条规则几乎总是 BD16、N0,或者 L2 的处理顺序。把逻辑顺序的字符串粘进 Unicode 双向算法配对括号/隔离/嵌入控制符规则逐步解说器,看级别表和类型表,错位的字形会自己报出名字。文本与编码方向的更多工具,都在 elysiatools.com 文本处理分类 下。

Pingback: Unicode Bidi Rule Explainer Field Guide: When BD16 and N0 Put Your Brackets on the Wrong Side - COSESAI