
当线性方程组 A · x = b 在屏幕上弹出「无唯一解」,真正的问题在于 A⁻¹ 到底存不存在,不在算法有没有出错。这个问题的答案在结构上分三种,取决于你站在线性代数的哪一条分支上。
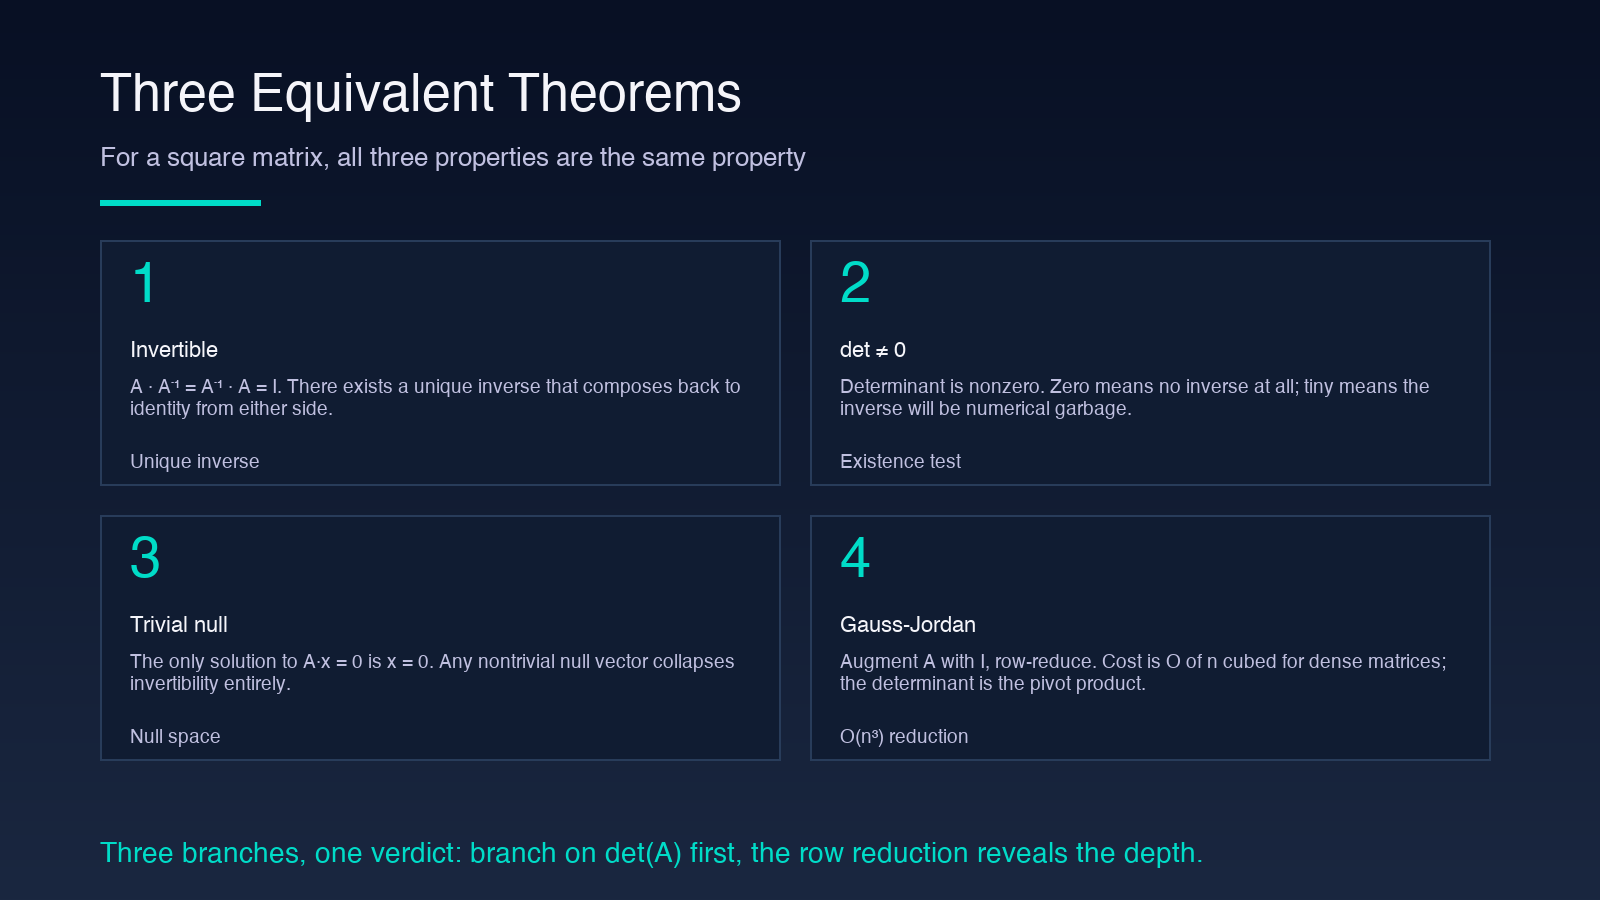
一个矩阵有逆,当且仅当它是方阵且行列式非零,整个问题就这一句
求逆时你真正在意的每一种矩阵性质,都由一个数字决定:行列式。具体说,对实数域上的 n × n 方阵 A,下面三条彼此等价:
A存在逆矩阵A⁻¹,满足A · A⁻¹ = A⁻¹ · A = I。det(A) ≠ 0。A · x = 0只有平凡解x = 0。
这三条不是三个彼此独立的性质,而是同一件事的三种说法,证明也只需一页高斯-若尔当消元。所以计算器报「不可逆」或「行列式为零」,意思就是这三条同时不成立,你也不必再找一个能保住可逆性的巧妙绕法。行列式要么是零,要么不是。
那么实际问题变成:多接近零才算「对你来说等于零」?对 3 × 3 的整数矩阵,这个阈值显而易见,det = 0 就是精确的零。对 100 × 100 的矩阵,元素来自浮点传感器数据,det = 1.4 × 10⁻⁸⁵ 在字面上非零,功能上却等同于奇异,舍入误差会压过你算出的任何逆。这正是矩阵求逆计算器(Matrix Inverse Calculator)的区别所在:它不只交出逆,还一次报出行列式、矩阵秩和条件数,你能看到答案之所以如此的缘由。
分支一:小矩阵(n ≤ 4)的行列式判定
对 2 × 2 或 3 × 3 矩阵,行列式几乎在同一步运算里既给出可逆性判断,也给出逆矩阵。沿第一行做拉普拉斯展开,2 × 2 矩阵得到:
| a  b |
| c  d |
其中 det = ad − bc,伴随矩阵公式直接给出逆:(1/det) · [[d, −b], [−c, a]]。这里的精确算术,正是 2 × 2 求逆在作业里显得像开挂的原因:答案永远是一个分数。
对 3 × 3 矩阵,萨吕斯法则(Sarrus rule)把同样的逻辑推到三阶,不必做余子式展开;再大的矩阵就不行了,代价涨得很快。4 × 4 行列式的拉普拉斯展开有 24 项,每项三个乘积,手算还能忍,调试时错一个符号就很痛苦。计算器不关心这些细节,只要尺寸允许就切到高斯-若尔当消元,行列式从主元连乘里自然出来。
这就是「轻松」的那条分支:规模小、条件良好、算术精确。你需要看的全部诊断信息,就是行列式是不是零,以及它的量级告诉了你什么。
分支二:高斯-若尔当消元,两种失效模式在这里现形(n ≤ 约 100)
矩阵一旦大到手算展开开始吃力,高斯-若尔当消元就接手。算法把 A 与单位阵 I 拼成增广矩阵,做行化简直到化成 [I | A⁻¹]。稠密矩阵的代价是 O(n³):50 × 50 的矩阵在纯 Python 里要将近 60 秒,在编译好的线性代数库里不到一秒。
高斯-若尔当过程中会暴露两种失效模式,单看行列式发现不了:
- 消元中途出现零主元。 当前行在主元列上没有可用的非零元素,换行也找不到,行列式随即塌成零。这叫「结构性奇异」,通常意味着原矩阵的行或列线性相关。
- 消元中途出现极小的主元。 当前行有可用的主元,但它小到做除法时会把舍入误差按 1/pivot_size 倍放大。主元是 10⁻⁶,后续每一行都承受 10⁶ 倍的舍入放大。这叫「数值奇异」:行列式字面上非零,算出来的逆却是数值垃圾。
条件数描述的正是这件事:κ(A) = ‖A‖ · ‖A⁻¹‖。条件良好的矩阵,κ 是 O(1);病态矩阵的 κ 可以到 10⁶、10¹² 甚至更大,无论你用哪种算法,逆矩阵前几位之后的每一个数字都被舍入误差占据。
分支三:对根本求不了逆的矩阵,用奇异值分解
面对 1000 × 1000 的传感器数据矩阵,或者任何行列式无法干净地落在浮点范围内的输入,高斯-若尔当理论上仍然可用,问题却已经变了。你问的不再是「这个逆是否精确」,而是「在这个降秩子空间上,我能算出的最好近似逆是什么」。
SVD(A = U · Σ · Vᵀ)把矩阵拆成三个正交部分,Σ 对角线上的奇异值直接告诉你哪些子空间承载信号、哪些只是噪声。「伪逆」A⁺ 只保留超过选定阈值的奇异值,其余丢弃,numpy.linalg.pinv 默认就是这么做的,阈值取相对最大奇异值的 1e-15。
计算器不会对每个输入都自动切到 SVD,但秩的报告给出同样的信息:若 rank(A) < n,矩阵是方阵、奇异、降秩,逆要么不存在(秩严格小于 n 时),要么唯一确定却在数值上不稳定(秩等于 n 而 κ 极大时)。对非方阵输入(m × n 且 m ≠ n),计算器会正确地报「无逆」,因为逆是方阵的概念,同时为需要 SVD 最小二乘结果的用户算出伪逆。
一份靠谱的计算器会交给你三个输出,怎么读
你真正想要的不只是 A⁻¹。判断这个逆值不值得信任的是三个数字:
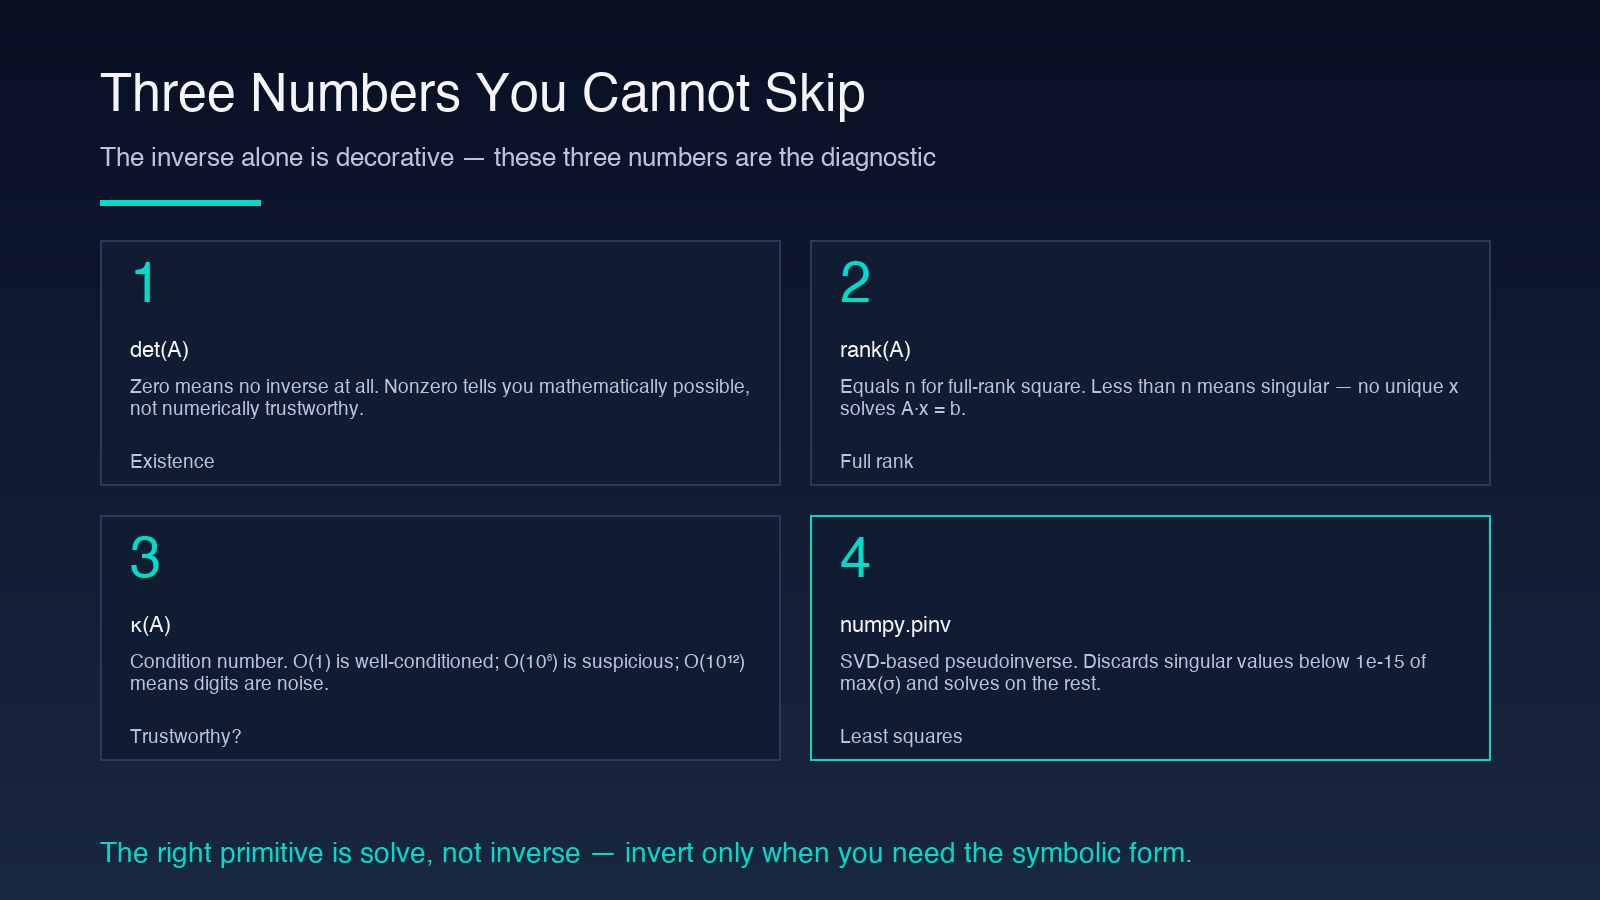
det(A):为零则根本没有逆;非零只说明数学上至少存在一个逆。rank(A):满秩方阵等于n,小于n就说明矩阵奇异。κ(A)(条件数):O(1) 条件良好,O(10⁶) 值得怀疑,O(10¹²) 或更大意味着逆在数学上有定义、在数值上毫无意义。
矩阵求逆计算器 一次就把这三样都报出来,诊断和答案一起来。对 3 × 3 的小整数矩阵,光看行列式就够。对来自线性回归或协方差矩阵的 50 × 50 矩阵,条件数是唯一能区分「矩阵正确、逆也正确」与「矩阵正确、逆是垃圾」的信号。
两个算例,两种不同的失效模式
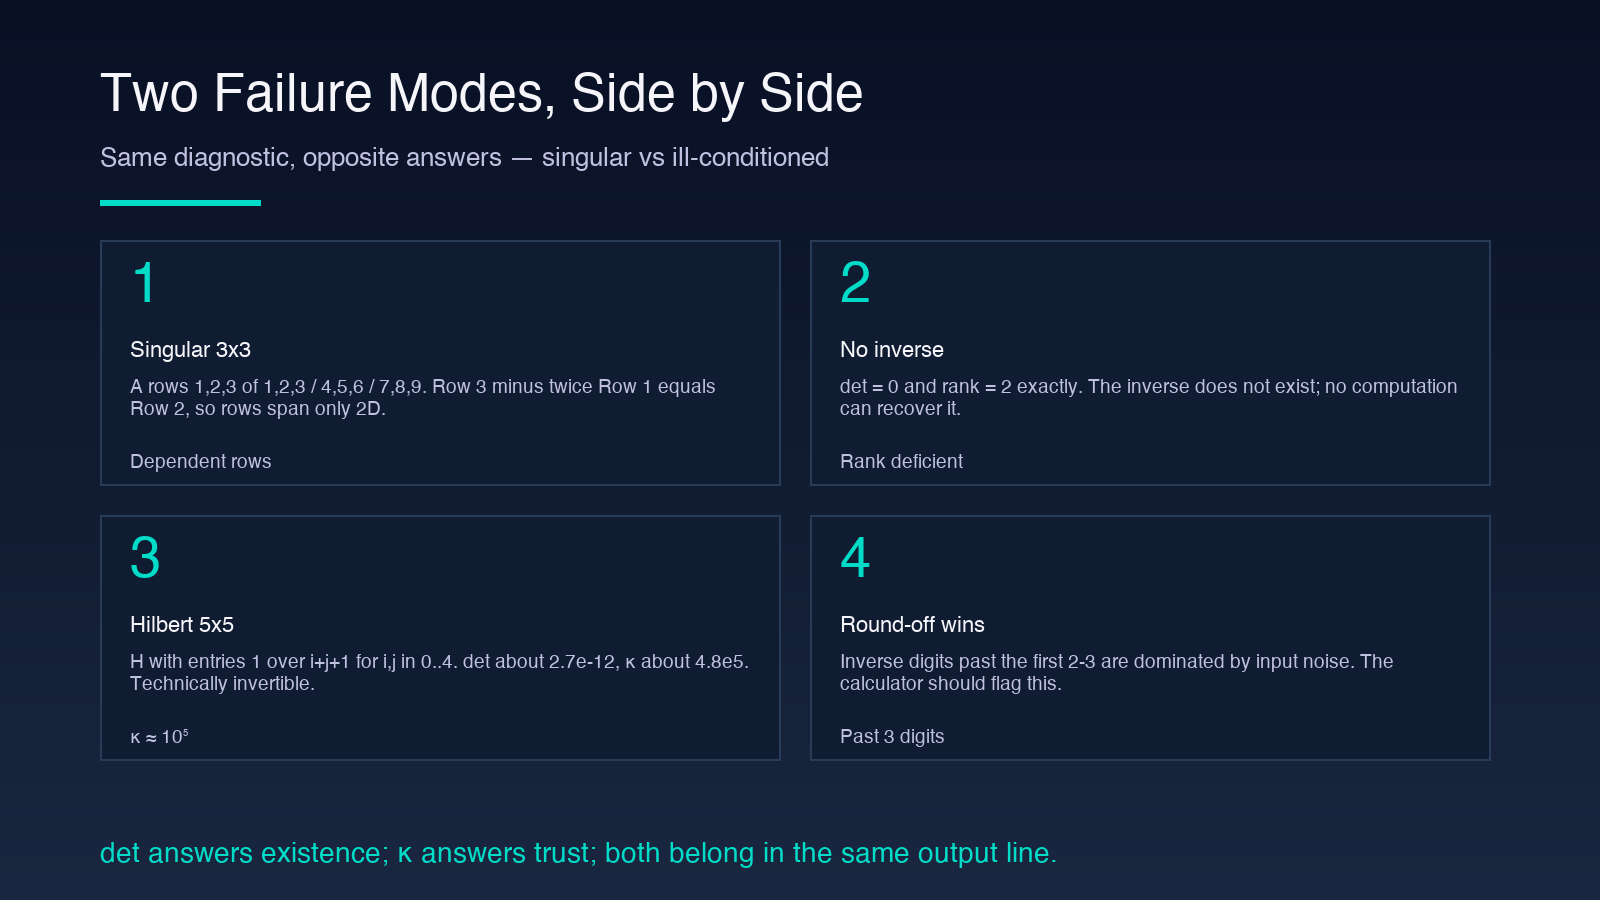
先看一个由相关行构成的 3 × 3 矩阵:
A = [[1, 2, 3],
     [4, 5, 6],
     [7, 8, 9]]
第 3 行减去第 1 行的两倍正好等于第 2 行,三行只张成一个二维子空间。行列式精确为 0,秩为 2,逆不存在。计算器一行字就把这事说清,并且拒绝编造一个结果。
再看希尔伯特矩阵(Hilbert matrix)H,H[i][j] = 1 / (i + j + 1),i, j 取 0..n−1。取 n = 5,行列式约为 2.7 × 10⁻¹²,条件数约 4.8 × 10⁵。矩阵在技术上可逆,行列式在技术上非零,但逆增长得太快,输入数据的舍入误差会毁掉算出的逆里除前两三位以外的全部数字。这是教科书式的「病态」失效:计算器仍然该返回一个逆,但要在视觉上标出来,提醒你别信尾部那些数字。
计算器给出的答案,可能根本不是你该问的问题
互联网上每个线性代数论坛都会反复出现同一个错误:你其实想解 A · x = b,却在算逆。对 n × n 矩阵,逆需要 O(n³) 的内存和 O(n³) 的运算量;三角求解只要 O(n²) 的内存和 O(n²) 的运算量,拿到的答案一样。n = 1000 时,求逆要 8 GB 内存和大约十亿次浮点运算,求解只要 8 KB 和一百万次。
如果你的真实问题是「哪个 x 满足这个线性系统」,正确的原语是带前代回代的 LU 分解,而不是矩阵求逆。计算器两者都提供,但逆应该当备用路径:用于符号层面查看(2 × 2 的 A⁻¹ 能把闭式写法直接摆出来),或者用于诊断(逆矩阵会暴露哪些行、哪些列起决定作用),不该当默认求解器。
收尾
线性代数的三条分支,小矩阵走直接法,中等规模走高斯-若尔当,数值不稳定时走 SVD 伪逆,最后收敛到同一条操作规则:只有当行列式确实非零、条件数有界时,逆才可信。矩阵求逆计算器给出的其它任何输出,都只是这条规则周围的装饰。
想把失效模式并排看,矩阵求逆计算器 会用一个奇异矩阵、一个希尔伯特矩阵和一个单位阵跑同一套诊断,把行列式、秩、条件数与逆一起打印出来。这三个数字背后的数学,与任何编译好的线性代数库内部做的事完全一样,区别在于你能一次全部看到。
想找更多把原始矩阵输入翻译成可检查数值输出的工具,Elysia Tools 工具集收录了完整清单。
