
当 109580041603153152 这样一串 Snowflake 风格的 ID 落在屏幕上,真正的问题不是哪个平台生成了它,而是你正在读哪一段 42 位时间戳、哪一个 5 位 worker 槽位、以及该槽位内的哪一个 12 位自增计数。纪元选错,一个本来完全正常的数字就会变成公元 48,817 年。
Discord ID、Twitter Snowflake、Mastodon ID、Sonyflake、Instagram,以及上百种公司内部自定义方案,都把身份信息挂在同一个 BigInt 上。它们在屏幕上一模一样:十六位十进制数字,没有连字符,没有分隔符。纪元一旦弄错,一条 2017-04-13 的 Discord 消息就会被静默映射到石器时代,或者映射到热寂之后。每个平台都挑了自己的起始时刻,Discord 的 2015-01-01T00:00:00Z 与 Sonyflake 的 2014-11-04T01:42:54.657Z 之间的差距,就是时间戳落在你预期的地方与落在别处的差距。
这篇指南走一遍完整流程:粘贴一个 64 位 ID 时,Snowflake / Discord ID 位字段解码器到底解出了什么;六个默认平台在位字段层面各自怎么对齐;自定义配置这条路径如何在默认值无能为力时描述一套布局;分片计算又怎么把一个 worker 槽位变成 bucket = ID >> 22 % shardCount 查询。目标是把任何 64 位 ID 解码器都绕不开的五个决定讲得足够清楚,让输出不对时你能直接定位原因,不必反复试错;历史上出现过的 Snowflake 变体则不在逐一列举之列。
一个 Snowflake 就是一个 64 位整数,切成三段字段,切法因平台而异
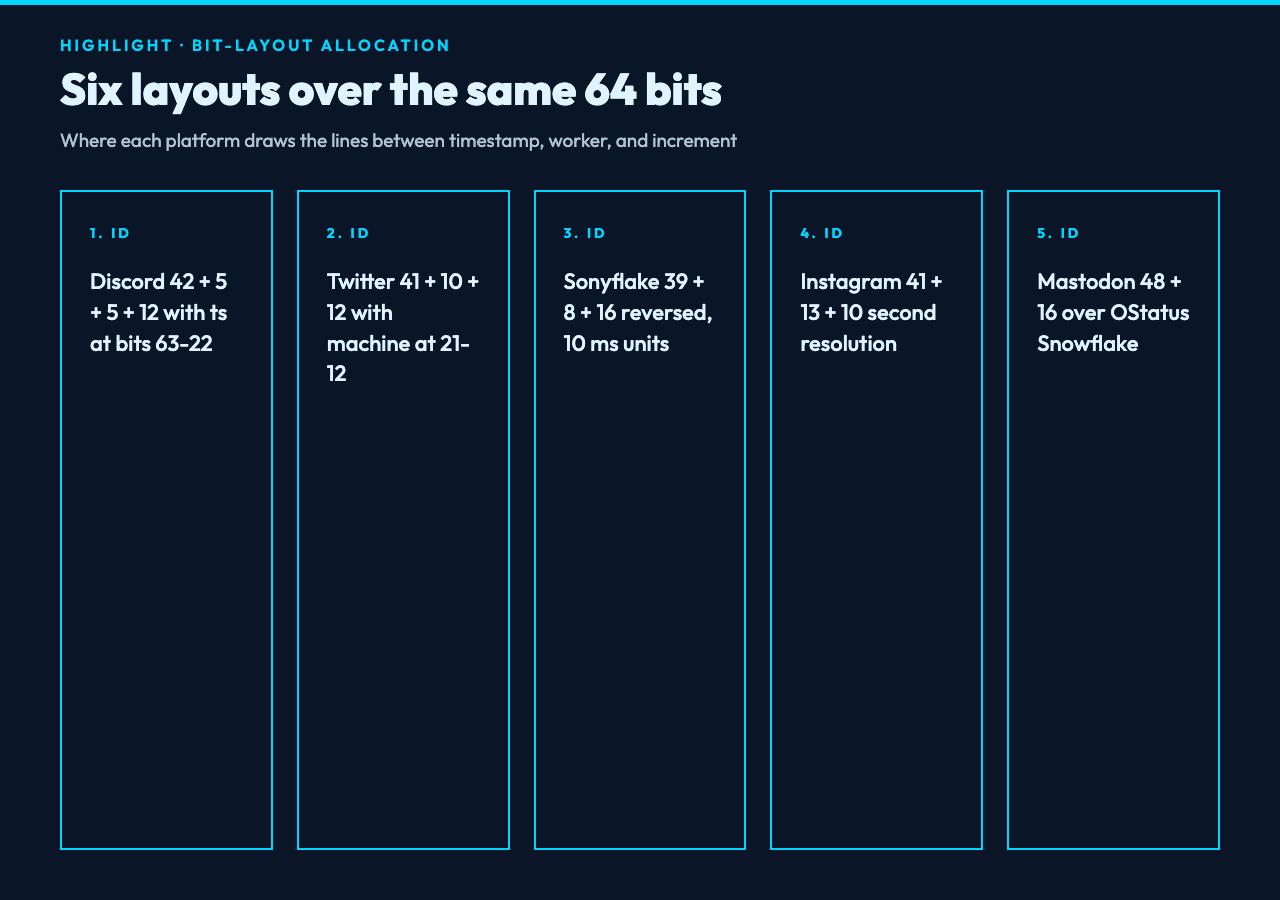
所有 Snowflake 风格的 ID 都套同一个模板:最高位一段时间戳,中间一段 worker/进程/机器标识,最低位一段序列号或自增计数。模板相同,位数分配不同。Discord 用 (42-bit ms timestamp) | (5-bit worker) | (5-bit process) | (12-bit increment);Twitter Snowflake 用 (41-bit ms timestamp) | (10-bit machine) | (12-bit sequence);Sonyflake 把顺序倒过来,用 (39-bit 10ms units since local epoch) | (8-bit machine) | (16-bit counter);Instagram 用 (41-bit second-resolution timestamp since 2011) | (13-bit shard) | (10-bit sequence);Mastodon 的内部 ID 保持 Snowflake 布局 (48-bit ms timestamp | 16-bit random),对外发布的帖子则使用 OStatus Snowflake,布局与 Discord 完全一致,都是 42 位 / 5 / 5 / 12。
Snowflake / Discord ID 位字段解码器内置全部六个预设平台,把同一个 64 位数字按每个预设的位布局分别解析一遍。同一个 109580041603153152,在 Discord 预设下解出 2017-04-13T11:42:28.064Z;在 Twitter 预设下解出同一时刻(两个预设共用 2010-11-04T01:42:54.657Z 这个纪元……其实并不共用,下文再讲);在 Sonyflake 预设下则可能落到预期范围之外的某一年。结果取决于解码器选了哪套位布局、哪个纪元。输出是三个数字加一个推断出来的分片,每一个都来自同一个 64 位整数的不同切片。
五个默认平台的分歧点在纪元,大多数解码器的 bug 也藏在这里
位布局决定哪些位承载时间戳,纪元决定这些位代表什么。六个默认平台挑了六个不同的起始时刻:
– Discord 对官方公开 ID 使用 Twitter 纪元 2015-01-01T00:00:00Z(2024 年起部分内部 ID 迁到了自定义纪元,但历史公开 ID 一律使用 Twitter 那个时刻)。
– Twitter Snowflake 用 2010-11-04T01:42:54.657Z,即 Twitter 创立的那一秒,再削掉一点毫秒余数,方便用毫秒整数表示。
– Mastodon 的 OStatus ID 同样使用 Twitter 纪元,但一些 Mastodon 分支在发布时带了 2014-02-24T17:30:00Z 或其他本地选定的时刻。
– Sonyflake 用 2014-11-04T01:42:54.657Z,与 Twitter 纪元很接近但并不相同。关键在于它的粒度是 10 毫秒而非 1 毫秒,所以 Sonyflake 时间戳的单位换算也不一样。
– Instagram 用 2011-01-01T00:00:00Z,时间戳为秒级分辨率,它的 41 位块存的是 2011 年以来的秒数,不是 2010 年以来的毫秒数。
– 自定义允许你自己提供纪元和单位。每家公司每一套内部 Snowflake 方案的起始时刻都不一样,六个默认值只图方便,并不是完整清单。
以 109580041603153152 为例,时间戳块位于 (63..22),宽 42 位。按 Discord 预设计算:(109580041603153152 >> 22) + discord_epoch_ms = 1492081348064 ms since Unix epoch,即 2017-04-13T11:42:28.064Z。按 Twitter 预设,同一个 42 位块算出的毫秒数完全相同,但要加到另一个纪元上,即 twitter_epoch_ms = 1288834974657。慢着:这个对比要想成立,先得注意到 Discord 的公开纪元与 Twitter 的 Snowflake 纪元其实是两个不同的时刻,尽管两边都常被叫作「Twitter 纪元」。市面上至少流传着三个「Twitter 纪元」:2010-11-04T01:42:54.657Z(Snowflake 的规范纪元)、2015-01-01T00:00:00Z(Discord 公开 ID 的纪元),以及某些库当作锚点引用的 2010-11-04T01:42:54.657Z。
解码器为每个平台只认一个规范纪元。如果你的 ID 来自某个改了默认纪元的分支,而几乎所有内部 Snowflake 都改过,时间戳就会正好差出那个分支的纪元偏移量。自定义纪元输入就是留给这种情形的出口。
位布局映射:各平台的移位与掩码常量从哪来
纪元定下来之后,下一个问题是哪些位承载时间戳、哪些位承载 worker、哪些位承载序列号。任何运行时 Snowflake 库在启动时算一次的那组移位与掩码常量是:
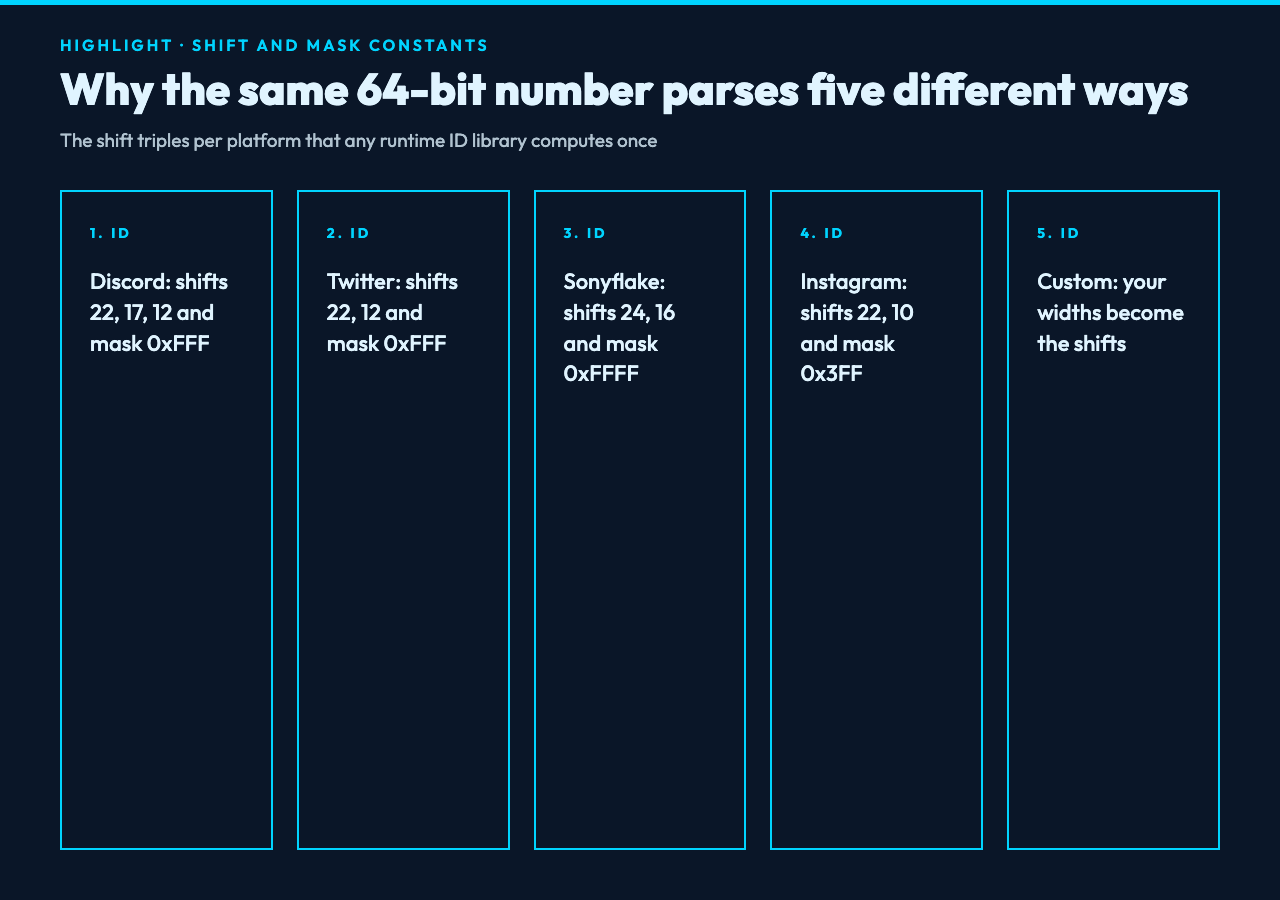
– Discord:按 (timestamp, worker, process, increment) 顺序分配 (42, 5, 5, 12) 位,时间戳在 (63..22),worker 在 (21..17),process 在 (16..12),increment 在 (11..0)。移位为 (>>22, >>17, >>12, & 0xFFF)。
– Twitter Snowflake:按 (timestamp, machine, sequence) 顺序分配 (41, 10, 12) 位,时间戳在 (63..22),machine 在 (21..12),sequence 在 (11..0)。移位为 (>>22, >>12, & 0xFFF)。
– Sonyflake:(39-bit 10ms-units timestamp, 8-bit machine, 16-bit counter),分别位于 (63..24, 23..16, 15..0)。移位为 (>>24, >>16, & 0xFFFF),单位乘数是 10ms 而非 1ms。
– Instagram:(41-bit second-resolution timestamp, 13-bit shard, 10-bit sequence),分别位于 (63..22, 21..10, 9..0)。移位为 (>>22, >>10, & 0x3FF),单位乘数是 s 而非 ms。
– Mastodon(Snowflake 系):(48-bit ms timestamp, 16-bit random),分别位于 (63..16, 15..0)。随机数那半段的移位为 (>>16, & 0xFFFF)。
– 自定义:位宽随你指定,顺序按自定义字段 JSON 里列出的先后(最低位字段在前)。
每个字段的掩码常量是 (1 << field_bits) - 1,移位常量是该字段以下所有字段位宽之和。一个把 Discord 的 (>>22, >>17, >>12, & 0xFFF) 写死的解码器,遇到 Twitter、Instagram 或 Sonyflake 会静默算出错误的 worker 和错误的 sequence。移位三元组 (timestamp_shift, worker_shift, sequence_shift) 的变化量正好等于各字段下方位宽之和,这正是同一个 64 位整数按五套布局解析会得到五组不同结果的原因。
worker 槽位与分片计算通常写作 >> (seq_bits) & worker_mask,但顺序很要紧
时间戳抽出来之后,接下来的十位左右编码 worker、process、machine 或 shard,最后十二位左右编码该 worker 在一个时间刻度内的序列号。Discord 的解码写法是:
worker_id  = (snowflake >> 17) & 0x1F   # 5 bits, bits 17-21
process_id = (snowflake >> 12) & 0x1F   # 5 bits, bits 12-16
increment  = snowflake & 0xFFF         # 12 bits, bits 0-11
Twitter 是:
machine_id = (snowflake >> 12) & 0x3FF  # 10 bits, bits 12-21
sequence   = snowflake & 0xFFF          # 12 bits, bits 0-11
Instagram 是:
shard_id   = (snowflake >> 10) & 0x1FFF  # 13 bits, bits 10-22
sequence   = snowflake & 0x3FF          # 10 bits, bits 0-9
位布局一动,移位就跟着动。把 Discord 的 (>>22, >>17, >>12, & 0xFFF) 写死的解码器,换到 Twitter、Instagram 或 Sonyflake 上会静默给出错误的 worker 和错误的 sequence。Snowflake / Discord ID 位字段解码器在六个预设之间复用同一个 Rust/SQL/JS 风格的位字段解析器:解析开始时先读出该平台每个字段的位宽,再为每个字段发出统一的 (field_offset, field_width, field_mask) 三元组。
分片计算是另一个可选步骤,只有你提供 shardCount 时才会跑。Discord 官方的分片路由用 bucket = (snowflake >> 22) % shardCount:对 ID 本身做桶化,不对解出来的时间戳做桶化,路由靠按位归约而不是看日期。解码器会把 bucket = (snowflake >> 22) % shardCount 与 worker/process/increment 一起报出来,你能看到查询这一刻哪个分片「拥有」这个 ID。网关正是用这套计算决定下一个消息事件交给哪个分片进程,它与时间戳块无关:分片路由只关心 64 位整数的靠高位部分。
三个算例:同一个 18 位数字在 Discord、Twitter、Sonyflake 下各解出什么,验证步骤又如何抓出选错平台
仍取 109580041603153152。按 Discord:
(ms_timestamp, worker, process, increment) =
  (1492081348064, 26, 0, 384)
(2017-04-13T11:42:28.064Z, worker_id=26, process_id=0, sequence=384)
按 Twitter(位布局相同,纪元不同):
ms_timestamp = 1492081348064 - (twitter_epoch - discord_epoch) ms
            = 1492081348064 - (discord_epoch has ts 1422748800000 ms, twitter has 1288834974657 ms)
            ⇒ wrong by exactly the epoch delta
按 Sonyflake(布局不同:39 位时间戳按 10 毫秒计,外加 16 位计数器):
(sf_10ms_units, machine_id, counter) =
  (sf_bits >> 24, (sf_bits >> 16) & 0xFF, sf_bits & 0xFFFF)
date = sonyflake_epoch + (sf_10ms_units * 10)ms
同一个 18 位十进制数字,按三套位布局、三个纪元解析,得到三个不同的日期,而对任何一个具体系统来说只有其中一个是正确答案。平台与位布局对不上时,解码器不会报警,它输出的就是你所选预设声称的结果。
拿外部时间戳源核对解出的日期,是发现平台选错的唯一办法
验证的办法是把推断出的日期与外部时间戳源对一下:Discord 的 MESSAGE_CREATE 网关事件里的消息时间、Twitter Snowflake 响应载荷里的推文创建时间、Mastodon 的 status.created_at 里的发帖时间。如果推断日期与外部时间戳的差距超过一个分辨率刻度(Discord/Twitter/Mastodon 为 1 毫秒,Sonyflake 为 10 毫秒,Instagram 为 1 秒),平台判断就是错的:这个 ID 由某个平台生成,而你所选预设的位布局与纪元跟它并不匹配。修法要么换一个预设,要么建一套与真实系统相符的自定义配置。
实际最常见的错配有两种。Discord ID 用 Mastodon 预设解析(它用的是 Twitter 纪元),报出来的时间戳会晚 4 到 5 年左右。Instagram ID 用 Discord 预设解析,报出来的时间戳会落在 Unix 纪元之前的若干毫秒,因为 Instagram 的纪元是 2011-01-01T00:00:00Z,而它的 41 位块存的是 2011 年以来的秒数,不是 2015 年以来的毫秒数。见过一次这类错配之后,通常光看时间戳的量级就能判断平台;但如果平台未知或为私有方案,自定义配置才是正解。
什么情况下只有自定义配置能用
六个默认预设覆盖的是有公开文档的平台。每家公司的内部 Snowflake 方案都会自选 (timestamp_bits, worker_bits, sequence_bits) 三元组,往往还自选纪元。生产环境里常见的几种自定义形状:
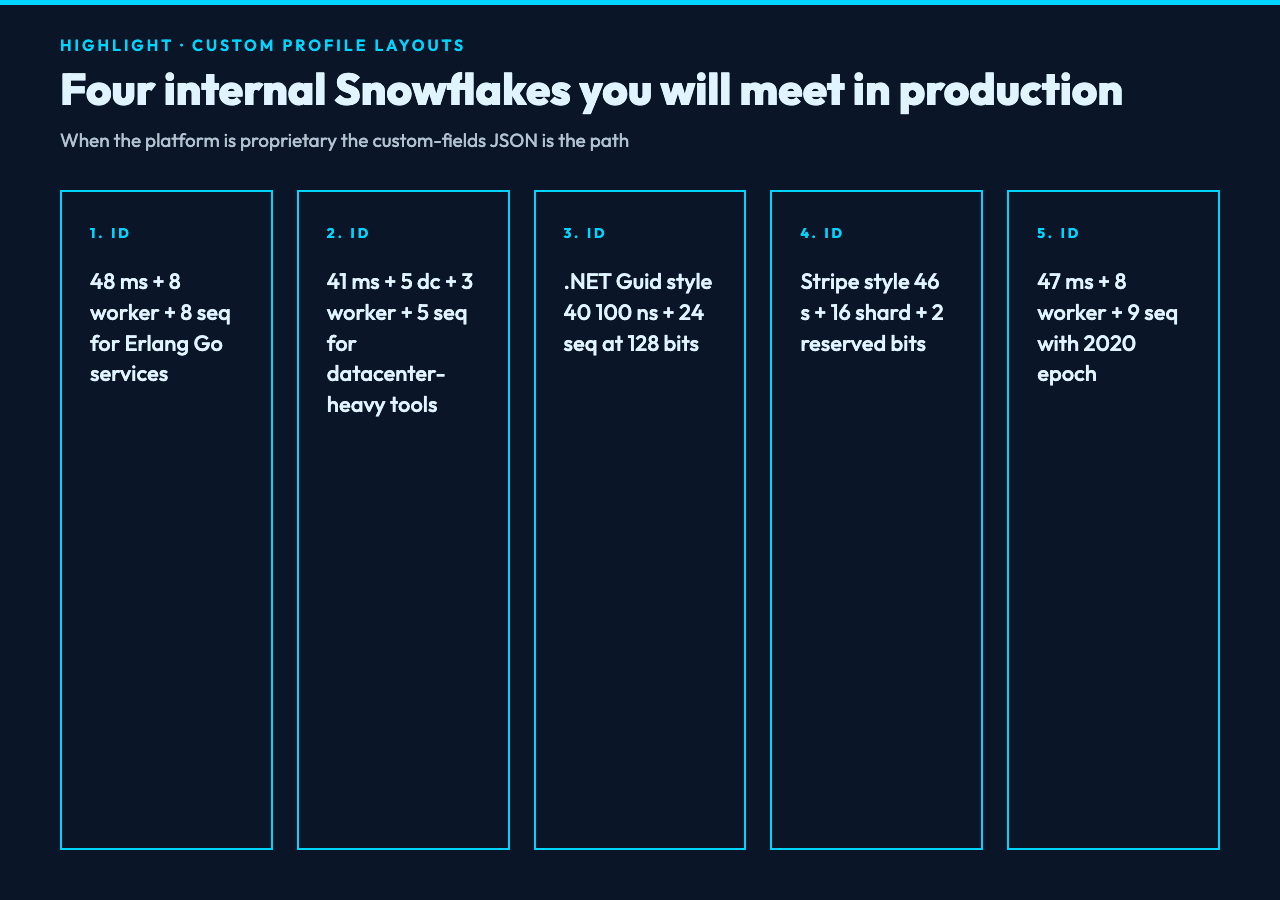
– (48-bit ms timestamp) | (8-bit worker) | (8-bit sequence):若干基于 Erlang/OTP 的系统在用,一些 Go 服务也采用这类受 sonyflake 启发的布局。– (41-bit ms timestamp) | (5-bit datacenter) | (3-bit worker) | (5-bit sequence):多见于较老的 Twitter 内部工具,它们需要比公开的 10 位 machine 槽位更细的数据中心粒度。– (40-bit 100ns timestamp since Windows epoch) | (24-bit sequence):任何用 .NET 的 Guid 生成的系统都是这个布局,只是最终得到的 UUID 结构是 128 位而非 64 位。– (46-bit second-resolution timestamp) | (16-bit shard) | (2-bit reserved):Stripe 风格的内部 ID,秒级分辨率加 16 位分片容量。
解码器的「自定义」预设要求你给出三样东西:位布局,写成 {name, bits} 对象的 JSON 列表(最低位字段在前);时间戳单位(ms/10ms/s);纪元,用 ISO 格式或 Unix 毫秒。若某个内部 Snowflake 是 (47-bit ms timestamp | 8-bit worker | 9-bit sequence)、纪元为 2020-01-01T00:00:00Z,自定义字段 JSON 就是:
[{"name":"sequence","bits":9},{"name":"worker","bits":8},{"name":"timestamp","bits":47}]
解析输出沿用同样的三元组形式:(ts, worker, sequence)。自定义纪元输入既接受 ISO 格式(2020-01-01T00:00:00Z),也接受 Unix 毫秒(1577836800000),两种都在内部归一化成毫秒,逐平台的位字段解析因此不必关心你给的是哪一种。
收尾
一个 Snowflake 解码器必须做的五个决定,即位布局、纪元、时间戳单位、worker 槽位、序列增量,最终合成一个解析三元组:(date, worker, increment)。位布局选错,序列号会冒充 worker;纪元选错,日期会落到公元 48,817 年或 1970 年;时间戳单位选错,日期会差出 1000 倍。解码器把六个规范平台固化在一个解析器里,其余布局交给自定义配置去描述。
想把这些失败模式摆在一起看,Snowflake / Discord ID 位字段解码器会把同一个 18 位数字 109580041603153152 在 Discord、Twitter、Mastodon、Sonyflake、Instagram 和一版自定义配置下依次跑一遍,并列打印解出的时间戳、worker/process 槽位、序列号和分片桶。每个输出背后的算术,与任何运行时 ID 生成库内部做的事完全一样;区别在于你能一次看到全部结果,从中挑出与你正在排查的系统相符的那一个。
想找更多把原始二进制布局翻译成可检查数值输出的工具,Elysia Tools 工具集收录了完整清单。
