
基于规则的术语审计并不读你的文档。它拿一份固定规则逐行比对,行数有多少,报告就有多吵。我让术语表一致性审计器(Terminology & Glossary Consistency Auditor)跑过二十行开发者文档,术语表三条,禁用词两个,回来 31 条发现。其中 5 条说的问题确实值得改,3 条指向一个全大写的小节标题,还有 3 条把某个术语的正确拼法判成了它自己的违规。
这个比例说不上是缺陷报告。它是一类检查器的代价:每条判定,你都能向要去改稿的作者解释清楚。
下面这些数字都是我把工具的本地引擎移植成 Python、在同一份输入上跑出来的,所以计数来自规则代码本身,不是读摘要栏读出来的。
引擎数的是行,不是错
本地这一遍就是一个循环,跑 text.split('\n')。每一行依次过禁用词列表、术语对、术语表变体、大小写检查和缩写模式。这个循环里没有任何东西会记住上一行的状态。
缩写分支的代价很直观。它在每一行开头新建一个去重集合,于是一个出现在十七行里的缩写会被当成候选十七次。我的样本里 SDK 出现在十七行,就收了十七条 info,每条消息一模一样,每条都指向同一处缺失的首次展开。
报告按行号排序,严重等级只在同一行内部充当不稳定的次序键。所以我样本里唯一一个真正的错误,也就是第六行上的一个禁用词,夹在两条关于缩写的 info 中间,排在列表第十一条,只能一行行读下去。
三十一条记录,五个问题
下面就是那份二十行文档的完整报告,按每条记录值不值得读分了类。
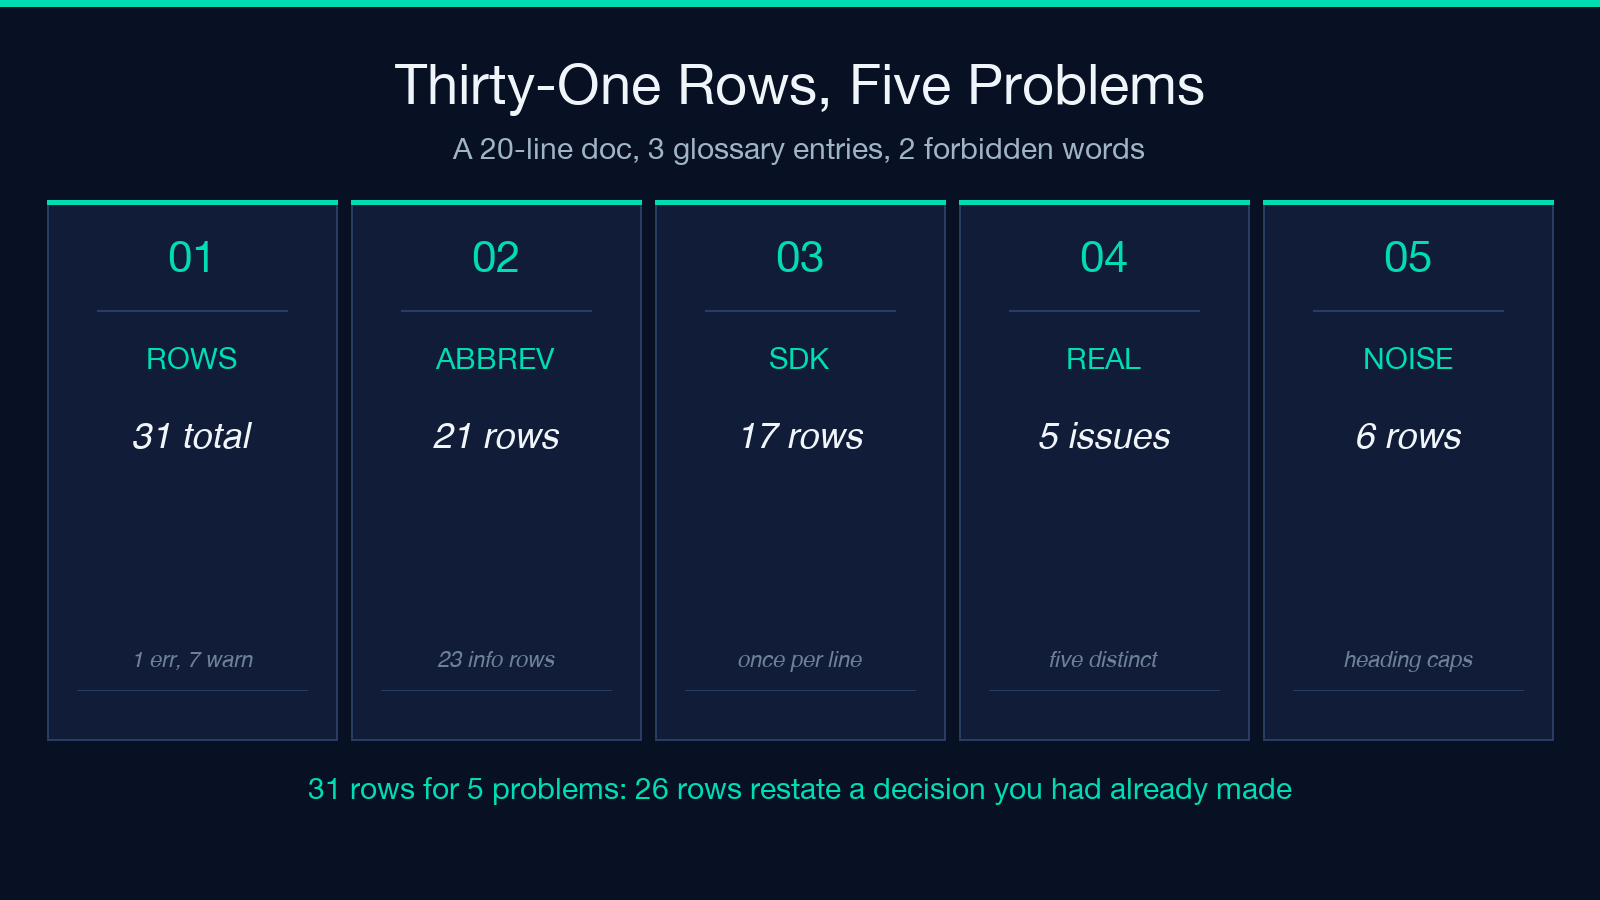
- 共 31 条:1 条 error、7 条 warning、23 条 info
- 21 条缩写记录:SDK 十七次,CI 一次,READ、THIS、FIRST 各一次
- 6 条术语表变体、2 条大小写、1 条禁用词、1 条术语对
- 25 条指向五个真问题:未展开的 SDK、未展开的 CI、“utilize”、小写的“kubernetes”,以及“Github”
- 6 条什么都没指向:三个大写的标题词,还有三条在指控正确拼法写错了
五个问题,三十一条记录,其实五条记录就足以把它们说完。剩下的记录里,二十条重复的是另一行已经报过的同一个 token,六条什么都没指向。于是有 26 条、占报告 84% 的内容,改变不了你在看到第五条时就已经做出的判断。这么吵的报告仍然能用,但它不是一份待办清单,清单得你自己列。术语表一致性审计器,想拿自己的草稿核对我的算术,随时可以。
任何全大写的词都是候选缩写
缩写模式写的是 \b([A-Z]{2,6})\b。这称不上缩写检测器。它检测的是夹在非单词字符之间的任意 2 到 6 个大写字母。喊出来的小节标题正好就是这个形状。
我第一行开头写的是 READ THIS FIRST:,正文还没开始就先出了三条:READ、THIS、FIRST。再怎么整理术语表也挡不住,因为这个标题根本不在术语表系统里,它就是形状对的一串大写字母。
同一个表达式还带出两个性质:
- 检查到六个字符就停。UNESCO 落在窗口里;七个字母的缩写永远不会被检查,展开没展开都不管。
- 硬编码的白名单把你最可能写的缩写直接豁免了。豁免集里有 API、URL、PDF、HTML、ID、IT、OK、CPU、RAM、USA、UK 和 EU。我喂了四行,分别用 API、URL、PDF 和 SKU,回来的只有 JSON 和 SKU,JSON 跟缩写毫无关系。
这份豁免名单站得住脚,没人需要别人提醒去展开 API。问题在于它的沉默意味着什么。API 没出记录,和一个已经正确展开的缩写没出记录,在输出里长得一模一样,所以“没有记录”永远不能告诉你有一项检查跑过并且通过了。
一个词,两条记录
规则之间会重叠,而重叠的结果没人合并。“utilize”既在我的禁用词列表里,又被声明为“use”的变体,于是第六行上一次出现就出了两条:一条来自禁用词检查的 error,一条来自术语对检查的 warning。
术语表对自己也一样。一个小写的 github 先匹配变体“github”,再不分大小写匹配变体“Github”,最后在跟规范形式“GitHub”做大小写比较时又失败,一个错词三条记录。
固定规则看不见的东西
上面这些规则全是机械的,机械恰恰是重点所在:重跑一遍,得到的还是同一张表。它做不到的是把术语放回语法环境里比较;这个缺口在英文之外张得最大。
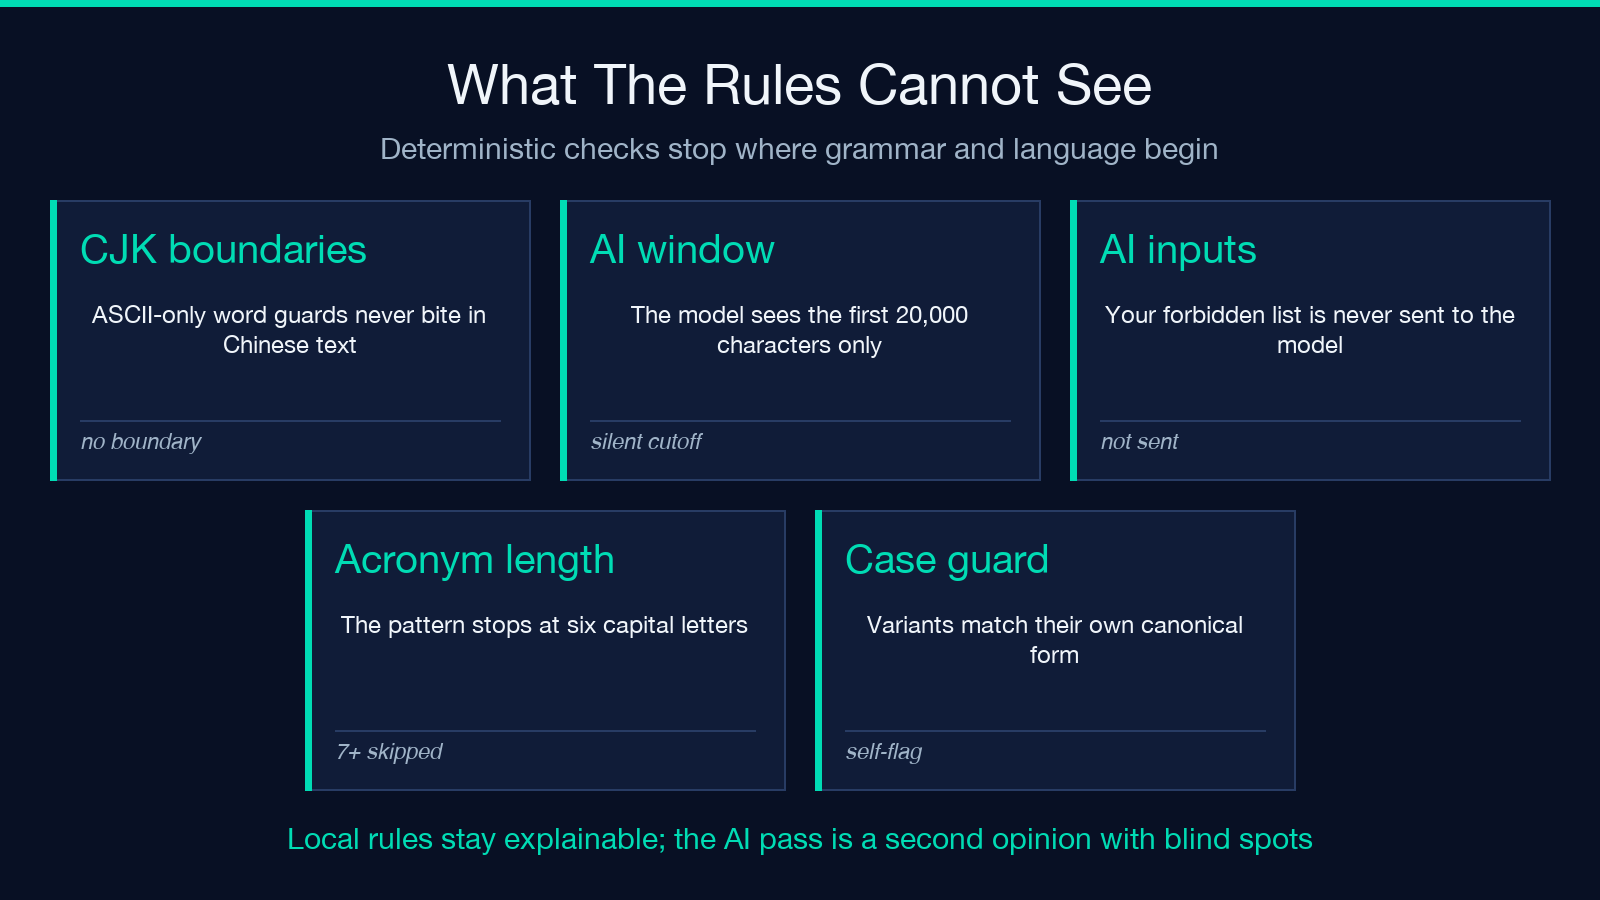
边界守卫写的是 (?<![\w]) 和 (?![\w]);在 JavaScript 里 \w 这个字符类只认 ASCII。到了中文文档里,这些守卫根本咬不住,因为没有任何汉字算作单词字符。我用三行文本做了测试,术语表里写 接口 = 接口层,结果“接口层”被判成不规范术语:一个包含规范术语的更长复合词,被读成了这个术语本身的违规。
然后是可选的 AI 环节。打开以后,你的文本连同规范术语和推荐术语会发给 deepseek/deepseek-v4-flash,让它找规则抓不到的上下文误用。启用之前有两个限制值得知道。文档用 text.slice(0, 20000) 切片,于是本地规则审计到 200,000 字符,AI 只审前 20,000,一份 30,000 字符的草稿送出 67%,剩下的没人看。另外,模型只拿到规范术语和推荐术语,永远收不到禁用词列表,所以它根本没在检查你明确标为禁区的那部分。调用失败时工具会明说,并返回本地结果。
一套能用的复查顺序
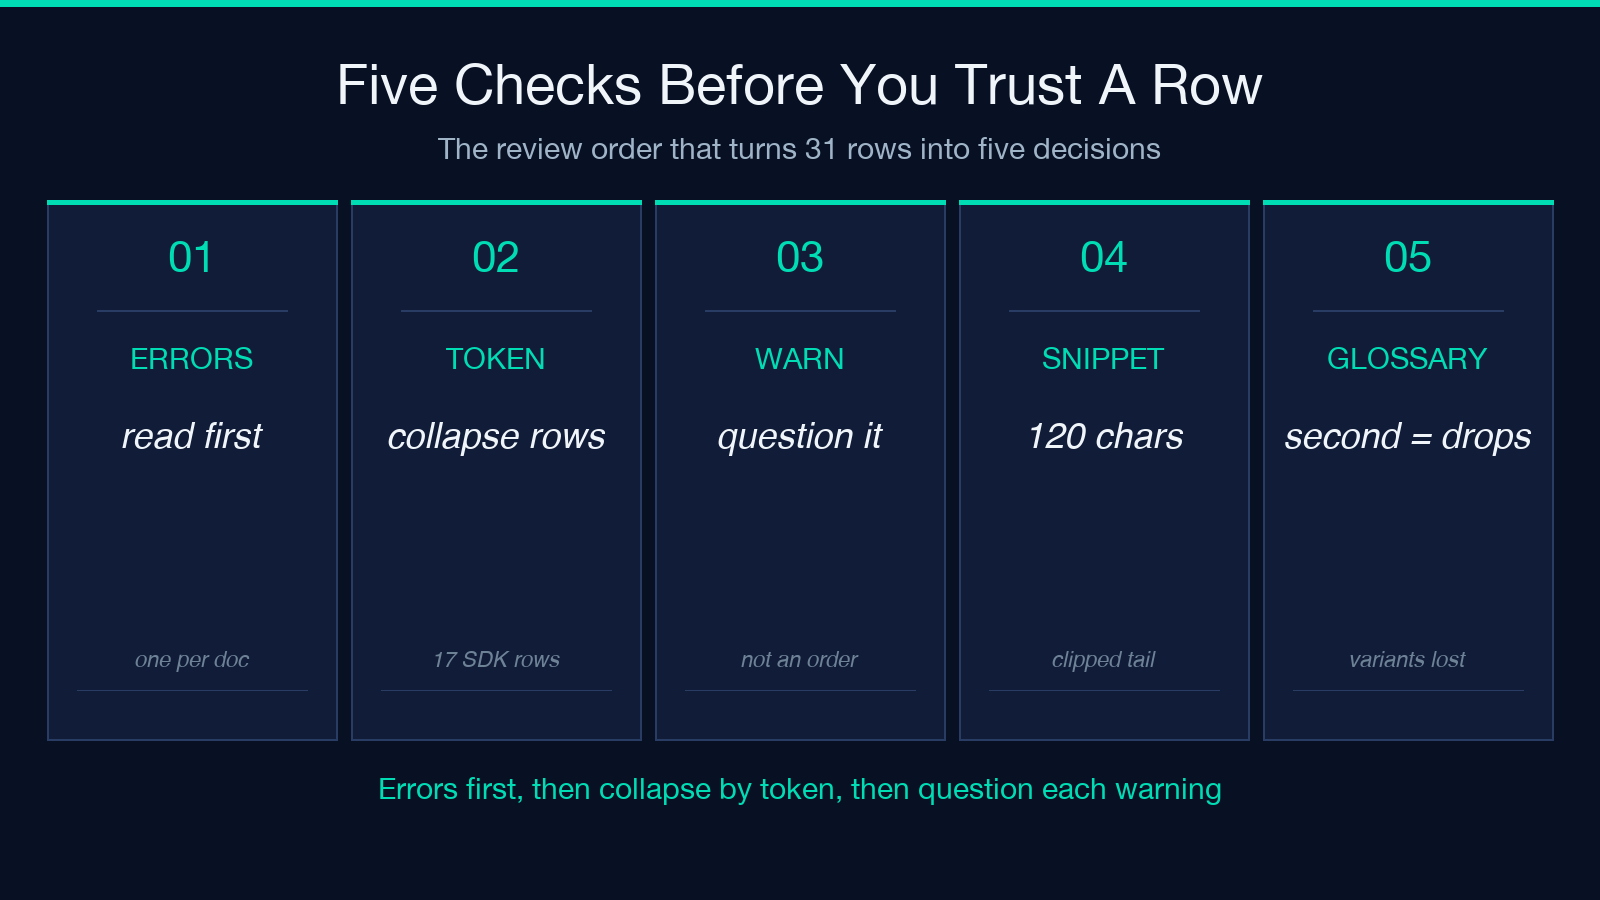
工具给你的是一张按行排好的表。按严重等级重排,再按 token 去重,31 条记录才会变成五个决定;不写代码,三遍就能把清单砍到五个决定。
- 先读 error。“utilize”是那种审稿人一眼就会同意的词。我的样本里只有一条 error。
- 把 info 按 token 合并。十七条 SDK 记录是一个决定:在首次出现处展开一次,或者干脆在心里把它归进豁免集,往下走。消息文本完全相同,用透视表按 token 一拉就完。
- 把每条 warning 当问题看,不要当指令。warning 是工具最自信、也最不可靠的地方,原因见下一节。
这个顺序重要,是因为报告自己的排序正好跟它对着干。按行排会把一个真错误塞进两条缩写记录中间,还会把三条关于标题的记录排在最上面。
你主动接受的取舍
这是一条我没预料到的发现,也是主张认真读 warning、而不是相信 warning 的那条证据。
我的术语表那一行写的是 GitHub = Github, github。变体检查会把每个变体编译成带同样边界守卫的不分大小写模式,于是变体“github”也匹配字符串“GitHub”,也就是术语表要你去用的规范形式。在写着正确拼法的那一行,表里出了两条一模一样的 warning:Non-standard "GitHub" -> "GitHub"。它在让作者把一个词改成它自己。
修法是加一道大小写守卫,把命中结果跟规范字符串比一下,相同就跳过;旁边那个大小写检查本来就这么做。但它对复查的影响是实打实的:31 条记录里有 6 条什么都没指向,其中 3 条在指控正确的文本。作者一旦看出这个模式,就不再信 warning 这一栏,而两个真正的术语问题恰恰藏在这一栏里。所以去掉自我指涉记录的那个修法,换回来的是整栏的可信度。
解析器还在悄悄加码。每一行术语表按 = 或 | 切分,只保留前两部分,于是 Base URL = base url = endpoint root 只登记了一个规范形式和唯一的变体“base url”,“endpoint root”一声不响地被丢掉。你要是写了带第二个 = 的条目,工具审的就是一条你没写过的规则。
相信一条记录之前,再核一遍
四项检查能拦住让我的样本变吵的那几种情况。
- 这条记录的建议改动了什么吗?
Non-standard "GitHub" -> "GitHub"是一条自我取消的指令,一眼就能看出来。 - 被标记的 token 是不是规范形式本身?当一个变体跟它的规范形式只差大小写,两个方向都会触发。
- 出问题的词在摘要里吗?摘要是去掉首尾空白后那一行的前 120 个字符,所以在长段落靠后命中的记录,屏幕上看不到证据。
- 术语表那一行是你想写的那行吗?第二个
=会静悄悄截断变体列表。
这些都不说明工具不好用。它说明工具是确定性的,而确定性正是语言模型给不了的性质:同样的输入,凌晨三点跑也是同样的 31 条记录,也正因如此你才能把它放进 CI,比对两份草稿。看看其余的文本处理工具,设计上的取舍就一目了然:这些是你为了拿到审计痕迹才跑的检查器,不是你为了拿一个意见才跑的审稿人。
开头我说,基于规则的审计之所以有位置,是因为每条判定都能向作者解释。这里我要收回那句暗示,可审计的报告不等于是排好序的报告:这张表只是按行序列出规则在哪里触发,权重一律相同。所以重点不在于你拿到多少条发现。要你在评审会上当众辩护,你会挑哪四条?

Pingback: 31 Findings, 5 Problems, and a Heading in All Caps - COSESAI