
模式提取器只找正则允许它找到的东西,至于你想找什么,它不管。我把「文本提取器」(Text Extractor)背后的六种提取模式移植到 Python,拿二十条短测试串跑了一遍,数出 37 个匹配:6 个邮箱、5 个电话号码、7 个 URL、14 个数字、5 个日期。最难看的结果却不在漏掉的那些里:一个是从事 15 位订单号中间切出来的电话号码,另一个返回成了 0.,小数点还挂着,后面什么都没有。
六种模式,五条写死的正则
工具提供六种提取类型:邮箱、电话、URL、数字、日期,以及自定义。前五种就是一条正则字面量,直接塞进 switch 语句里。只有第六种会现场编译新的正则,也只有那条分支可能出错。
本文大部分内容都从这个分裂里长出来。五条内置正则是源码里的固定字符串,在界面上调不动。你选一个类型,粘一段文本,读它返回的列表;输出质量在你打开页面之前就已经定好了。正则就是合同,合同的边角你从来没同意过。
规模小得可以数清:5 条写死的字面量,1 条调用 new RegExp(customPattern, flags) 的分支,其余参数 0 个配置入口。匹配不到东西时,工具会同时在 result、error 和 message 三个字段里返回 No matches found。匹配到了,就把结果用换行或逗号拼起来,或者去重。无论哪种情况,真正有意思的部分都在上游。可以打开 文本提取器 的在线表单,改一行文本,看计数怎么变。
大小写开关只接在一条分支上
界面上有个复选框叫 Case Sensitive(区分大小写),看上去像个全局设置。
其实不是。看源码,这个变量只被读一次,位置在自定义分支里,由 new RegExp(customPattern, flags) 拿它拼出正则。五条内置字面量各自带着结尾的 /g,根本不读这个变量。提取邮箱时勾上或取消勾选,结果没有任何变化,因为邮箱正则里没有不区分大小写的标志,也没有任何分支会去用它。
这个怪毛病能活下来,是因为它藏得好。每条内置正则的字符组都把大小写两种列上了([a-zA-Z0-9._%+-]),所以关掉大小写折叠,结果看着也对。六种模式里有五种,这个开关只是安慰剂;唯一真正生效的那一种,正则本来就是你自己敲的,你也早就知道该写 [A-Z]。
邮箱正则允许域名以连字符开头
邮箱正则是 [a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}。本地部分还算靠谱,松的是域名:[a-zA-Z0-9.-] 允许点号和连字符出现在域名内任意位置,包括 DNS 规则禁止的那些位置。
例如 a@-bad.com 能匹配,a@b..com 也能,后者连着两个点,中间是个空标签。这两个串都路由不到,邮件服务器走到 RCPT 阶段就会拒绝。提取器把它们交给你时,语气和给真地址时一模一样。
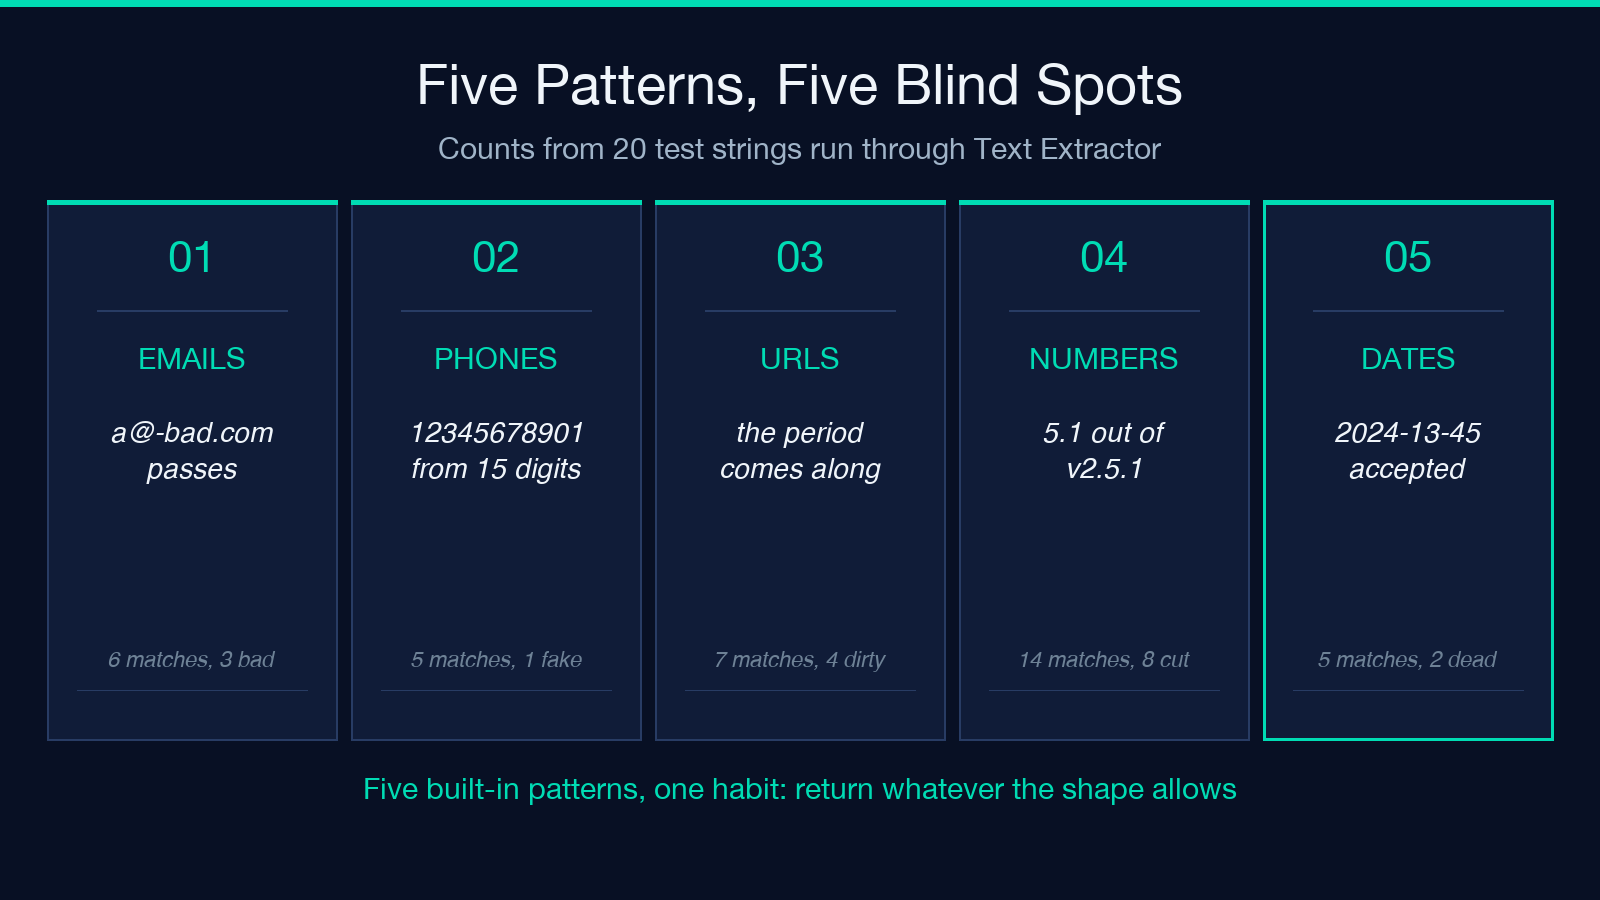
反过来,长得不常见的真地址会被丢掉。user@localhost 什么都不返回,因为正则强制要求一个点和一个两位后缀。Punycode 更惨:ivan@example.xn--p1ai 只回来 ivan@example.xn,在双连字符处被切断,[a-zA-Z]{2,} 跨不进数字。四条测试串一共 6 个匹配,其中 3 个无效或被切坏。这个比例说明了筛子的形状:提取器就是一只带形状的筛子,这只筛子的形状意味着「大致像邮箱」。
电话号码会从更长的数字串里被切出来
电话分支是北美 3-3-4 结构:可选国家码,然后三位、三位、四位,组间可以有括号、点号、空格或连字符。两端都没有词边界。
没有边界,正则就不需要真的碰到电话号码才能找到一个电话号。我喂给它 Order 123456789012345 shipped.:十五位数字,没有分隔符,是个订单号。它返回 12345678901,一个十一位的匹配,从第一个位置开始,数字配额用完就停。十一位的数字在任何拨号方案里都不是电话号码。
落在正则老家范围内的号码过得干净。三种写法完整通过:415.555.0100、(415) 555-0132、+1 415 555 0199,都是整条命中。裸的十位数字串也命中,这既是设计意图,也正是上面那个故障的来源。正则没法把电话号码和碰巧够长的一串数字区分开。
国际号码就落在外面了。比如 +44 20 7946 0958 什么都不返回,因为可选的国家码只认开头的 1。四条串一共 5 个匹配,其中 1 个是从订单号里凭空切出来的。
URL 会连后面的标点一起吞下去
URL 分支并列两种形状:https?:// 后面跟任意一串非空白字符,或者一个裸的 www. 主机名。第一种是贪婪匹配,对「URL 在哪结束」毫无概念。
于是 URL 外面的标点被吃进来。See https://example.com/docs/page.html. 返回的 URL 带着句末的句号。https://example.com/a?b=1). 把右括号和句点都带上了。Markdown 和 HTML 的包装同样如此:行内 Markdown 链接交回来的 URL 挂着右括号,尖括号自动链接交回来的 URL 拖着一个 >。
7 个 URL 匹配里有 4 个至少带了一个不属于 URL 的字符:一个句末句号、一个不配对的括号、两个尖括号。点开就坏;粘到链接检查器里,一个真实存在的页面会报 404。实际做法是在用这个值之前,先把两端的 .,;:)]}>'" 剥掉,只在右括号不配对时才裁掉 )。这条规则得自己写一次,指望不上任何提取器替你想。
数字会丢掉千分位、正负号和小数点
数字正则是 \b\d+\.?\d*\b,读作「数字、可选点号、更多数字,两端由词边界夹住」。干净的十进制小数没问题,一带格式就崩。
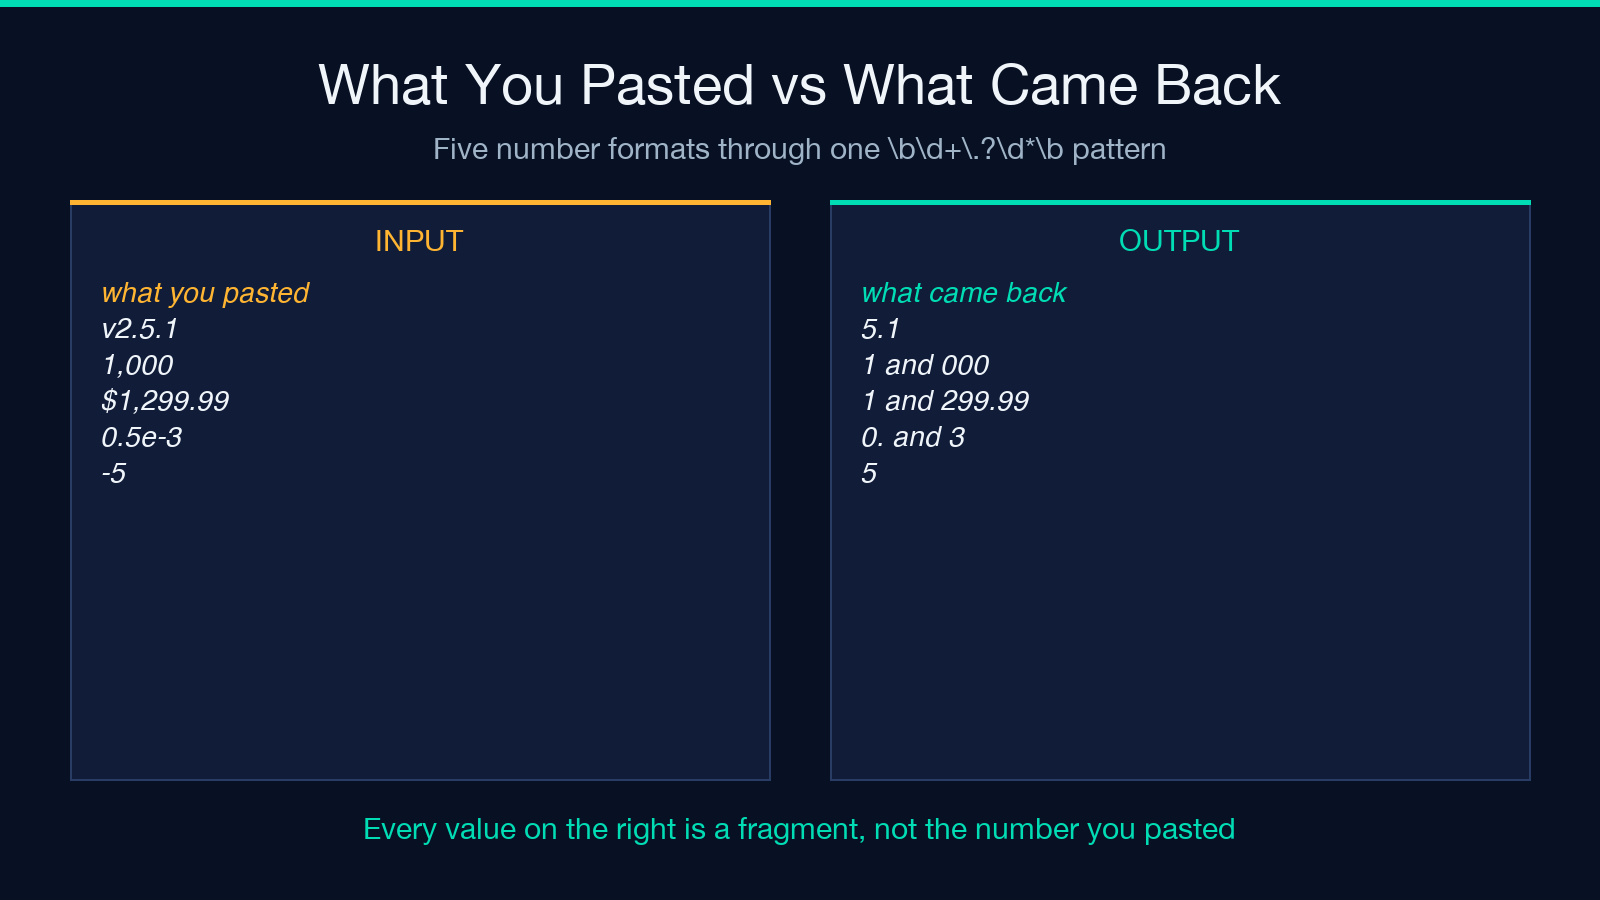
v2.5.1 返回 5.1,2. 再也没回来,因为匹配必须从词边界开始,前面的 v 把首位数字挡住了。1,000 返回两个匹配,1 和 000;$1,299.99 返回 1 加上 299.99,逗号造出一个边界,于是一个金额被拆成碎片。0.5e-3 返回 0. 和 3:正则放弃了指数部分,回溯把小数位退成空,却仍然报出开头的 0.,因为点号算边界,结尾的 \b 也满足了。
四条串共 14 个数字匹配,其中 8 个是更大词元的碎片,6 个是对的。碎片包括:v2.5.1 里的 5.1,1,000 里的 1 和 000,$1,299.99 里的 1,0.5e-3 里的 0. 和 3,1.2.3 里的 1.2 和 3。如果下游拿这一列求和,总数会错,但不报错,也不返回空结果。提取器交上来 14 个匹配,14 这个数看着完全合理。
日期接受 2024-13-45,却拒绝 1.2.3
日期分支尝试两种形状:一到两位数字、分隔符、一到两位数字、分隔符、两到四位数字;或者四位数字、分隔符、一到两位数字、分隔符、一到两位数字。分隔符是 /、- 或 .。
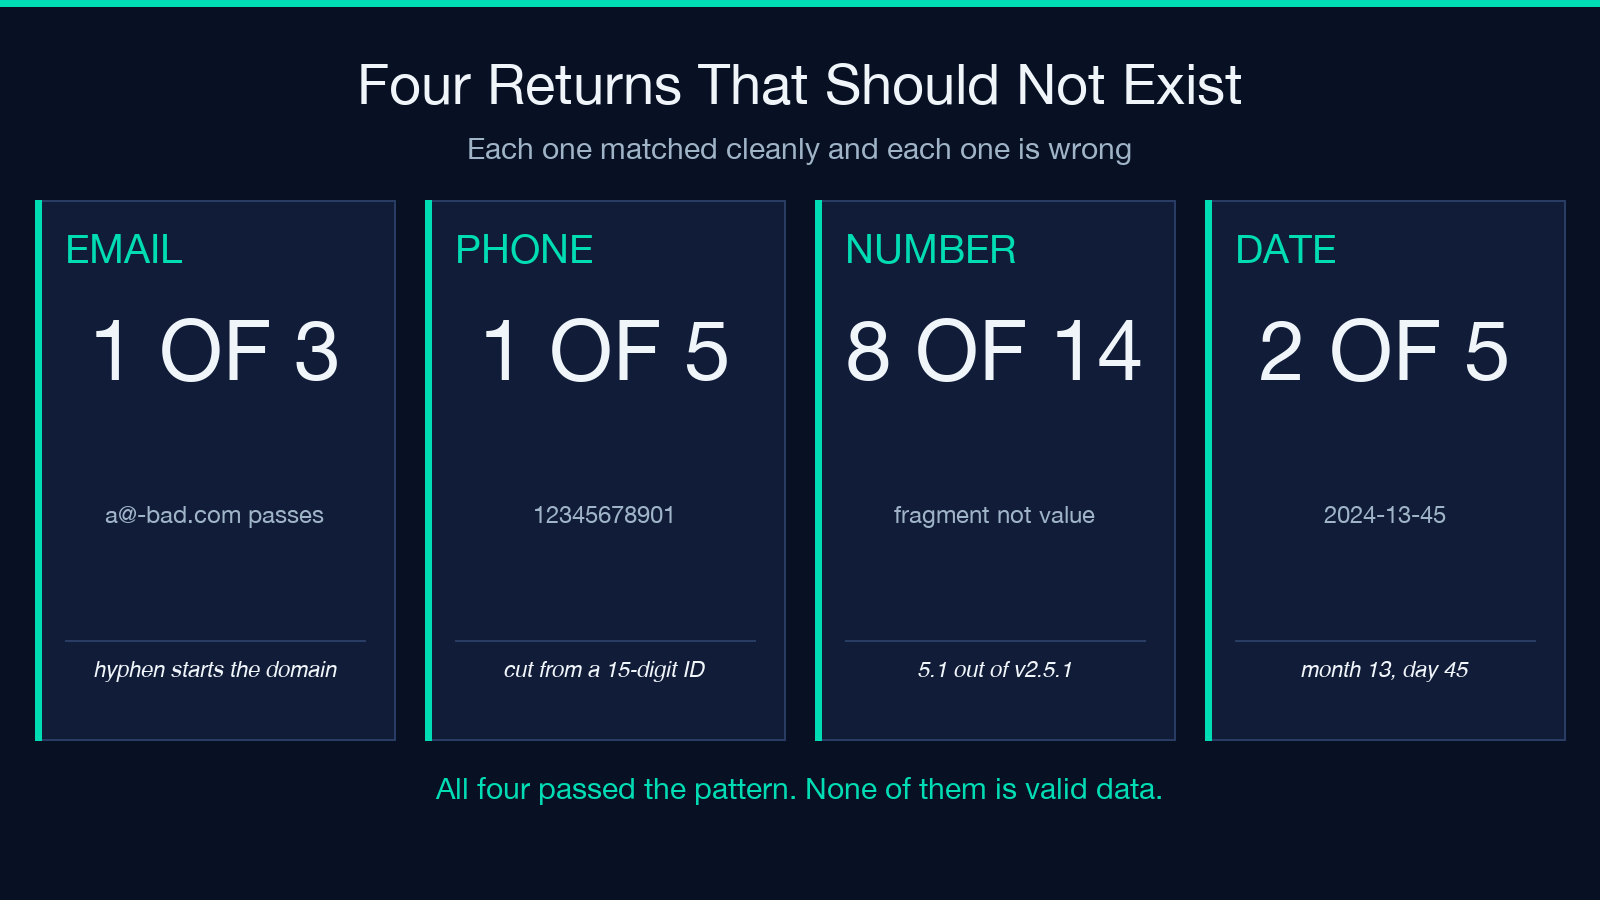
整条正则里没有任何范围检查。2024-13-45 能匹配:十三月,四十五号。99/99/9999 也能。日历解析器会把这两个都拒掉,提取器给它们的地位和 2024-11-21 一样。
反方向的失败更安静。1.2.3 不匹配,虽然它有三个部分,因为最后一组要求至少两位,3 只有一位。含 192.168.0.1 的日志行原样幸存,因为第一组上限是两位;对要从满是 IP 的日志里捞日期的人来说是好事,不过这是运气,不是设计。11.21.2024 匹配,同一个值写成 1.2.2024 就不匹配。5 个日期匹配里有 2 个是不可能存在的日期:2024-13-45 和 99/99/9999。这条正则证明的只是个数分隔符的计数器,不是日历。
把匹配列表当证据,别当数据
注意看计数模式:它把 Found 3 matches 同时写进 result、error 和 message 三个字段。调用方如果认为 error 非空就是失败,就会把一次成功的运行报成失败。这事不大,直到它躺在某个凌晨三点会给人打寻呼的定时任务里。
那么,一个六种模式各自带已知盲区的提取器,该怎么用?拿它看,别拿它定。文本跑一遍,读计数,再逐条读匹配。计数为零,原因在正则,不在文本。计数很高、值又怪,先怀疑边界,别怀疑数据。凡是要进数据库、进求和、进账单行的,把提取这一步换成解析器或校验器:代码知道日期必须在日历上存在,电话号码得有说得过去的长度。任何提取器背后都该有两道检查:每个字段一条长度规则,每个日期列一次日历校验。
我没有测试界面渲染,Python 移植版在正则的边角上也难免和 JavaScript 引擎有出入。我是读工具源码、把同样的正则拿去跑固定字符串来测行为的,六种模式里五种背后是同一套形状;这些计数在给定输入上可复现,但不是真实流量的统计。在把它指向一份你在乎的表格之前,先去 文本提取器 看这个工具,再到 工具目录 翻一翻。
这并不是在说这些正则写得多草率。每一条都是合理的第一猜测,工具也老实承认自己是文本提取器,不是数据解析器。要说的是:匹配只是字符上的巧合。2024-13-45 是个漂亮的匹配,也是个不存在的日期;12345678901 是完美的十一位数字串,也是没人用的电话号码。模式提取器不知道邮箱是什么,它只知道邮箱长什么样。所以当下一列数据带着逗号到货时,会发生什么?

Pingback: Why Your Text Extractor Returned 6 Emails and 3 That Bounce - COSESAI