
利用率一样,队列不是同一个。两家诊所的排班利用率都是 80%。两个服务台的那家,71.11% 到诊的病人要在候诊室坐下等。十六个服务台的那家,服务率相同,仪表盘上印的也是 0.80,这个比例是 30.49%,平均等待还短 18.6 倍。利用率是你能盯着的数,等待是到诊的人亲身经历的处境。两者不是同一个数字,中间的差距也不是四舍五入的误差。
三个输入,和一个把其中一个藏起来的比值
M/M/c 队列吃进三个数:到达率 λ、单个服务台的服务率 μ、服务台数量 c,其余全部是推导出来的。通达量 a = λ/μ,单位是爱尔兰(erlang),意思是如果你的流量完全均匀地到达,平均会占用几个服务台。每台利用率 ρ = a/c,是一个服务台忙的时间占比。把这三个输入压成 ρ,仪表盘就只显示一个数,同时把决定队列的另外两个数藏起来。
麻烦在这儿:ρ 是两个输入的比值,再除以第三个输入,所以有无穷多个系统共享同一个 ρ。三个柜员、λ = 6/小时、μ = 3/小时的银行,通达量 2 爱尔兰,ρ = 0.6667;八个柜员、每小时接待 16 位顾客的银行,也是这个数。两者的队列行为完全不同,差异只有在你不再盯着利用率之后才看得见。
想在套公式之前先玩一玩这几个输入,M/M/c 多服务台排队计算器直接收 λ、μ、c,把下面所有指标都打出来。
同一个 0.80,相差十八倍
把利用率钉在 0.80,μ 钉在每小时 5,然后加服务台。ρ 固定,λ 就得随 c 一起涨,系统在同样的忙碌比例下吸收更多到达。
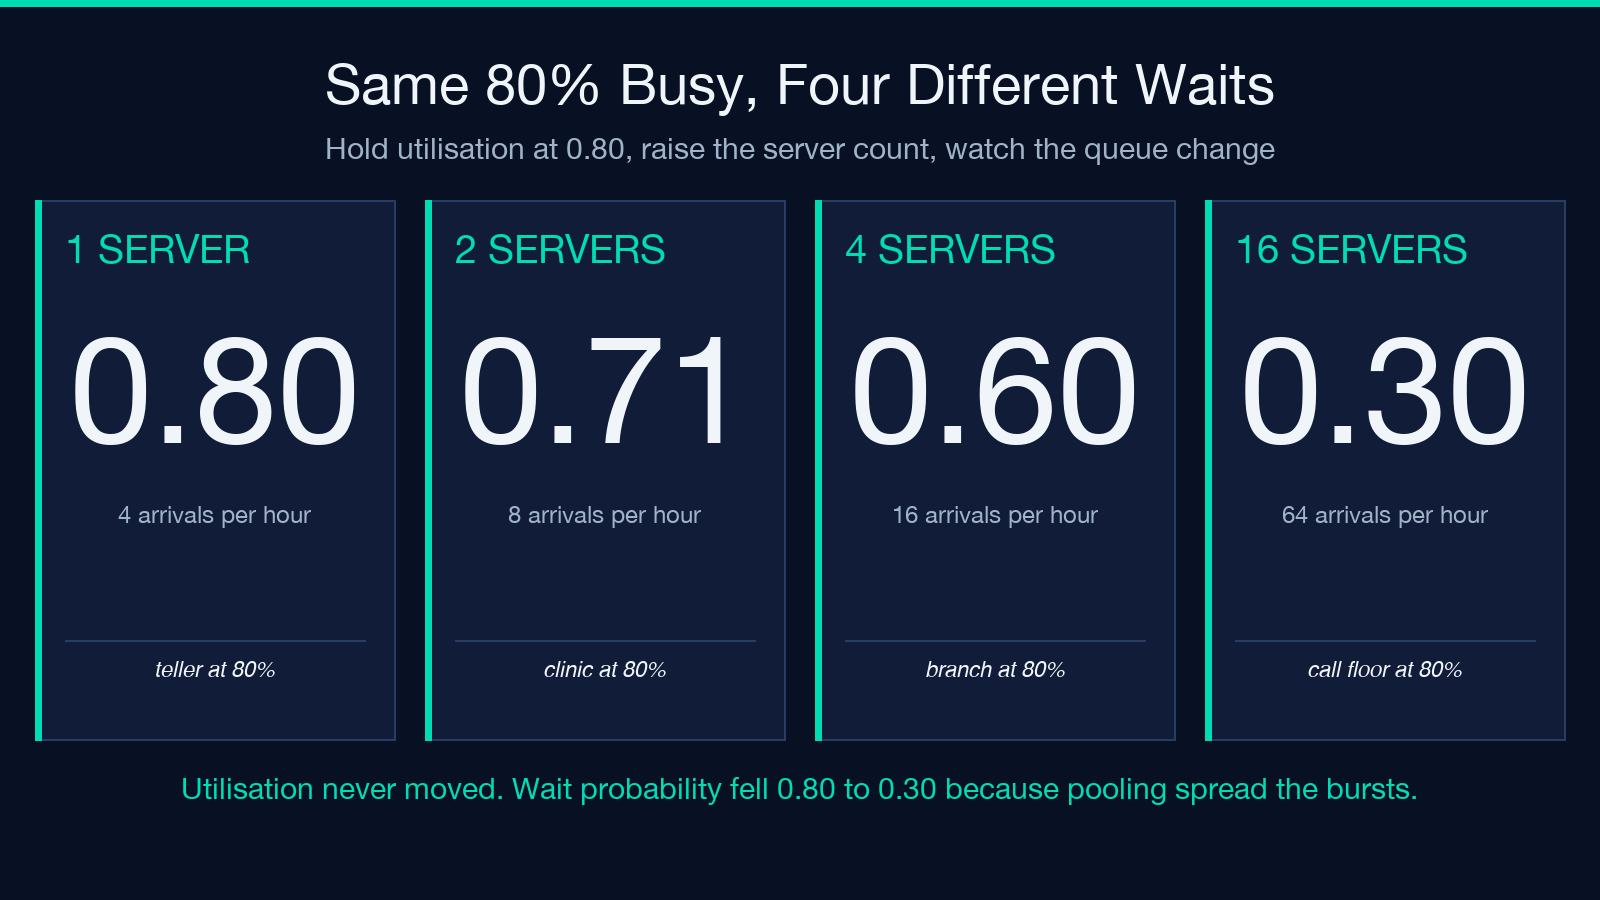
- c = 1,λ = 4/小时:等待概率 0.8000,期望队长 3.2000,期望等待 0.8000 个时间单位
- c = 2,λ = 8/小时:等待概率 0.7111,期望队长 2.8444,期望等待 0.3556
- c = 4,λ = 16/小时:等待概率 0.5964,期望队长 2.3857,期望等待 0.1491
- c = 8,λ = 32/小时:等待概率 0.4576,期望队长 1.8306,期望等待 0.0572
- c = 16,λ = 64/小时:等待概率 0.3049,期望队长 1.2195,期望等待 0.0191
中间这一列读两遍。加服务台的同时,队列里的期望人数在下降,尽管流经系统的流量涨了十六倍。绝对意义上的队伍更短,每小时接待的到达却是十六倍。
机制不神秘,一次对比就能看出来。一个服务台时,每来一阵两个到达,其中一个就得等满一个服务时间。十六个服务台时,两个到达撞见十四个空闲台,谁都不用等。池化把随机性摊到更多容量上,等待概率因此下降,平均忙碌比例一动没动。
一遍算出 Erlang-C,再加一道查错的校验
先算空闲概率,等待概率建在它上面:
P0 = 1 / [ sum(n=0..c-1) a^n / n! + a^c / (c! (1 - rho)) ]
接着,Erlang-C 给出一个到达必须等待的概率 Pw = P0 * a^c / (c! (1 - rho)),队列指标由它推出:Lq = Pw * rho / (1 - rho),L = Lq + a,W = L / lambda,Wq = Lq / lambda。
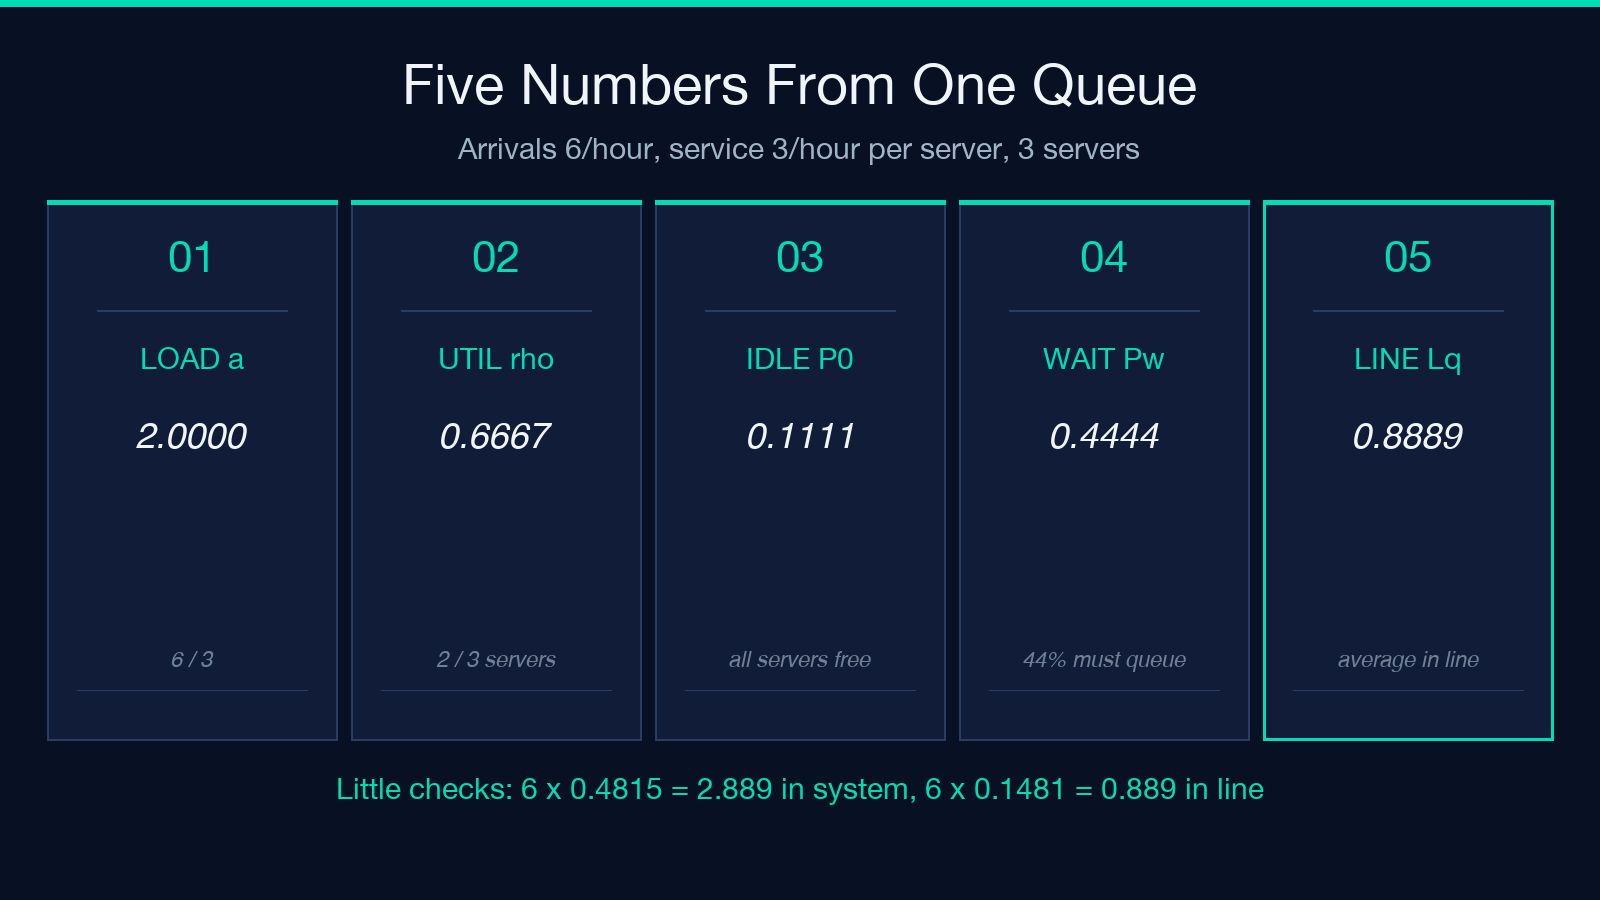
拿那家经典银行举例:λ = 6/小时,μ = 3/小时,c = 3。通达量 a = 2,利用率 ρ = 0.6667,空闲概率 P0 = 0.1111。Erlang-C 给出 Pw = 0.4444,全部到达里不到一半需要排队。队伍平均 Lq = 0.8889 人,系统里一共 L = 2.8889 人,每位顾客在网点里花 W = 0.4815 个时间单位,其中 Wq = 0.1481 是纯粹的等待。
现在用几乎能抓住任何算术错误的那道校验:利特尔法则(Little’s law),L = λ·W,Lq = λ·Wq。M/M/c 多服务台排队计算器把两个乘积和队长并排打出来,比对照一眼就行,不用另开一张表。这里 6 × 0.4815 = 2.889,6 × 0.1481 = 0.889,正好复现由时间推出的两个队长。两个乘积与 Lq、L 一旦对不上,错就在 P0,通常是求和里漏了一项,手工算最容易栽的也正是这一处。
多加一个服务台,变的是形状,不是趋势
抽象的比较不如眼前这个决策要紧。到达率 λ = 8/小时、每位医生服务率 μ = 5/小时的诊所,开两个诊位:ρ = 0.8000,Pw = 0.7111,Lq = 2.8444,Wq = 0.3556 个时间单位。
加一位医生。利用率降到 0.5333,同样的流量等待大幅缩短:等待概率降到 0.2738,队长降到 0.3129,期望等待降到 0.0391,只有原来的 1/9.09。再加一位,Wq 降到 0.0076,但第三台与第四台之间只差约 5 倍,绝对差值已经小到没人在意。
这种不对称才是实用的一课。往拥堵的系统里加第一个服务台,砍掉的是极大量的等待时间;加第四个几乎什么都砍不掉,因为已经没什么可砍。排班评审争论利用率百分比,争的是这条曲线里信息最少的那一端。有用的争论是:几个服务台能把 Wq 压到顾客忍得了的等待之下。
曲线在哪里变陡
固定 c = 4、μ = 5,然后扫到达率。下面每一步都是同一个系统,只是更忙一档:
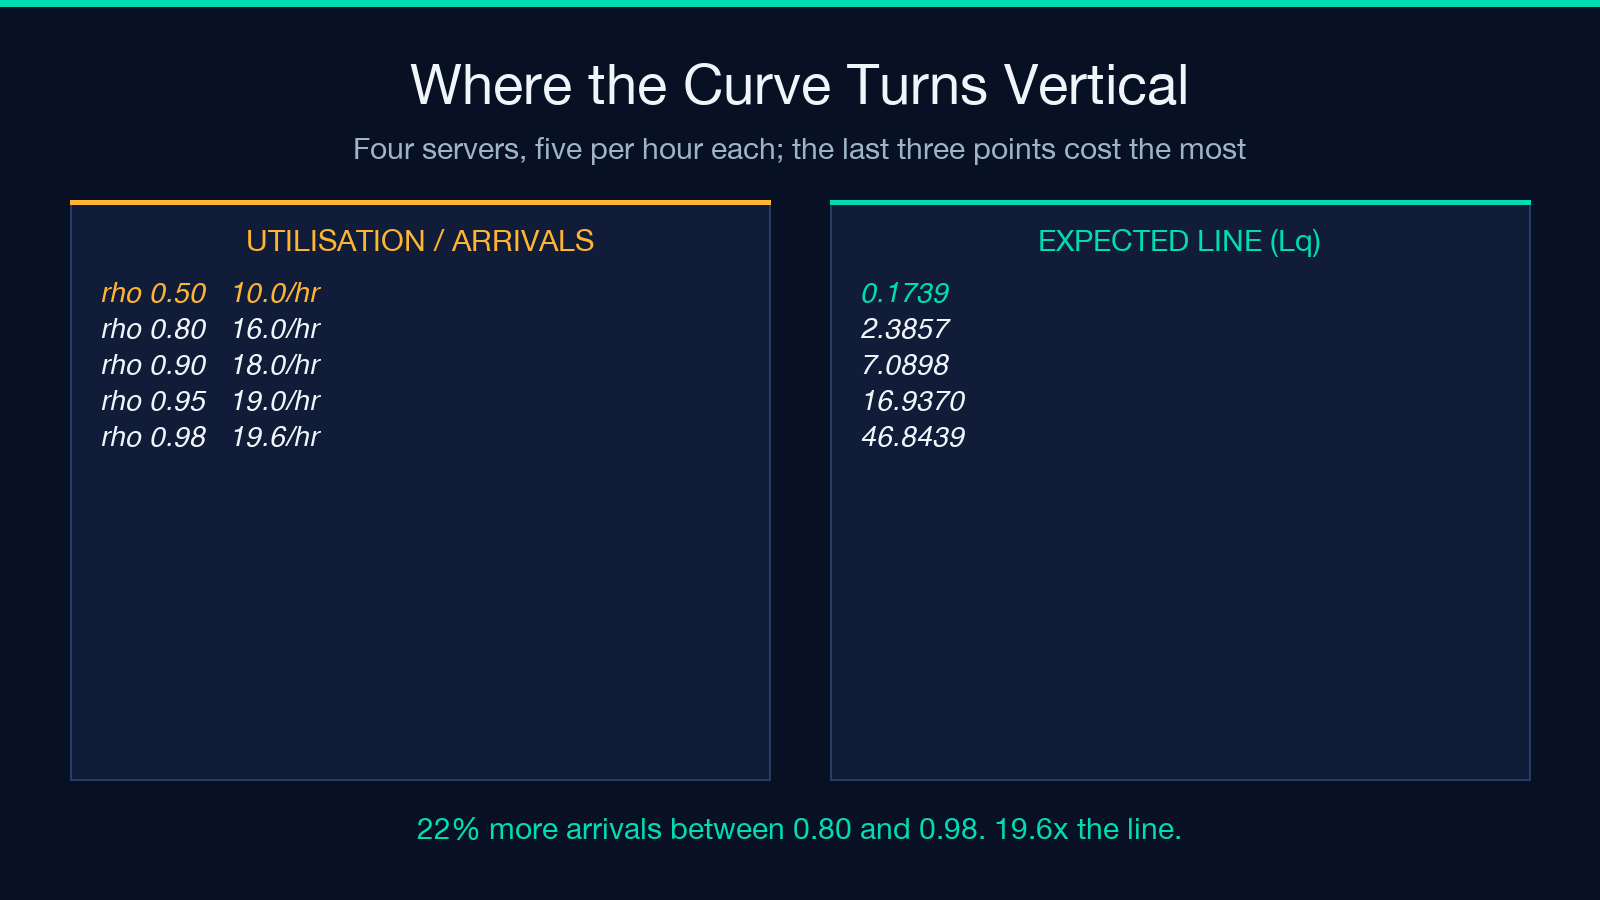
- ρ = 0.50,λ = 10/小时:Lq = 0.1739,Wq = 0.0174
- ρ = 0.70,λ = 14/小时:Lq = 1.0002,Wq = 0.0714
- ρ = 0.80,λ = 16/小时:Lq = 2.3857,Wq = 0.1491
- ρ = 0.90,λ = 18/小时:Lq = 7.0898,Wq = 0.3939
- ρ = 0.95,λ = 19/小时:Lq = 16.9370,Wq = 0.8914
- ρ = 0.98,λ = 19.6/小时:Lq = 46.8439,Wq = 2.3900
从 0.50 到 0.80,三十个点,观测到的队伍涨了 13.7 倍。从 0.80 到 0.90,十个点,涨三倍。从 0.95 到 0.98,三个点的利用率,期望队伍又几乎翻了三倍。最后这三个点的代价比前三十个点还高。
利用率目标为什么会失效,诚实的理由就在这儿:85% 和 90% 听起来是相邻的两套政策,行为上像两种生意,上面的数据就是全部论据。同样加五个点,在曲线一端几乎不要钱,在另一端是灾难;曲线形状取决于 c,所以从服务台数量不同的团队那里搬来的目标,根本算不上目标。
它拒绝的输入,以及拒绝为什么是对的
把上面那家银行按 c = 2 而不是 c = 3 送进去,答案不是一个很大的数,是一句拒绝。λ = 6、μ = 3 时,两个服务台给出 ρ 恰好 1.0,请求被判为不稳定而拒绝:通达量 2.0 对 2 个服务台,附一句说明,队伍会无界增长。
这句以错误而非数字形式给出的拒绝,是工具最有用的地方。本文每条公式都是稳态结果,稳态只在 ρ 严格小于 1 时存在。ρ ≥ 1 时到达快过服务,队列随时间线性无限增长,稳态破了,没有平均值可报。给过载系统印出一个有限等待时间的计算器,是在客气地撒谎;这一位选择拒绝。
输入之前值得知道边界:c 是 1 到 20 的整数,小数位 0 到 8,两个率都必须为正。把高峰时段的一对数贴进 M/M/c 多服务台排队计算器,拒绝会在你来得及争辩之前到达。第一道门后面还有第二道:ρ 离 1 近到任何指标都变成非有限值时,运行被判为数值不稳定并拒绝,要求把两个率拉开一些。ρ = 0.99999 时,1 - rho 这些分母吸收浮点误差的速度已经超过公式承载它的能力,诚实的输出就是没有输出。
模型从没见过的东西
M/M/c 是一个模型,两个 M 是承重假设,不是装饰。
第一个 M 是泊松到达,意思是相邻到达的时间间隔服从指数分布,变异系数正好是 1。真实流量(故障后的客服工单、周一上午的病人、闪购时的订单)成团到来,变异系数远高于 1;故障那一刻是最极端的例子,本文所有等待数字会在那里一起垮掉。到达比泊松更成团,足以把这里每一个等待数字都变成乐观估计。
第二个 M 是指数服务时间,变异系数同样是 1。真实服务通常比这更稳定,服务波动小,队伍就短;在这个方向上,模型偏保守。两个误差推的方向相反,对模型方便,对想知道哪个占上风的人不方便。我手上没有真实的到达轨迹可测,所以没法告诉你你的负载净往哪边偏,只能说两个效应都在。
底下还压着三个假设。顾客在同一条先到先得的队里等,这就是制造出 71% 对 30% 那个差距的池化假设;每个服务台各排一队,好处基本蒸发。没有人中途放弃,所以 Wq 是会留下来的人的等待。服务台完全一样,没有哪个窗口坐着实习生,也没有哪个坐着专家。一周的真实到达数据能告诉你,你的情形离这三条有多远;公式不能。
排班评审上该放什么
评审上有三个数字该放,利用率不在其中。
第一个放等待概率,因为它回答的是顾客亲身经历的那个问题:到底有多少比例的到达排了队。第二个放期望等待 Wq,用你服务级别承诺里写的时间单位。第三个放能把 Wq 压在目标之下的服务台数量。利用率当作事后汇报的输出,不是用来瞄准的旋钮。
然后按每个高峰小时各算一遍,不要按天算。一周平均 60% 的系统,可能每周一有两个小时停在 0.95,平均值描述不了任何一种状态。算每个峰值,不算总量。单个服务台才是诚实的模型时,M/M/1 排队系统计算器是更短的路,数学与数字工具分类页两个都有。
更多工具见 elysiatools.com。
当初我以为利用率是那个安全、保守的数字,想留余量的时候就报它。它不是能单独报出来的数字。百分之八十,是柜员一天里 0.80 的忙碌,是两个服务台下 0.71 的等待概率,是十六个服务台下 0.30,而把这三种结果分开的公式要三个输入,不是一个。所以排班评审一开口就是利用率时,诚实的问题不是这个数高不高,而是哪个服务台数量算出了它?

Pingback: 80% Utilization Is Two Different Queues - COSESAI