
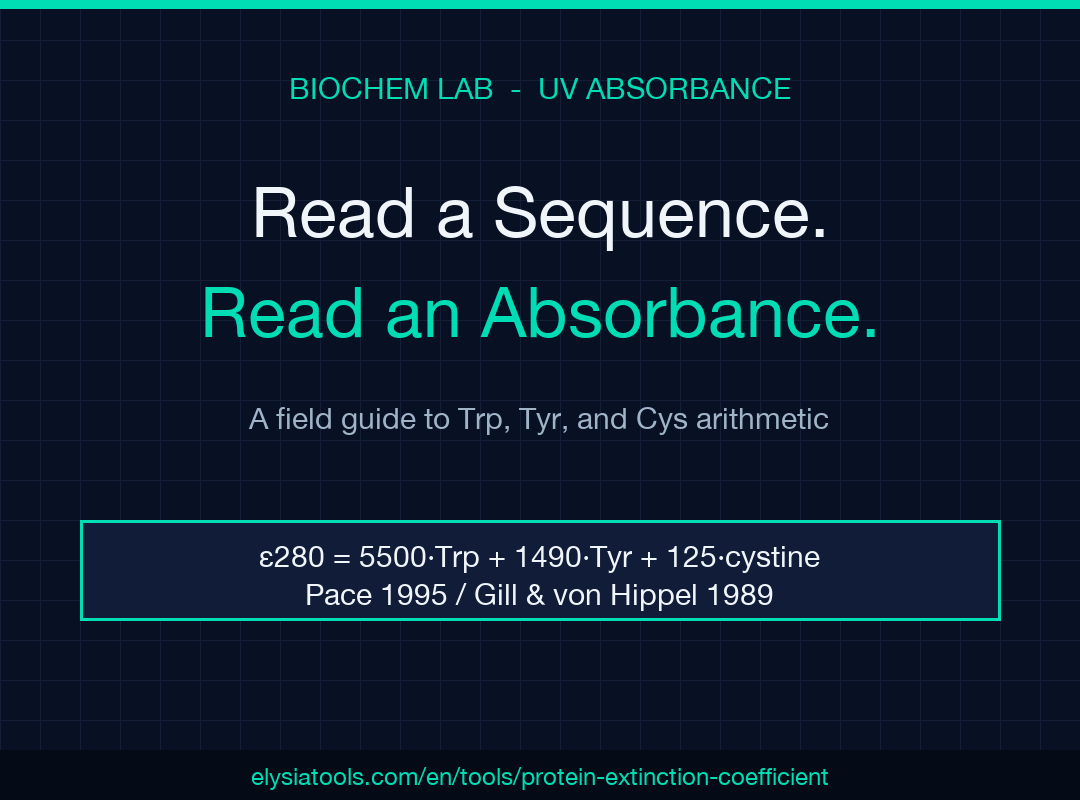
关上分光光度计的比色皿盖,打开序列文件,算术已经做完了。估算一个蛋白质在 280 nm 的摩尔消光系数,过去意味着把残基数目敲进实验记录本的表格,或者在另一个标签页里打开 ExPASy ProtParam 等它加载完。对多数做实验的生物化学工作者来说,这是每天要做十来次的一步,也正因为如此,它不该成为往你的制备里引入噪声的一步。蛋白质消光系数计算器(ε280)吃一条序列,或者吃你手工数出的 Trp、Tyr、Cys 数目,同时给出 Pace 1995 / Gill & von Hippel 1989 系数和实用的 A0.1%,于是你能从 A280 直接落到 mg/mL,不必每次制备都重推一遍数学。
ε280 到底代表什么
蛋白质在 280 nm 的摩尔消光系数写作 ε280,指的是 1 M 溶液在 1 cm 光程下的吸光度。实际上没人配 1 M 的母液,所以实验台上用的是两种派生形式:ε280 本身,单位 M⁻¹cm⁻¹;以及 A0.1%,定义为 1 mg/mL 溶液在 1 cm 比色皿中的吸光度。两者由蛋白质的分子量联系起来:A0.1% = ε280 / MW。拿到其中任何一个,Beer-Lambert 定律就给出 c = A280 / ε280(非 1 cm 的光程要代入光程因子)。实验室默认选 280 nm 而不是 205 nm 或 BCA,图的是省事:芳香族残基在这里吸收强,普通缓冲液不吸收,而且你读的就是马上要上柱的那份样品。
为什么色氨酸主导这个数字
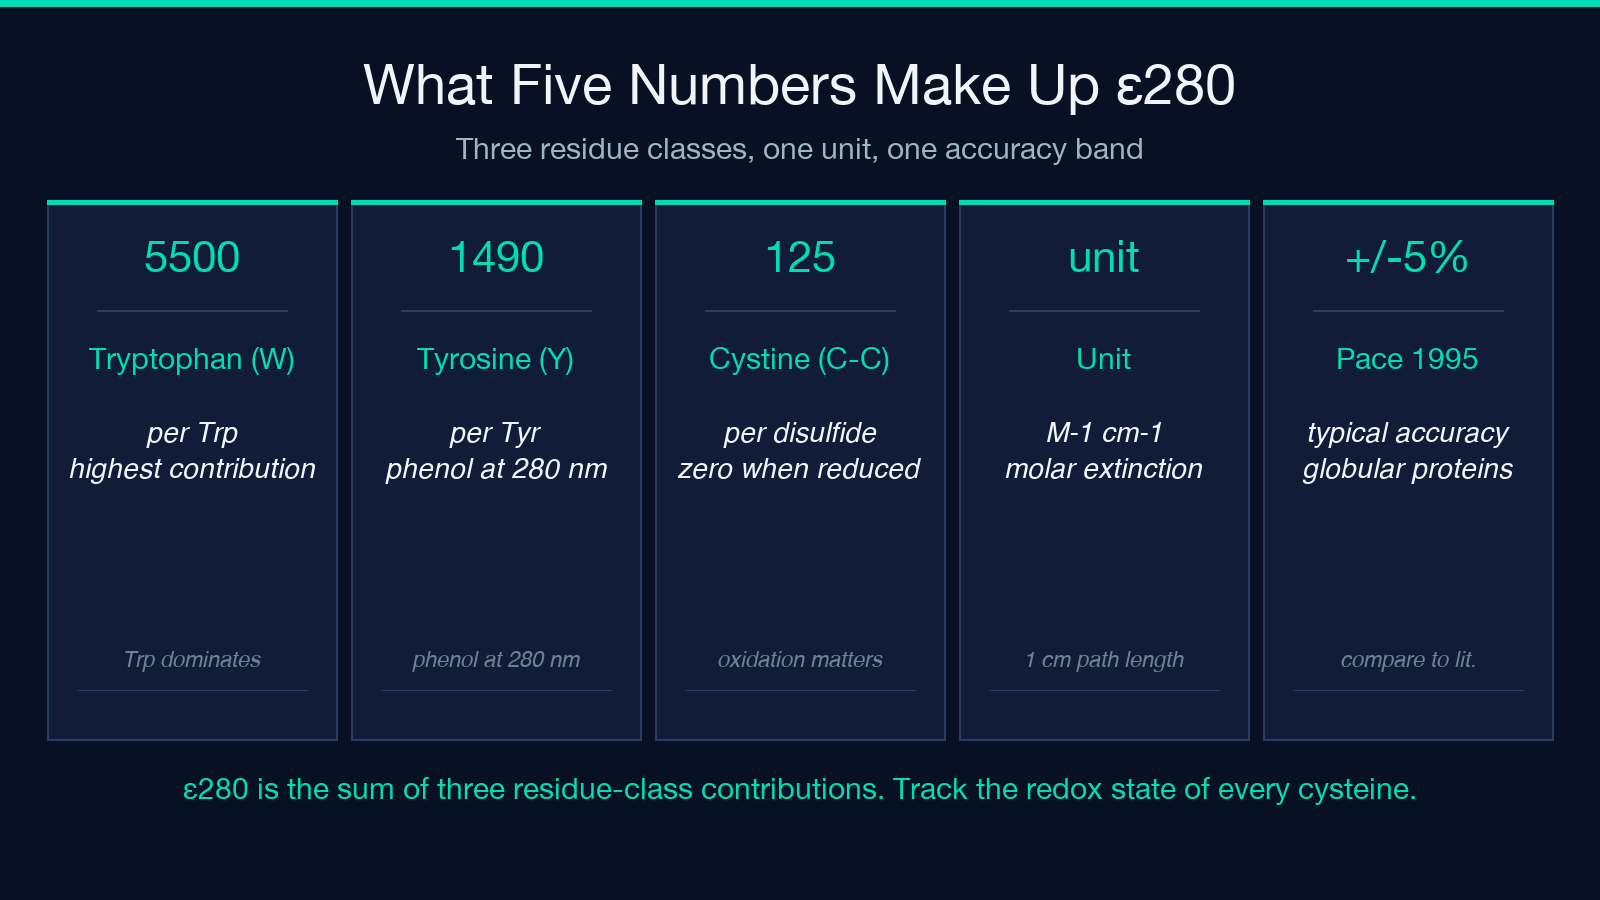
Pace 1995 / Gill & von Hippel 1989 的形式是 ε = 5500·nTrp + 1490·nTyr + 125·ncystine,所有数值单位都是 M⁻¹cm⁻¹。这些系数是每个残基的摩尔贡献:每个色氨酸加 5500,每个酪氨酸加 1490,每对二硫键胱氨酸加 125。色氨酸之所以压倒性,是因为它的吲哚侧链在 280 nm 的吸光度比苯酚高两个数量级。一个 30 kDa 蛋白里的单个 Trp,其贡献就可能超过序列里所有 Tyr 和 Cys 之和。这也解释了为什么抗体这类刻意把色氨酸埋起来以稳定可变域的分子,ε280 出了名的参差不齐,也解释了做 IgG 的实验室为什么常改用 A205 或 BCA。
氧化还原状态会改变答案
半胱氨酸是唯一贡献取决于化学状态的残基。还原型半胱氨酸,也就是游离巯基,对 ε280 没有贡献;只有配成二硫键的胱氨酸(⌊Cys/2⌋ 对)才计入。蛋白质消光系数计算器(ε280)明确给出两个边界:全还原估计和全氧化估计。对多数胞内表达宿主来说,占主导的形式随蛋白和纯化方案而变:用碘乙酰胺在裂解时封住游离巯基的胞质 E. coli 制备会落在还原边界上;折叠正常的 CHO 分泌抗体则落在氧化边界上或略高。不知道自己制备的氧化还原状态时,两个边界之间的差距正好告诉你还有多少容错空间。对一个有八个半胱氨酸的 40 kDa 蛋白,差距可能是百分之几;对一个 12 kDa 的富半胱氨酸骨架,可能到 30% 甚至更多。
A0.1% 告诉你分光光度计会看到什么
A0.1% 是 1 mg/mL 溶液在 1 cm 光程下的吸光度,也就是你稀释到工作浓度后,台式 NanoDrop 或比色皿实际显示的那个读数。不少已发表的方案直接给 A0.1%,省得实验室再算一遍分子量。计算器两种形式都输出,因为对某些流程两种都错,对另一些流程两种都对。如果你的制备特性清楚、你也信自己的消光系数,就用 ε280,让台式机去做算术。如果你照着同一构建、同一制备方式的已发表方案走,就用 A0.1% 在不同制备之间快速核对。
ε280 失效的时候
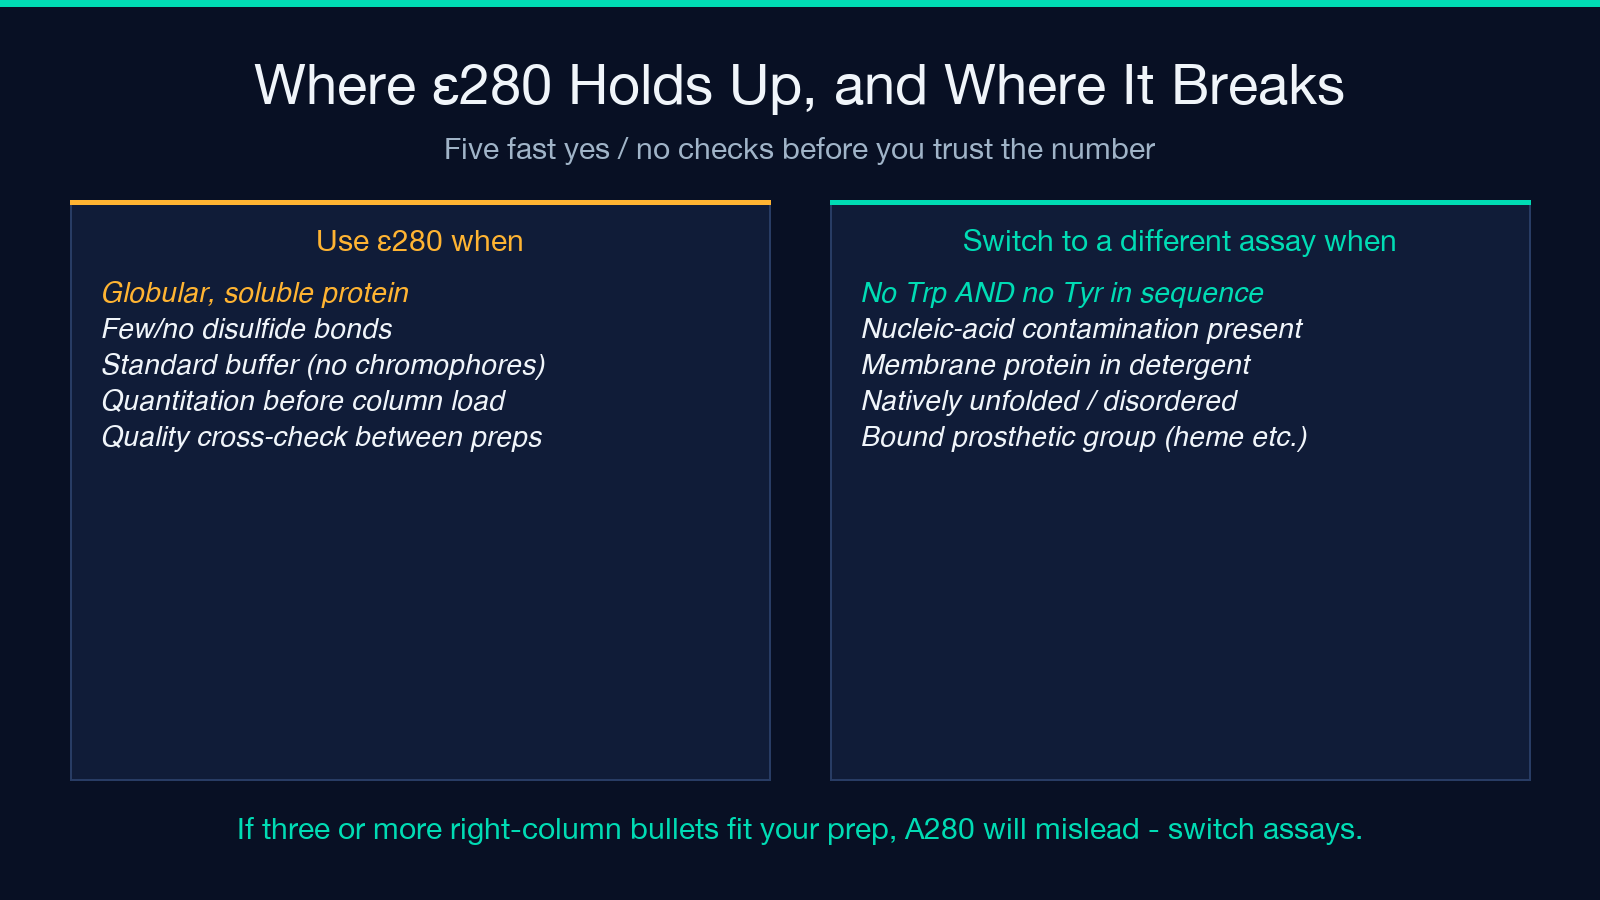
三种常见情况会让这套方法彻底失效。第一,不含 Trp 或 Tyr 的蛋白 ε280 接近零,浓度估计被缓冲液和移液误差主导,改用 A205、BCA 或荧光染料法。第二,核酸污染会通过碱基的吸收抬高 A280,标准校正办法是 Warburg-Christian 公式,减去一个与 A260 成正比的贡献。第三,光程不是 1 cm 的样品(毛细管池、台座式仪器)需要显式的光程因子;计算器覆盖的是标准 1 cm 情形,其他情形得自己乘一个光程标量。这些都不是方法的 bug,是化学本身的性质。
往工具里填什么
两种输入模式覆盖大部分实际流程。序列模式接受单字母序列(20 种标准氨基酸代码,会剥掉 FASTA 头、空白和星号终止符),自动数 W、Y、C,顺带按 ProtParam 平均残基质量算出分子量,所以 A0.1% 不必再单独查一次。残基计数模式接受 Trp、Tyr、Cys 的整数,外加可选的分子量;只掌握序列组成(比如来自同源模型或已发表的晶体结构)且已有分子量时用它。半胱氨酸状态在「全还原」和「全氧化」之间切换。小数位数纯粹是显示问题,底层算术全程双精度。
一个算过的例子
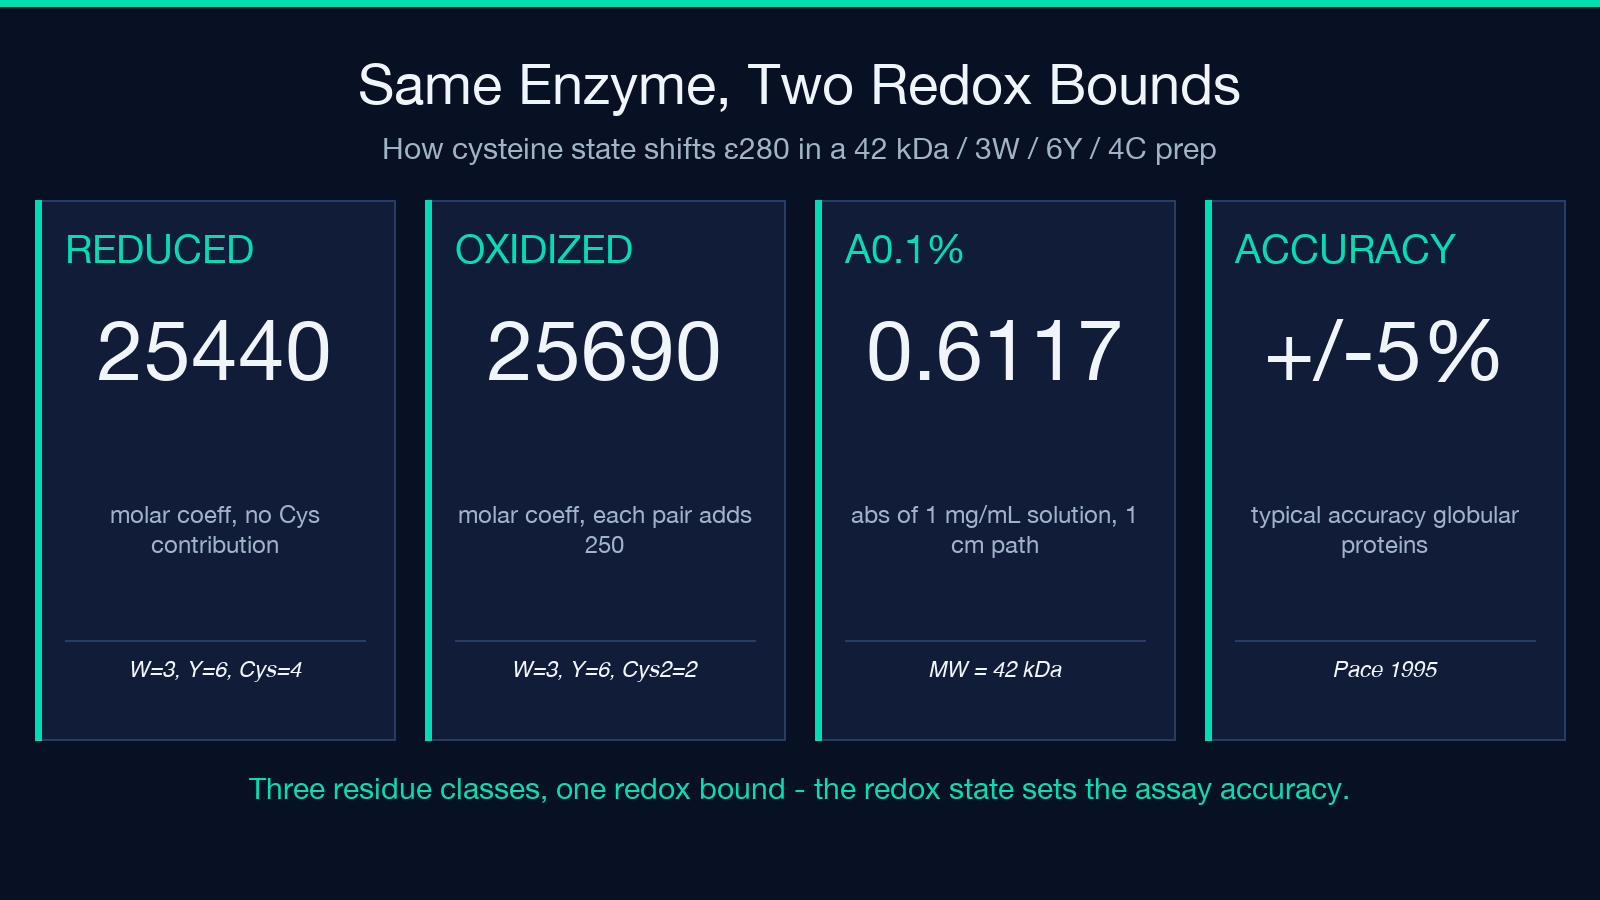
一个 42 kDa 的酶据报含 3 个色氨酸、6 个酪氨酸、4 个半胱氨酸;制备来自胞质 E. coli 表达,裂解时用碘乙酰胺封闭,所以半胱氨酸全是还原态。在残基计数模式下,ε280 还原态 = 5500·3 + 1490·6 + 0 = 25440 M⁻¹cm⁻¹。全氧化态则是 5500·3 + 1490·6 + 2·125 = 25690 M⁻¹cm⁻¹。A0.1% = 25690 / 42000 ≈ 0.61。1 cm 比色皿上读到 A280 = 0.42,浓度就是 c = A280/ε280 ≈ 16.4 µM(≈ 0.69 mg/mL)。用还原边界的 25440 算得 16.5 µM,差 0.6%,远在 Pace 方法典型的 ±5% 之内。
这个数字不是什么
Pace 1995 的 ε280 对性质良好、球状、半胱氨酸少的蛋白,典型准确度是 ±5%。对天然无折叠蛋白、去垢剂里的膜蛋白、带大量含生色团糖链的糖蛋白,或者任何结合了辅基(血红素、黄素、视黄醛)的构建,它都不准。这些样品里,ε280 是有用的合理性检查,不是首要定量手段。计算器的输出会注明背后的假设是 Pace 1995 / Gill & von Hippel 1989,所以你知道自己引用的数字能不能和要对比的文献直接比。
关于实验室里的蛋白定量,更完整的蛋白定量工具专区收着相关的计算器:Bradford、BCA、A260 DNA 浓度、酶动力学,ε280 之后的活还在同一套工具里。更多工具见 elysiatools.com。
