
robots.txt 是站点上唯一一份爬虫会读、会照办、却从不回话的配置。我反复撞见同一种坏法:第 2 行少一个冒号,你写下用来堵 /admin 的那条 Disallow 就无声消失了。没有错误页,没有日志行,只有 200 响应,还有一份任何人打开看都觉得没毛病的文件。问题就出在这份安静上,而它是可以测出来的。
写坏的 Disallow 只会安静失效
写成 Disallow /admin,少了冒号,服务器一言不发。Apache 照常把文件送出去,浏览器照常渲染,你的眼睛照常把它读成一条规则。爬虫的解析器看到的则是一行无法解析的文本,实际结果就是 /admin 依然可抓。
这种失效方式让 robots.txt 和你部署的其他文件都不一样。nginx 配置坏了,流量当场停掉。写坏的 .htaccess 返回 500。写坏的 robots.txt 返回一个完全正常的 200,夹着一堆并不存在的规则;重写文件也救不回解析器根本没看见的东西,唯一知道出了事的只有爬虫,而它从不告诉你。
审查器在这里的职责很窄,也很有用:按解析器的方式把文件读一遍,还要读出声,再把行号交回来。规则被拒时,行号就是你能拿到的全部错误信息。剩下的全靠猜。
解析器判为错误的四种情形
把描述性的话剥掉,错误类型其实不多。四种形态属于硬错误,每一种都落在具体某一行上:
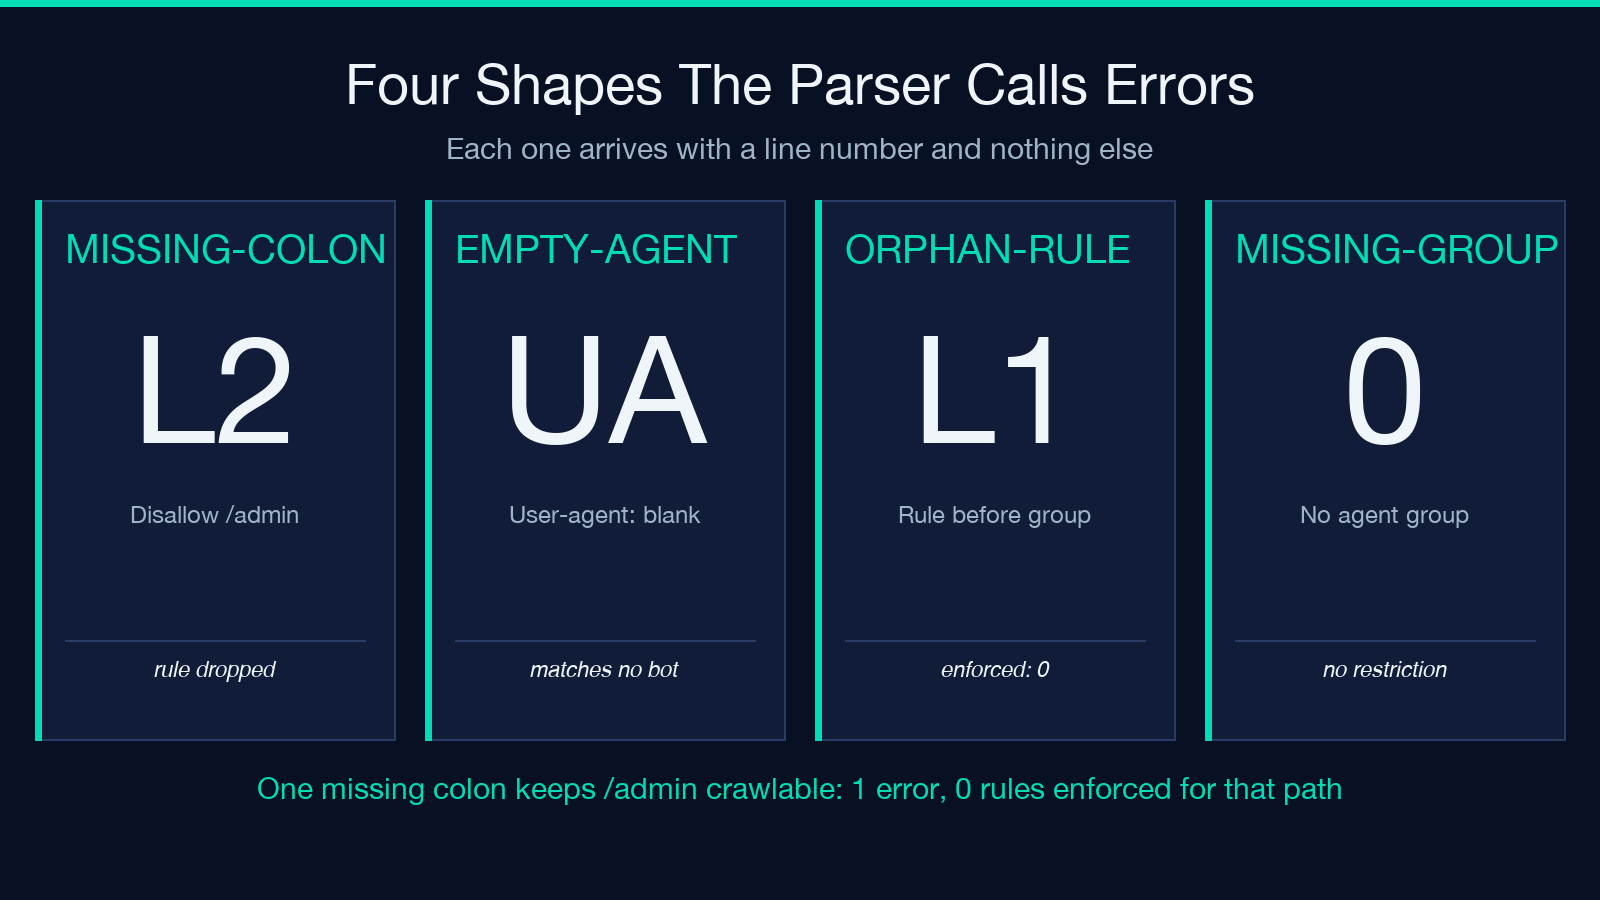
missing-colon:已知指令拼写时漏了冒号,例如Disallow /admin。empty-user-agent:User-agent:后面空空如也,产生一个谁也匹配不上的分组。orphan-rule:Allow或Disallow出现在任何User-agent分组之前。missing-group:整份文件没有任何User-agent分组,与其说是策略,不如说是一行注释。
第一种代价最高,因为它看上去像是有意写的。Disallow /admin 和 Sitemap: 挨在一起,读起来就是一条规则;对解析器来说,这只是一串被跳过的字符。第四种最安静:一份只有 Sitemap: 行的文件,肉眼检查毫无破绽,却什么都没限制,所有路径照旧敞开。有个案例能把代价算清楚:一份 40 行的文件,两条 Sitemap: 记录,没有 User-agent 分组,审查器在第 1 行报 missing-group,实际生效的路径数为零。
跑一遍参考案例,代价就不抽象了:第 2 行 1 个错误,测了 3 条路径,3 条全部放行。那份草稿只有三行,分别是 User-agent: *、Disallow /admin、Allow: /admin/help,本意是把 /admin 挡在索引之外。测试器对 /admin 本身返回放行,而这正是文件想关掉的路径。解析之后唯一活下来的规则,是那条例外。
顺序问题造就了孤立规则这一类。举个例子就清楚:文件开头写 Disallow: /admin,两行之后才声明 User-agent:,审查器在第 1 行报 orphan-rule,后面那个分组对这条路径什么都没执行。连续的 User-agent 行在出现规则之前共享同一个分组,所以 User-agent: Googlebot 紧接着 User-agent: Bingbot 会合成一个带两个代理的分组,共用一套规则。两个爬虫该同等对待时正合适,想让它们区别对待时就是陷阱。
解析器认可的指令只有六个
已知指令集很短:user-agent、allow、disallow、sitemap、crawl-delay、host。其余的都落到低一档,报 unknown-directive 警告,而不是错误。这个区分是诚实,不是宽容。
Clean-param、Request-rate、Noindex 这些指令,总某个地方的某个爬虫会认。Yandex 读 host 和 Clean-param;Bing 对 crawl-delay 有自己的历史。它们都不在 RFC 9309 里,那份 2022 年 9 月发布的标准把通配符和最长匹配的语义定了下来。对着这些指令报错的审查器,在规范上没错,在现实里错了。警告才是合适的说法强度。
还有两条警告值得记牢,各自能消掉一类无声故障。Sitemap: 的值不是绝对 URL 时报 sitemap-format,爬虫要的是 https:// 开头的完整地址,不是一段路径。Allow 或 Disallow 的值不以 / 开头时报 path-format 警告,看着像相对路径的模式几乎都是笔误,不是有意为之。
注意 Sitemap 在这套逻辑里的位置:它是全局收集的,不挂在分组结构下。这一点符合规范,却和大多数人的直觉相反,大家总觉得文件末尾那行 sitemap 属于上面那个分组。它谁也不属于,放哪都行。
两条规则同时命中,较长的那条赢
大家最容易在这一步推错,代价也最高:你以为封住的路径返回放行,或者反过来。
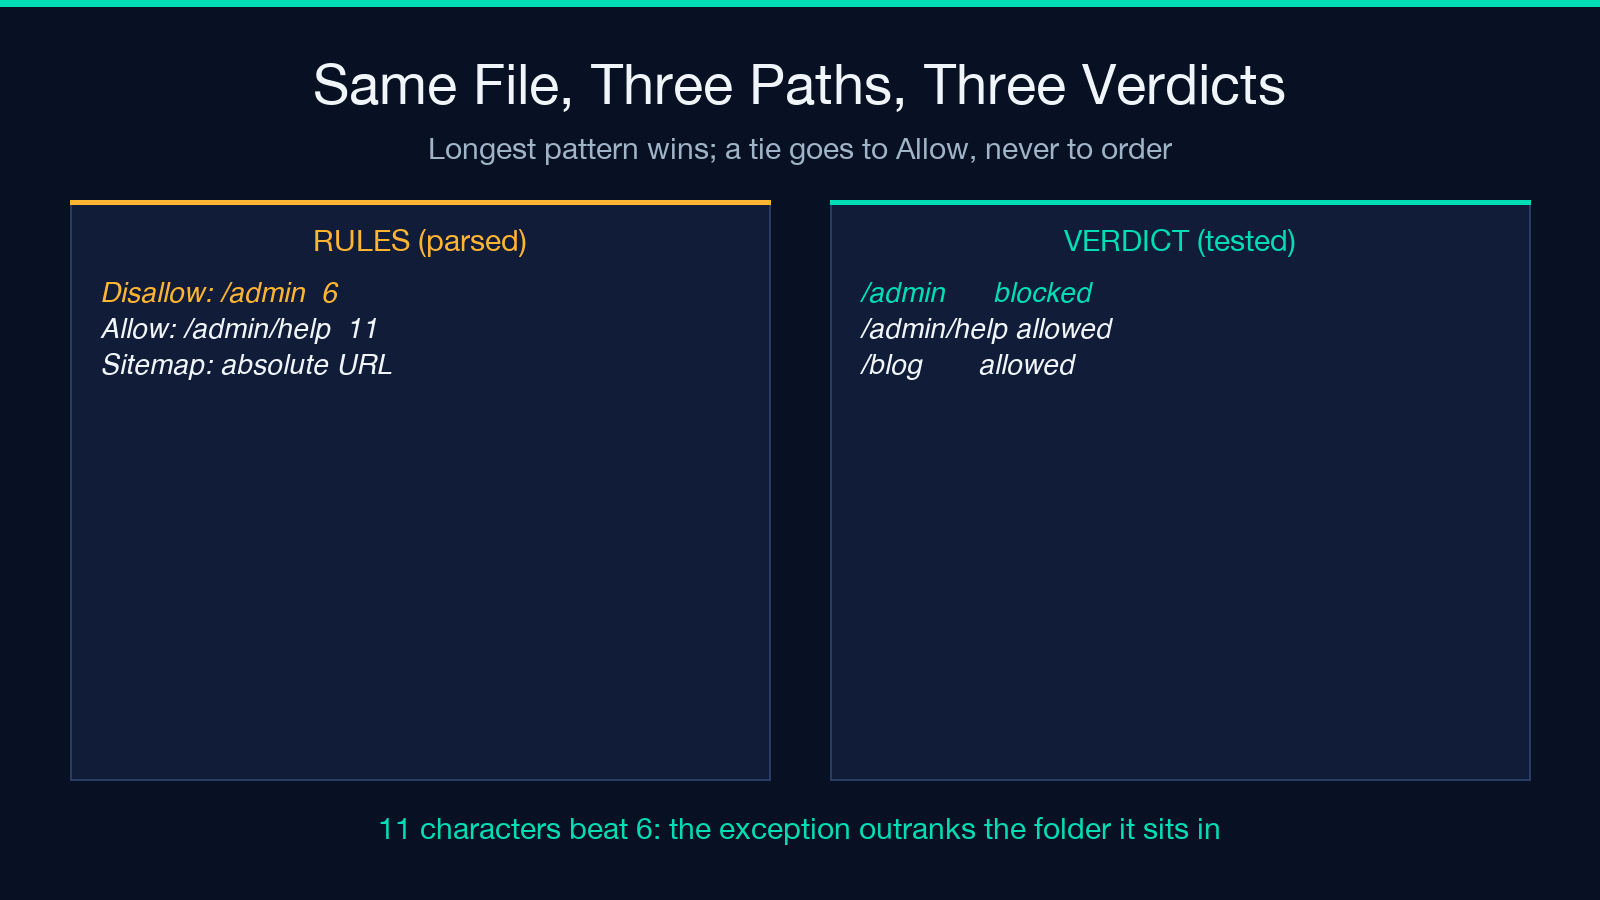
规则是机械的。凡是模式能命中该路径的 Allow 和 Disallow 都是候选。模式最长的那条胜出;两条一样长时,Allow 赢。就这些。没有「先命中者胜」,没有「后写的更具体」,也不存在顺序上的玄机。把例外挪到规则后面重写文件,结果一点不变。
下面这一对就完全按预期工作:
Disallow: /admin(6 个字符)Allow: /admin/help(11 个字符)
一次对 /admin/help 的请求同时命中两条。算术很干脆:11 个字符胜过 6 个,所以这条路径放行,帮助文档留在索引里,后台其余部分照旧挡在外面。把例外缩到 5 个字符,胜负立刻调转,长的那条 Disallow 赢。这两行的顺序互换,结果完全相同;有人坚称例外被忽略时,「把 Allow 往下挪」什么也修不好,原因就在这里。
空值这一种值得单说。Disallow: 后面不写值,一条路径都匹配不到,等于是重置:一份通篇都是 disallow 的文件,可以用一条光秃秃的 Disallow: 为某条路径重新开门。这不是审查器的推理出了错,语法本来就这样,每次都能让人愣一下。
通配符改写了规则,也改写了平局判定
只有两个字符被特殊对待,其余字符一律按字面处理。* 变成 .*,末尾的 $ 把路径结尾锚住,其他正则元字符(.pdf 里的点、方括号、圆括号)都会被转义,按自身匹配。
最后这点出现的频率比通配符还高。两条路径就能说明白:Disallow: /*.php$ 之下,/x.php 判为封禁,/x.phpx 判为放行,因为那个点是字面意义上的点,末尾的锚点不接受多出来的字符。Disallow: /report.pdf 命中 /report.pdf,不命中 /reportXpdf,同样因为点是字面点,不是任意字符。少了转义这一步的文件会封掉你根本没打算动的路径,而这个错误一直隐身,直到有人发现整个目录从索引里消失了。
真正容易推错的是通配符本身,这里的边界值得说清楚。具体性比较用的是规则模式的长度,而模式长度只在双方都是纯字面字符串时才等于匹配到的路径长度。一旦引入 *,两个量就会分开,像 /a*b 这样四个字符的模式可以匹配三个字符的路径。Google 的文档按匹配到的路径来讲具体性,机械检查却落在模式上。通配符规则和字面规则挨得很近时,别推了,直接拿确切 URL 去测。答案很便宜,你的直觉在这里不可靠。
URL 测试只看通配分组
有一件事关乎诚实,也改变了你怎么看测试结果。把 /pricing 贴进测试器,返回放行,这次检查是拿 User-agent: * 分组来评的。具名分组(Googlebot、Bingbot,或者某个合作方专用爬虫)不参与,因为测试器是以通配代理的身份发问的。
对多数站点而言,这问得对,大多数爬虫最终都落到通配分组。但如果你维护着一个具名分组,而它封禁了通配分组放行的某条路径,这就问错了。那时绿色的「放行」对一般爬虫成立,对你真正在意的那一个不成立。
实用的补法不是换更好的审查器,而是再做一次测试。某条路径若由具名分组管辖,就手动读那个分组的规则,确认判定一致。两分钟的事,补上的正是任何自动化摘要都不会替你标出的缺口。
上线前的四步检查
对这种没有报错通道的文件做审查,全部意义就在于把沉默变成一张清单。按顺序走完,这份文件就不再是猜测。
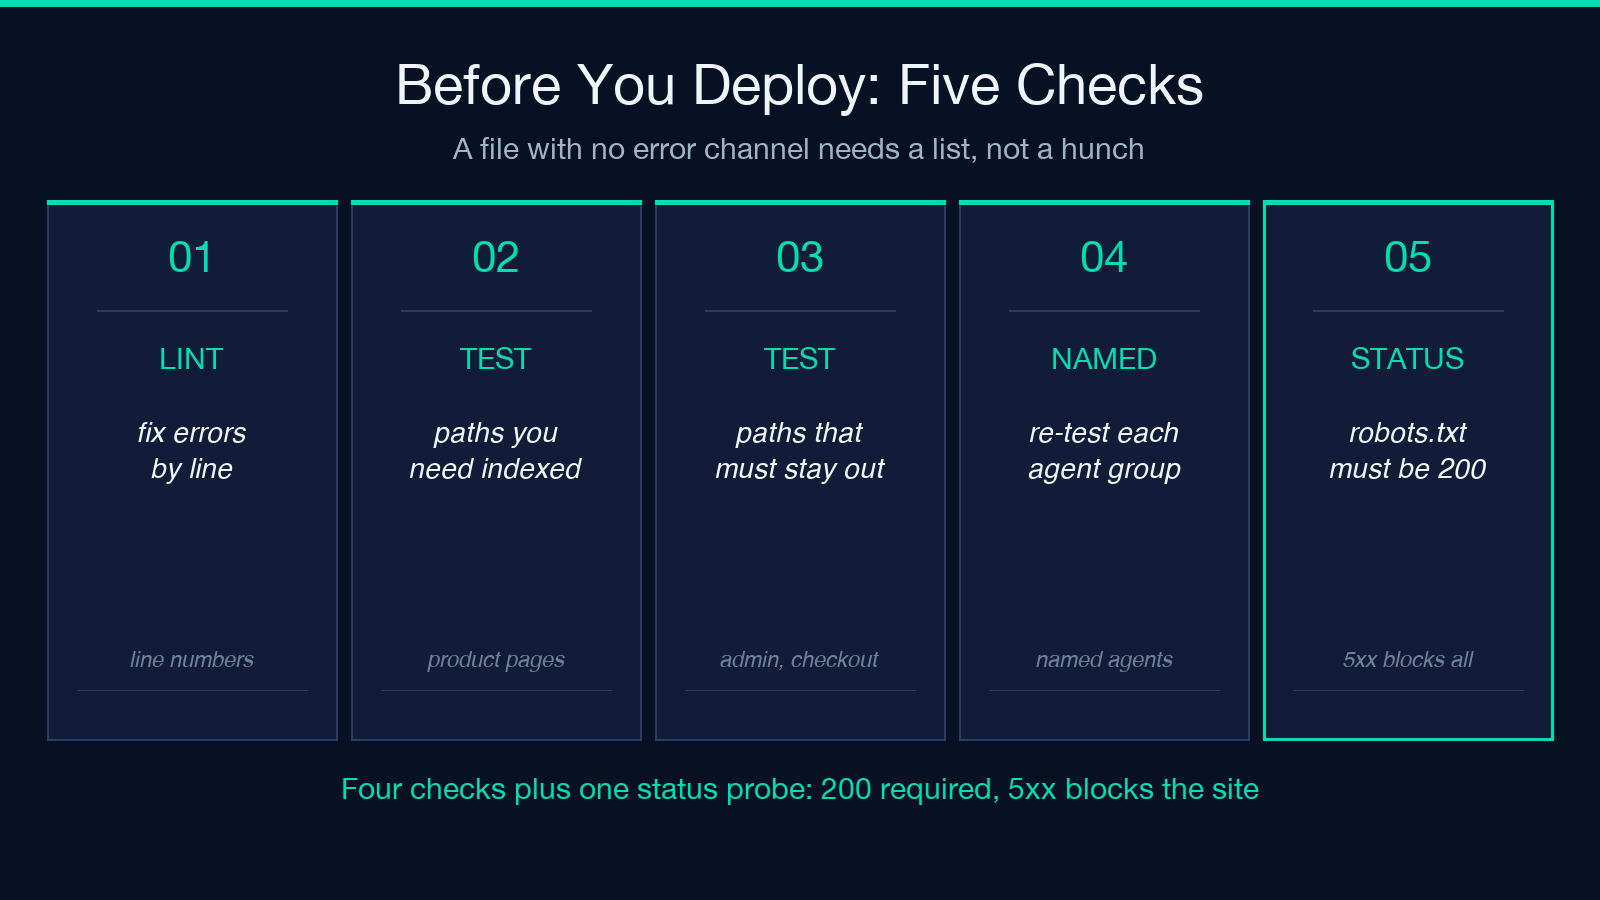
第一,先审草稿,把错误修掉,别的事都往后放。未知指令只是外观问题,缺一个冒号却是实打实的洞。按行号改,不要整篇重写;40 行的文件干干净净重写一遍,孤立规则就是这样又被引进来的。
第二,测那些丢不起的路径。产品页、价格页、文档根目录。这里误封就是直接烧钱的那类故障,也是三周后才以「我们从搜索结果里消失了」的形式报上来的故障。
第三,测那些必须挡在外面的路径。后台、结算、站内搜索结果页。挡了等于没挡,是这项工作的另一半,而且在有人从索引里翻出一条结算链接之前,一直看不出来。
第四,凡是由具名代理分组管辖的路径,手工确认判定。通配测试代表不了那个分组。
四步,一个文件,整套做下来比一次无声误封之后的事故复盘还短。做完之后,这份文件就从猜测变成了一张生效路径的清单。
这个审查器告诉不了你的事
静态检查读的是你贴进去的内容。它不去抓线上文件,所以抓不到这些情况:部署上去的是另一个版本;CDN 边缘节点在发缓存副本;服务器对 robots.txt 返回 503,对站内其他地址却返回 200。
最后一种比听起来更糟。主流爬虫把 robots.txt 的 5xx 响应当作临时全面封禁,这跟多数人「没有规则就随便抓」的假设正好相反。404 读作没有限制,500 则等于关站。确认你的 robots.txt 精确返回 200 只需要一条命令,偏偏没人去做这项检查。
还有两处局限值得点名。按 RFC 9309,爬虫只需要读文件的前 500 KiB,所以一份几万条 disallow 的生成巨物天生就是不完整的,这属于设计使然,不是意外。crawl-delay 之所以在已知指令集里,是因为语法给它留了位置,并不代表每个爬虫都认它,Google 公开无视它已经好多年了。
为了让这篇文章的每个说法都站得住,我照着工具的源码把解析器重新实现了一遍,每个案例都跑这个解析器,而不是看摘要面板。按那份源码,只有六个指令被识别,报告的计数也对得上;上面五个案例都复现了实测行为。这是对逻辑的检查,不是对你站点的检查。
最后,以上都不构成「会被遵守」的证明。robots.txt 是请求,不是强制手段。无视它的抓取器,无论你语法多完美都会无视,这正是关键路径上要做限流和鉴权的理由。
想在文件上线前审一遍草稿、测一测路径,可以用 Robots.txt 静态审查器;也可以从一份干净的草稿起步,用 Robots.txt生成器。更多工具见 elysiatools.com。
很多年里我把 robots.txt 当一行文件处理:封掉 /admin,加一行 sitemap,发上去。写这个审查器的过程改掉了这个习惯,因为值得关心的故障从来不在肉眼能看见的地方,它们藏在解析器悄悄丢掉的规则里,文件本身却一直看着没问题。上线前检查的真正理由就在这里:知道自己规则里哪几条被爬虫读到了,而不是为了应付检查器。今天你答不出自家站点的这个答案,那条 Disallow: 后面接着的,你以为是什么?

Pingback: A Broken Disallow Rule Fails Silently. Catch It Before a Crawler Does. - COSESAI