
存档文件从不说明自己是什么格式,只交代外面包了什么。我解压了一个 507 字节的 Minecraft 样本,得到 1,544 字节,膨胀 3.05 倍。同一个文件,查看器在头部给出的读数却是每字节 7.602 比特的熵(entropy),跟随机数据没什么两样;底下那层载荷只有 6.202。两个数字都成立,因为它们量的是不同的层,而你通常只关心其中一层。
开头几个字节命名的是最外层,不是格式
检查器只做一件事:递归地测。gzip 流以 1f 8b 开头;zlib 流以 78 开头,后接 01、5e、9c、da 之一;Palworld 存档在偏移 8 处带着 ASCII 的 PlZ1;SQLite 以十五个字节的 SQLite format 3 开头,偏移 15 的那个 NUL 故意留在比较范围之外;Unreal Engine 存档以 GVAS 开头;ZIP 归档以 PK 开头,后接 03、05 或 07;NBT 以单字节 0x0a 开头,后面跟一个大端序的名字长度,最大 512,且必须落在文件之内。
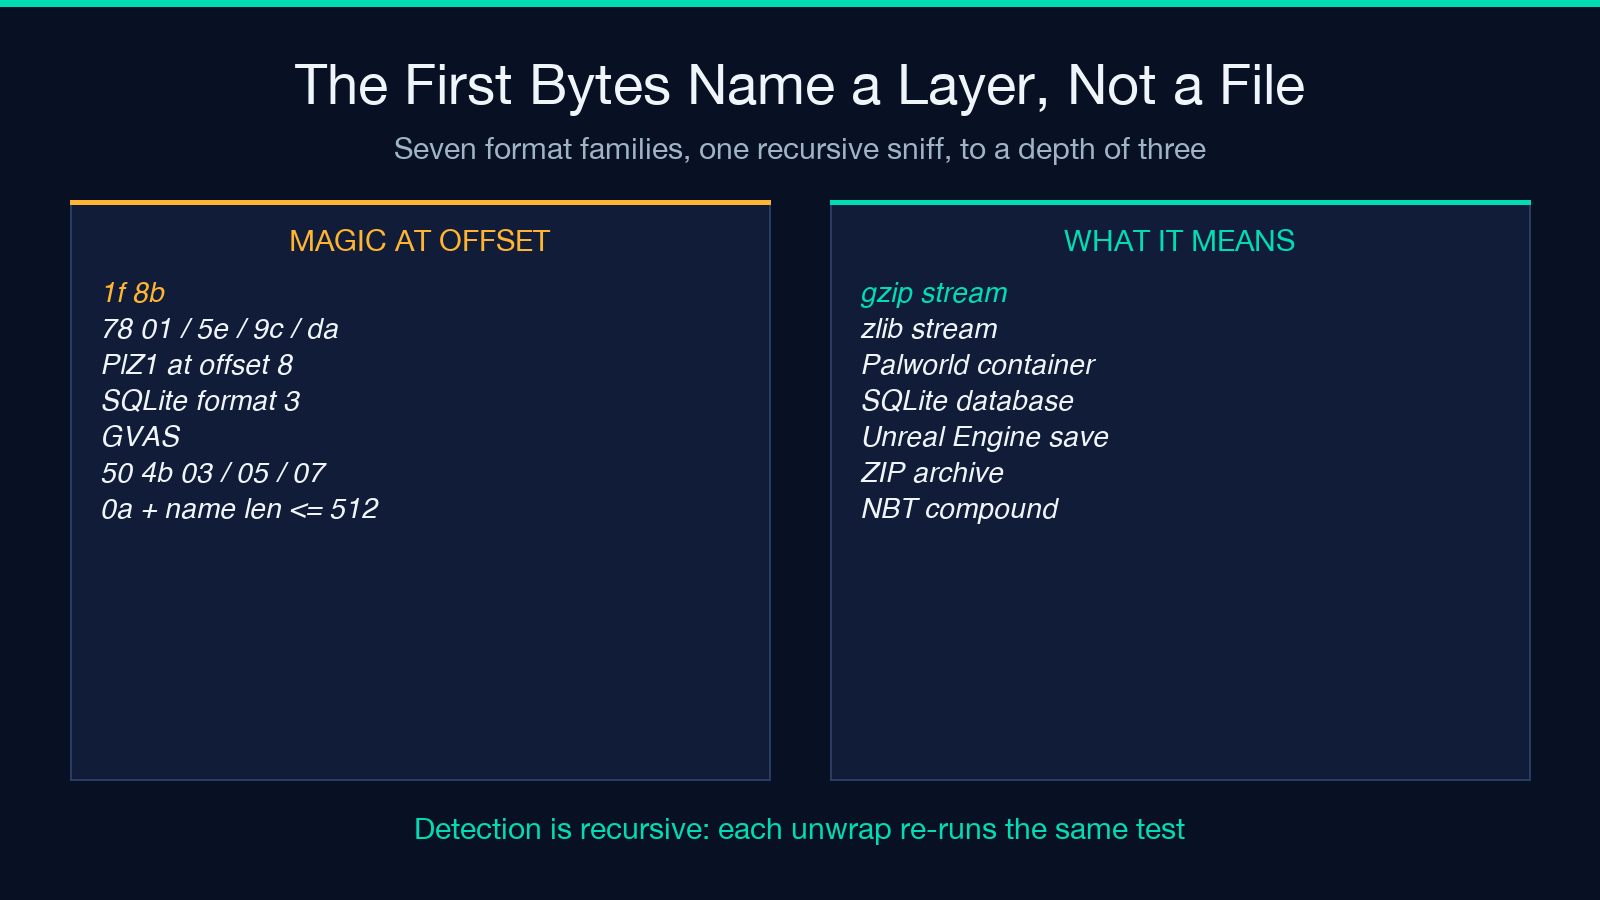
哪个测试先命中,就用掉这块缓冲区,然后对解压后的结果再调一次同一个函数,最多递归三层。
Palworld 是最清楚的例子,两种格式确实叠在一起。公开样本 3,669 字节:两个小端序 int32(7,847 和 3,657),接着是偏移 8 处的 PlZ1,然后一条 zlib 流。把这条流 inflate 开,载荷头四个字节读出来是 GVAS。第一个 int32 既不是校验和,也不是 magic guard,7,847 正好就是解压后的长度。容器在报出自己是什么类型之前,先报出了自己有多大;报告于是给同一个文件贴了两个都正确的名字:容器是 Palworld PlZ1 + zlib,格式是 Unreal Engine GVAS save。
文件扩展名在这里不起作用。样本集里有三个文件共用 .sav 扩展名,装的却是两个不同的格式家族:2 个 GVAS 存档,1 个 Palworld 容器。如果你要先按实际内容认出一个文件再交给解析器,那是另一件事。文件类型检测器(魔数)读的是同一层 magic number,但完全不尝试解码。
NBT 从头数,GVAS 从尾数
两种格式都是自描述二进制,各有一个根标签和一个版本字段,分歧只在于多字节整数从哪一头算起。
以 Minecraft 样本为例:第一个字节是 0x0a,也就是 TAG_Compound;第 1、2 个字节是 00 05,按大端序读出来是 5,后面五个字节拼出 Level。NBT 的每个整数都照这个规矩来,读取器全程调用 16 位、32 位、64 位的大端序访问器。
Unreal 样本的开头是 GVAS 02 00 00 00 0a 02 00 00。按小端序读,这两个字段是存档版本 2 和包版本 522;把同样的八个字节按大端序读,得到 33,554,432 和 167,903,232。两个都是说得通的整数,都不会抛异常。可其中一个描述的是 Unreal Engine 4.27,另一个什么都没描述。
头部还会自己改长度。存档版本等于 3 时,解析器会多读一个 64 位的包版本,其后每个字段都往后挪八个字节。这个样本存的是版本 2,带三个 custom version,头部在第 109 字节处结束,全文 2,503 字节,剩下 2,394 字节属性数据,而一个固定偏移的读取器会从提前八个字节的位置开始读。这个切分在每个文件上都能量出来:头部 109 字节,载荷数据 2,394 字节。
固定偏移的读取器把整个头部压缩成一个关于版本号的猜测。在这个领域,字节序不是全局常量,它由每个格式家族各自决定;那个告诉你 magic number 的规范,并不会告诉你字节序。
存档文件无法 seek,只能一步步走
NBT 没有索引。列表只带一个元素类型字节和一个计数,然后元素一个接一个排下去;字符串是两字节长度加对应数量的 UTF-8 字节;字节数组是四字节计数加裸字节;compound 是一串 tag、name、payload 记录,最后以一个零字节收尾。这些记录没有一个会存自己的总字节长度。
于是第 N 项的位置取决于第 0 到第 N-1 项各自有多大。你没法直接跳到列表的第五十项,只能把前面四十九项走一遍。
检查器先建五个节点做预览,剩下的交给一个专门的 skip walker。这个 walker 之所以存在,就是因为缺索引。它源码里的注释把意图写得很直白:“Skip remaining list items without building nodes.”(跳过剩余列表项,不建节点。)可它仍得一项一项读过去,一跨一跨地走,才能落到正确的字节。函数上方的注释更不客气,一句话说完全部问题:“Arrays and strings have variable length; compounds and nested lists need a structural walk.”(数组和字符串长度可变;compound 和嵌套列表必须做结构化遍历。)这个 walker 为每种 tag 带了一个步长:byte tag 一步 1 字节,long 一步 8 字节,数组是计数加对应字节数,字符串是长度前缀。它会递归进嵌套列表和 compound,保证读取位置不作假。你看到的那棵树只是预览,解析器最终落到的偏移才是整个文件。
粗糙的存档编辑器就是这么把存档写坏的。它们按某个版本的 schema 算出偏移,然后直接往那里写。格式不提供任何索引来核对这个猜测,写入便落在一个看起来合理的位置上,读档就此失败。
entropy 量的是外壳,不是载荷
报告在构造时就把 entropy 字段填好了,用的是原始缓冲区,这一步发生在解压递归之前,之后没有任何地方重算它。所以只要存档外面包了一层,你看到的那个数字描述的就是压缩器。
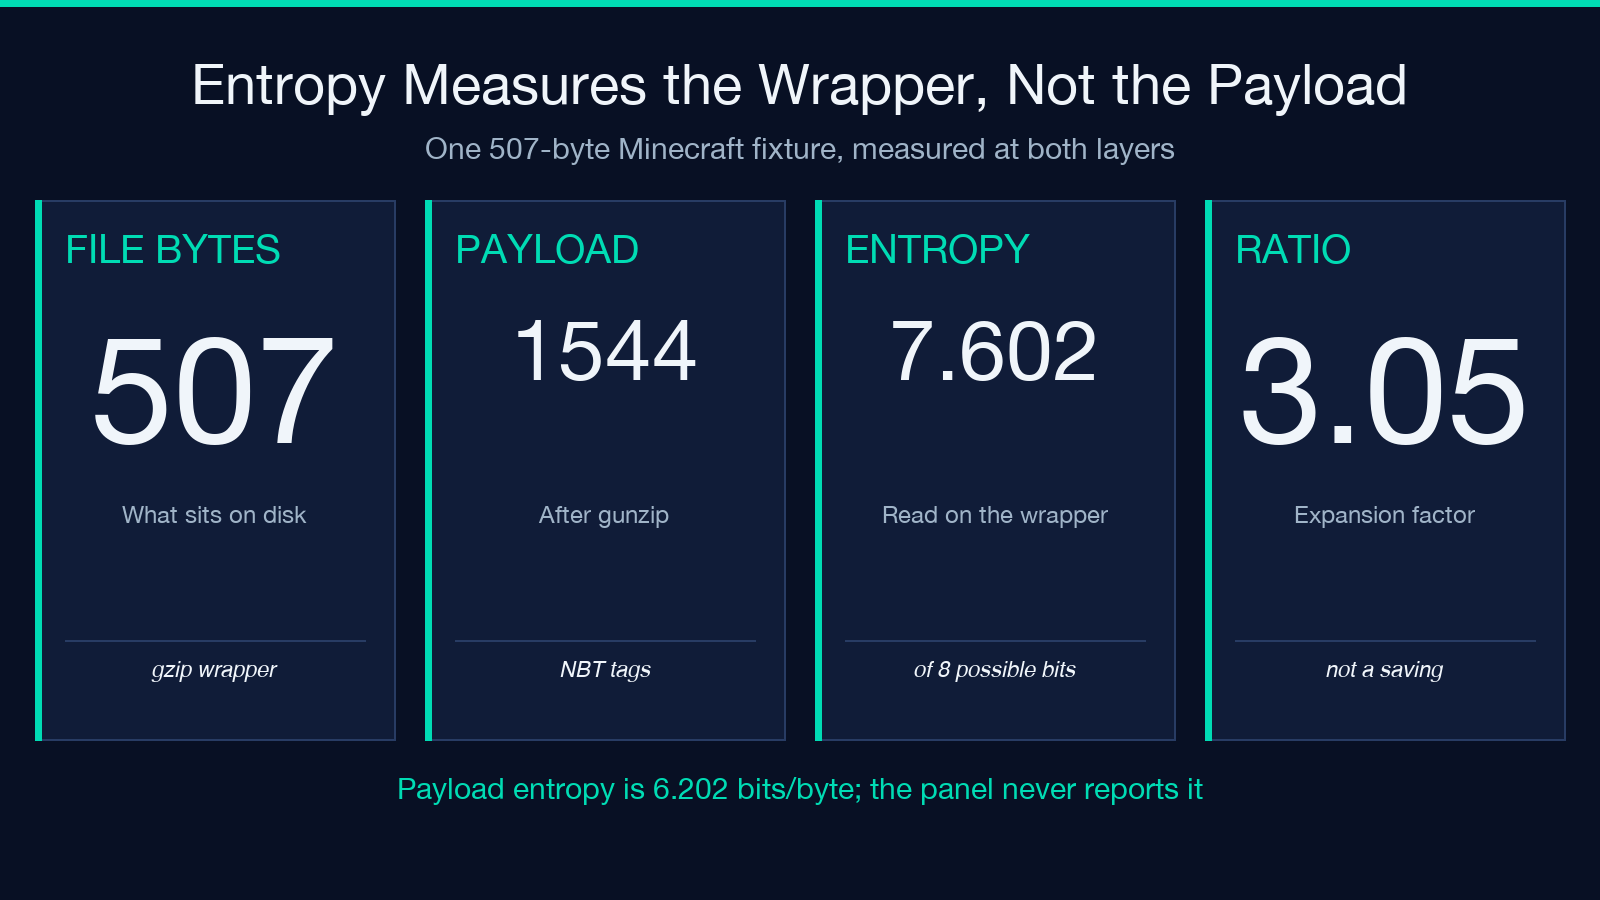
同一个文件两种量法:包着量,每字节 7.602 比特;拆开量,6.202。两个读数都对。包着量出来的值贴着天花板,8 比特里占了 7.602,因为 deflate 的输出本来就是这个样子:接近均匀、接近随机,什么信息也不给。如果你把 entropy 当作“这东西是压缩的还是加密的”的判据,它会回答“是”,而这个“是”你从上面那两个 1f 8b 字节就已经知道了。
entropy 只在一个地方真正有用:兜底。当没有任何 magic number 命中、也没有外壳可量的时候,一个高读数加上一份空的可打印字符串扫描,才算一个真答案:文件被打包或被加密了,再怎么渲染树也没用。如果你想让这项测量按自己的口径来,熵计算器量的是你选的缓冲区,而不是工具替你选的外壳。
解析停下的地方,不是渲染停下的地方
树的形状由两个互不相关的上限决定,而它们并不相等。
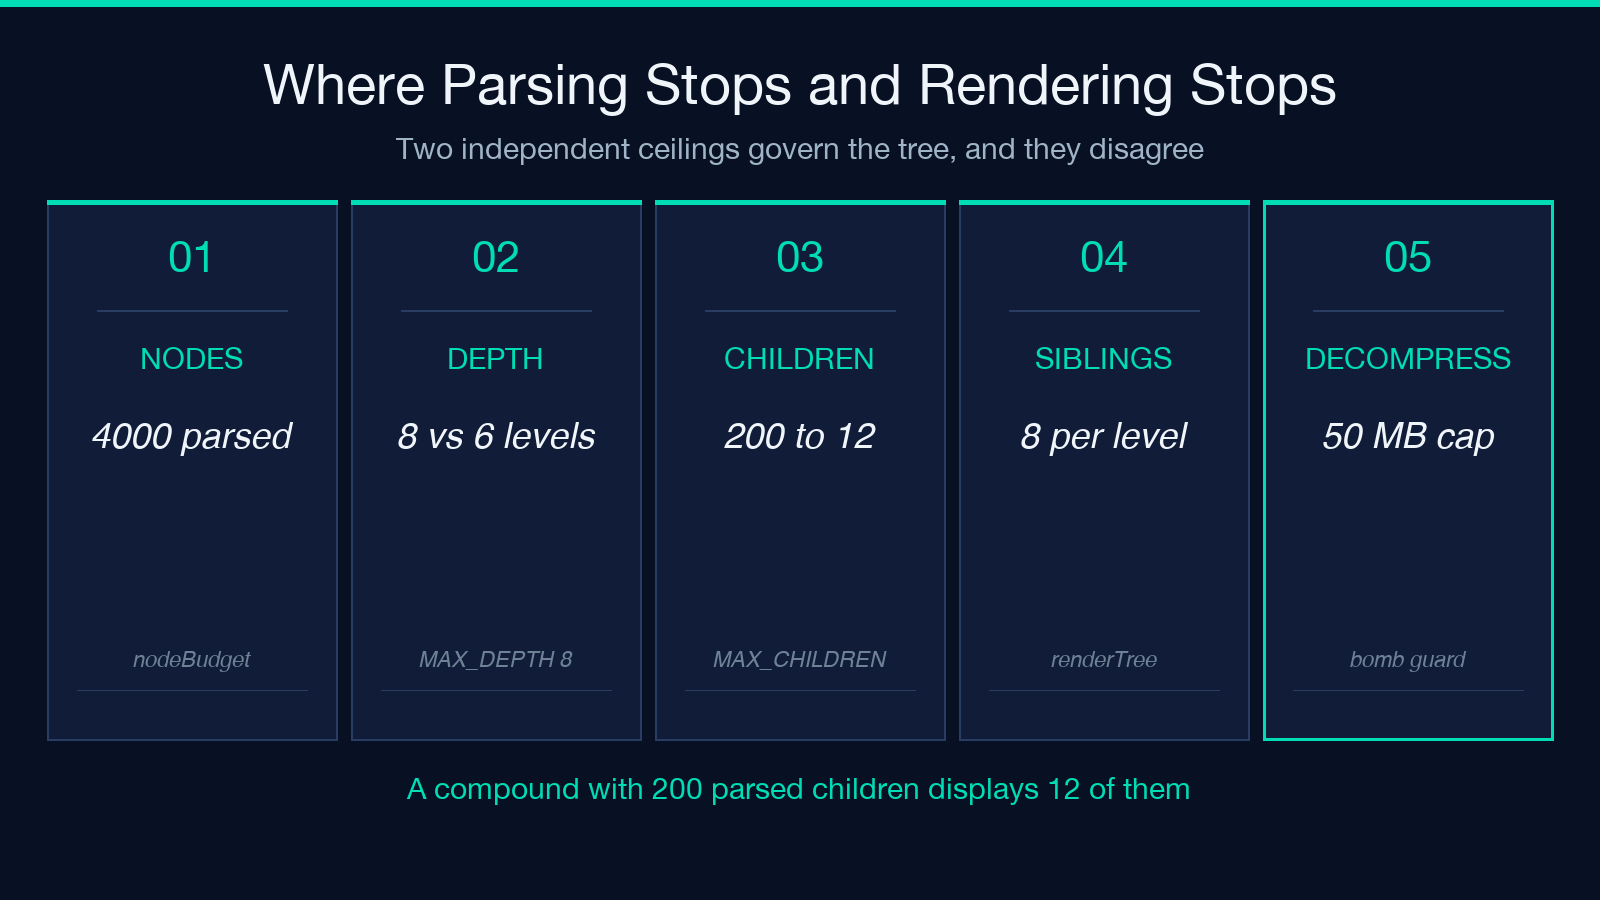
解析最多允许 4,000 个节点,深度上限 8,每个 compound 最多 200 个子节点,还有一个 50 兆字节的解压上限,把解压炸弹的风险彻底掐掉。渲染是另一回事:顶层 12 个兄弟节点,其下 8 个,深度 6 硬停。渲染对这些额度一概不认,树渲染器在深度 6 以下什么都不返回,顶层打印十二个兄弟节点,往下一层各打印八个,每藏起一批子节点就补一行灰字“… N more siblings”。
于是一个解析出 200 个子节点的 compound,只显示其中十二个。问题就在这个比例上:解析 200,渲染 12,剩下 188 个由一行灰字兜着。面板上的节点数是已经建出来的节点数,也就是解析数,不是显示数。被藏起来的兄弟节点全部塌缩成一行,并不是“解析了多少、留下多少”的对照。
这让一句常见的抱怨变得含糊。“树里没有我要的字段”可能指这个字段在深度 6 以下,也可能指它排在第十二个兄弟之后,还可能指它超出了节点预算。三种诊断,修法各不相同,而报告并不区分它们。
关键字段面板是一个有偏心的正则
这个面板不做 schema 解析,它只做一次不区分大小写的子串匹配,对着十八个 token 跑:name、player、level、xp、exp、gold、money、coin、health、hp、seed、version、time、slot、act、floor、score、save,命中二十个就停。
不做锚定的子串匹配是有后果的。name 会命中 displayName、worldName、nameTag,以及任何名字里带 name 的属性,一个 token 换来三个近似命中,20 个名额里白白用掉 3 个。time 会命中 lifetime、runtime、timeStamp,我在同一个 Unreal 头部里三个都见到了。收集按文档顺序跑、到二十就停,所以一个存档只要前二十个命中的键都属于 name 这一家,面板还没走到 gold 就满了。你要的字段不在,原因不是解析失败,而是配额按文件写入的顺序用光了。
这个顺序行为我可以从源码里核实,也的确核了。我没有做的是在真实存档上量一个误报率:手上只有七个样本,而且大多数是挑过的,所以我报出的任何比率描述的都会是我的样本,不是你的存档。把这个正则当成无序的、基于子串的就好,也就是说,面板的准确率取决于你存档里键的名字,而不是工具的性质。
这份报告对四件事诚实,对两件事沉默
读数在四处把话说得很清楚:
检查器从不写入。SQLite 那条路径打开时设了只读选项,检查器里没有任何代码路径会改动缓冲区。工具在内存里读一份副本,然后渲染。
指纹是截断的,而且你看得见。SHA-256 被截成十六个十六进制字符,也就是 64 位,打印时带一个省略号。那是用来认出“同一个文件出现过两次”的身份标签,不是完整性校验;截断是明摆着的,没有藏在 digest 这个词后面。
比率是膨胀,不是节省。这个字段拿解压后长度除以文件长度,界面把结果渲染成“3.05× compressed”。载荷是文件的 3.05 倍,文件并没有被压到三分之一。
兜底仍然给出证据。任何认不出来的东西都会拿到前 256 字节的十六进制转储和一次可打印字符串扫描,最坏的情况是你还能看见字节,而不是一个耸肩。
有两处,检查器保持沉默:
NBT 的嗅探很浅。它只拿一个字节去比 0x0a,再看后面两个字节是不是一个说得通的名字长度。一个以换行符开头、偏移 1 和 2 上又是小数值的二进制文件就能通过嗅探,然后在真正的解析器里抛异常。这就是为什么某一行警告会写着“NBT parse failed”,而那个文件的格式标签从来没说它是 NBT。
SQLite 的树是第二趟才来的。同步的检查器只能给出格式标签,因为数据库句柄需要一个磁盘上的真实路径。表树由异步的后续步骤填上。这个步骤失败时,标签仍然写着“SQLite database”,还带着文件大小和一个哈希,底下却是一棵空树:一个正确的标签,压在一个空答案上面。
还有第三处沉默,能演示而不是推断出来,也是唯一一处工具自己的文档写错的地方。Minecraft 测试样本的文档说它覆盖全部十二种 NBT tag 类型。我自己把这个样本走了一遍,数出十种:byte、short、int、long、float、double、byte array、string、list、compound。TAG_Int_Array 和 TAG_Long_Array 从头到尾没出现过。解析器十二种都处理,这个文件并没有覆盖十二种。文件证明文档是错的,而正确的一方是文件。“支持”和“证明”之间的那道缝,是格式报告里最安静的一类错误;我唯一发现它的办法,是换一门语言把文件再解一遍。
先读警告面板,再看树
warnings 数组是检查器唯一承认自己不确定的地方,有五个渠道往里写条目:NBT 载荷之后剩下的尾随字节、解不开的 gzip 流、比容纳它的文件还长的 custom-version 表、抛出异常的 NBT 解析,以及失败的 SQLite 读取。五个渠道报的都是报告其余部分报不出来的东西。
于是读的顺序有点反直觉。树是让人满足的那部分:可折叠、带颜色、一看就是答案。警告面板只是底部两行琥珀色小字。可树渲染的只是解析器勉强框住的那部分,警告面板才是唯一报告解析器放弃了什么的地方。
这些样本的完整读数在游戏存档查看器,生成报告不产生任何费用,因为执行时没有任何东西被上传,缓冲区就地解析、就地渲染。更多工具见 elysiatools.com。
我写这篇文章时以为格式才是有趣的问题,其实不是。格式只是存档文件主动交代的一件事,其余全靠走。它藏着的是层数,以及解析器和渲染器各自同意丢掉多少结构。所以打开一个已经读不出来的存档时,先读警告面板:它唯一承认“哪儿放不下”,也唯一告诉你“你要的答案到底在不在文件里”。

Pingback: Your Save File Is a Wrapper, Not a Format: NBT vs GVAS - COSESAI